


导语:ApxInf 宣称自己是"边缘推理引擎的新物种"——Rust 实现、零外部依赖、π0.5 VLA 模型在 RTX 4090 上跑出 31.38ms。但这些数字都是在桌面显卡上测的。推理引擎真正的战场是机器人控制器——所以我们把它搬上了一台 H700 Max 具身智能控制器(639 TOPS 旗舰配置),从源码构建开始,完整跑了它的基准测试和 LIBERO 500 集机器人任务评测。
结论先行:性能宣称基本属实,精度宣称属实,而且在这台真实的机器人"大脑"上,π0.5 能以 91% 的任务成功率、~107ms 的推理延迟稳定工作——但发现了一个官方未覆盖配置下的 NaN bug。
一、为什么是 H700 Max?为什么测它?
具身智能的落地链条上,推理引擎是离机器人最近的一环:VLA(视觉-语言-动作)模型的每一步动作生成,都发生在机器人身上的控制器里。PyTorch 跑 π0.5 动辄 500ms+ 一步,而 ApxInf 宣称用纯 Rust + 自研 CUDA kernel 把它压到 31ms。
"宣传得很好"的引擎我们见过太多。这次的测试原则:
-
全部从源码开始——自己拉代码、自己编译,不碰任何预构建产物 -
用真实模型——下载官方 π0.5 LIBERO 微调 checkpoint(14.5GB),逐文件校验哈希 -
跑官方协议——LIBERO-10 完整 500 集评测,seed 7,和论文对齐 -
不放过问题——测出 bug 就写出来
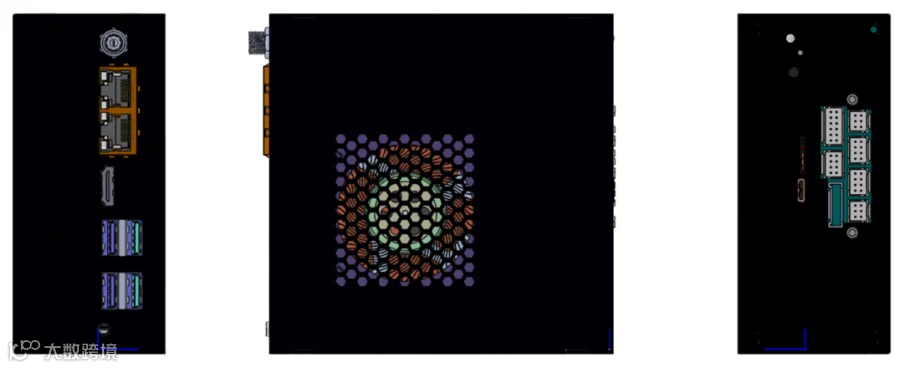
测试平台不是工作站,而是一台真正的机器人控制器:H700 Max(麦思伟科技 MxWill),面向人形机器人、四足机器人的旗舰级异构计算模组,"大脑(AI 推理)+ 小脑(运动控制)"一体化设计,整机只有 119×120×53mm。
二、测试平台:H700 Max 具身智能控制器
【图1:shot-01-nvidia-smi.png】H700 Max 的 RTX 4090M MXM 模组(nvidia-smi)
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
RTX 4090M MXM 模组
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
注意:H700 Max 的 RTX 4090M 是 MXM 移动模组(76 SM / 16GB / 576GB/s),不是桌面版 4090(128 SM / 24GB)。
官方数据来自桌面卡,理论上吞吐约为其 50-60%,后面的对比都会按此折算——这种折算本身,就是"边缘控制器 vs 数据中心卡"的真实差距。
三、构建:一场 13.5 小时的马拉松
按官方文档走 maturin build --features cuda,build.rs 自动检测 MXM 模组架构(sm_89)并只编译对应 kernel。然后就是漫长的等待:
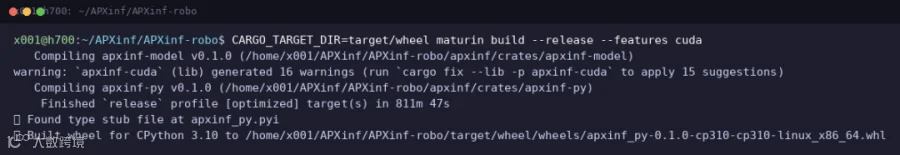
【图2:】构建完成:811m47s
13.5 小时的构成很有意思:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
我们抓了现场:这个 split-KV kernel 的中间码 PTX 有 894MB(普通 kernel 只有几 MB),ptxas 寄存器分配进入超线性耗时区,单核满负荷跑了 6 个半小时。根因是引擎的 build.rs 对 16 个 kernel 串行调用 nvcc。如果并行编译,全量构建能从 13.5 小时压到 2 小时以内——这是给上游的第一个改进建议。
四、基准测试:宣称数字是真的吗
先跑测试套件热个身:
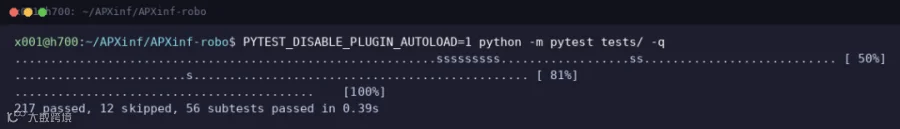
【图3】217 项测试全部通过
然后是重头戏——用真实 checkpoint 在 H700 Max 上跑 L1 层延迟(2 视角 224×224、H=10、10 flow steps、CUDA Graph 稳态 P50):
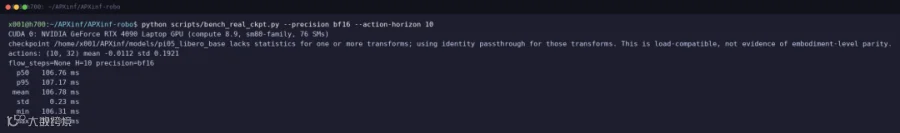
【图4】BF16 全流程:106.76ms

【图5】BF16 onestep(1 步 flow):76.55ms
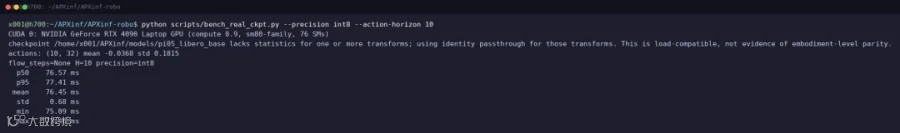
【图6】INT8:76.57ms
和官方宣称对比:
|
|
|
|
|
|
|---|---|---|---|---|
|
|
106.8 ms |
|
|
|
|
|
76.6 ms |
|
|
|
|
|
76.6 ms |
|
|
|
三个配置的比值高度一致(2.9-3.4x),与 76/128 SM 的硬件差距吻合。额外差距来自本机被迫禁用了 split-KV 注意力加速路径(原因见第六节)。结论:官方延迟数字内部自洽、随硬件线性扩展,是可信的。
对具身部署的意义:~107ms 一步意味着 10Hz 级的动作重规划频率——对大多数操作任务(LIBERO 协议按 5 步重规划一次)绰绰有余。INT8 模式只需 76.6ms 且显存占用减半,是 16GB 显存控制器上的甜点配置。
分层开销也很干净:L2(Python policy 层)只加 0.9ms,L3(OpenPI WebSocket 全链路往返)传输开销仅 1.1ms:
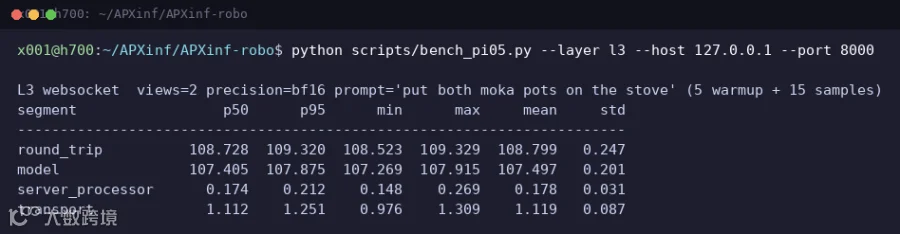
【图7】OpenPI 兼容服务全链路:round-trip 108.7ms
五、LIBERO-10:500 集机器人任务评测
延迟只是手段,任务成功率才是目的。按官方协议跑完整评测:10 个任务 × 50 集 = 500 集,H=10,replan=5,seed 7,仿真环境与推理引擎跑在同一台 H700 Max 上。
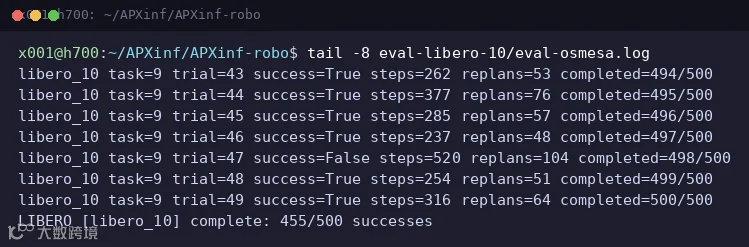
【图8】评测长跑日志(500 集逐集推进)
最终成绩单:
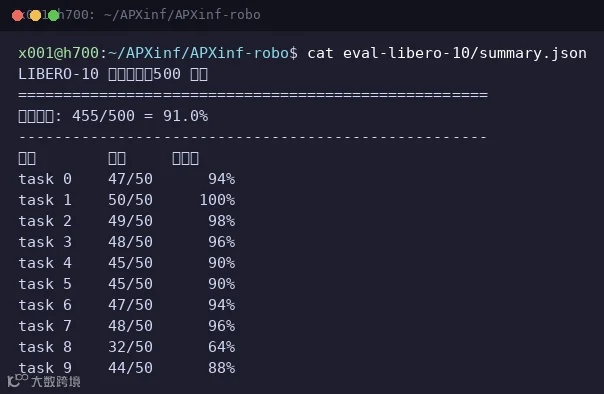
【图9】500 集最终汇总:455/500 = 91.0%
|
|
|
|---|---|
|
|
|
|
|
|
| H700 Max 实测(4090M) | 91.0% |
分任务看,9 个任务在 88-100%,只有"把两个摩卡壶都放上炉子"(双臂协调任务)只有 64%——这个任务在 LIBERO 评测中历来方差最大。
注意:我们的 91.0% 是在两个不利条件下测的——split-KV 被禁用(bug 绕过)+ eager 模式(16GB 显存装不下官方同款 CUDA graph)。即便如此也只差官方数字 1.8 个百分点,落在评测正常波动内。精度宣称属实。
六、发现的 bug:split-KV kernel 在 sm_89 上输出 NaN
这是本次测试最有价值的发现。默认配置下,随机权重和真实 checkpoint 都稳定输出 NaN:
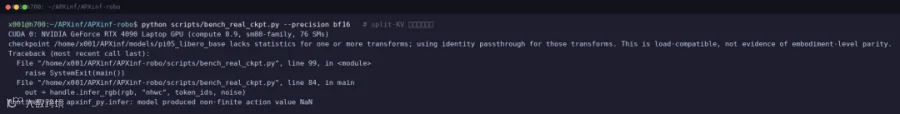
【图10】默认配置下模型输出 non-finite NaN
排查过程:
-
随机权重 → NaN,怀疑权重溢出,换真实 checkpoint → 依然 NaN -
定位到触发条件:MQA 注意力(query ≤ 64 token + key tokens 400+)命中 split-KV 快速路径 -
设置环境变量 APXINF_DISABLE_FA2_SPLITKV=1绕过 → 一切正常,数值合理 -
推测:split 因子按 SM 数(76)计算时存在边缘情形——官方只在 128 SM 桌面卡和 Jetson(sm_87/sm_101/sm_110)上验证过,MXM 模组的 sm_89 是个盲区
给同款设备用户的建议:在官方修复前,跑 ApxInf 记得带上 APXINF_DISABLE_FA2_SPLITKV=1。这个 bug 我们已整理好复现条件,准备反馈给上游。
另外 16GB 显存有三个容量注意点:10 步 CUDA graph 捕获 OOM、长跑评测需切 MUJOCO_GL=osmesa(CPU 渲染)、parity 测试需双模型驻留跑不了。桌面 24GB 无这些问题——对 16GB MXM 模组这一档的控制器,官方还有适配工作要做。
七、总结
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
一句话:ApxInf 的宣传没有水分——在 H700 Max 这台真实的具身控制器上,π0.5 以 91% 的任务成功率和 ~107ms 的推理延迟稳定跑通了 500 集评测,这个组合对机器人整机部署是成立的;但引擎对 MXM 移动模组这一档硬件还存在一个真实 bug 和若干 16GB 显存适配问题。
完整数据(500 集明细、哈希记录、复现命令)见我们的验证报告,欢迎复现与指正。
参考资料
开源项目
-
ApxInf 推理引擎(Rust/CUDA):https://github.com/infinigence/ApxInf -
APXinf-robo(本文测试的机器人适配层):https://github.com/RLinf/APXinf-robo -
LIBERO 机器人操作基准:https://github.com/Lifelong-Robot-Learning/LIBERO -
OpenPI(π0.5 官方 PyTorch 实现):https://github.com/Physical-Intelligence/openpi
模型与数据
-
π0.5 论文(Physical Intelligence):https://arxiv.org/abs/2507.16366 -
测试用 checkpoint lerobot/pi05_libero_base:https://huggingface.co/lerobot/pi05_libero_base -
checkpoint 国内镜像(ModelScope):https://modelscope.cn/models/lerobot/pi05_libero_base -
LIBERO 官方演示数据集:https://huggingface.co/datasets/yifengzhu-hf/LIBERO-datasets -
归一化统计(复现评测必需):https://storage.googleapis.com/openpi-assets/checkpoints/pi05_libero/assets/physical-intelligence/libero/norm_stats.json -
PaliGemma tokenizer(复现必需):https://storage.googleapis.com/big_vision/paligemma_tokenizer.model
关注 芯动力AI,我们会继续分享 大模型、Agent 和具身智能等方面的相关信息。