

1. 荒野求索:从 Docker 基因到 Ollama 的诞生
在生成式 AI 爆发的浪潮中,Ollama 几乎成为了开发者在本地与云端运行开源大模型的代名词。然而,鲜有人知这个拥有超 900 万开发者用户、17.8 万 GitHub Stars 且被 85%“财富 500 强”企业深度使用的现象级工具,其诞生过程充满了一段长达数年的“荒野求索”。
Ollama 联合创始人兼 CEO Jeffrey Morgan 与其伙伴 Michael 曾是 Docker Desktop 的核心构建者。他们在 Docker 深耕多年,积累了扎实的容器化、系统级基础设施及极致开发者体验(DX)的工程功底。2021 年初,他们凭借极强的技术实力进入 Y Combinator(YC W21 期)。

起初,他们的创业方向并非 Ollama。正如 YC 合伙人 Jared Friedman 回忆,项目初衷更像是"Kubernetes 版的 Docker Desktop",主攻单点登录与容器安全。甚至在 2022 年,凭借过往辉煌战绩,他们在产品形态未定时便拿到了 Benchmark 知名投资人 Peter Fenton 的 A 轮融资。彼时,DALL-E 刚露头,ChatGPT 尚未问世。
随后两年多,团队带着十多名顶尖工程师在焦虑中摸索。他们尝试过 Kubernetes 基础设施安全及桌面端开发者安全工具,但始终觉得“未真正击中痛点”。
直到 2023 年 7 月,Meta 发布 Llama 1 与 Llama 2。Jeffrey 团队在尝试本地运行这些开源模型时,遭遇了繁琐的环境配置、依赖冲突与硬件适配难题。那一刻,构建 Docker Desktop 的直觉再次爆发:“在本地和私有环境中部署大模型,就是大模型时代的‘容器化’难题!”
团队迅速转向推出 Ollama。Jeffrey 澄清,"Ollama"中的"O"代表 Open Models(开源/开放模型),"Llama"是对开放模型浪潮的致敬,并配以草羊驼作为吉祥物。这一转折不仅解开了困顿两年的难题,更让他们一头扎进了 AI 算力经济学剧变的中心。
2. 算力经济学翻盘:80/20 定律与企业控制权的终局
大模型演进前半场,行业普遍假设顶尖闭源实验室会不断推出“神级模型”,企业只需接入 API 即可。然而,随着生产环境调用量指数级攀升,昂贵且不透明的 API 账单给财务和工程团队带来了极大痛苦。
Jeffrey Morgan 指出企业在大模型选型上的核心痛点:“成本是开源模型入局的最直接痛点;但企业的终极北极星目标,是对 AI 的彻底控制权及针对业务场景的深度定制化。”
企业算力分配的 80/20 定律
根据 Ollama 在全球企业客户及云端 Token 流水中的观测,企业在算力预算与 Token 消耗上正快速演化出清晰的 80/20 规律:
- 80% 至 90% 的 Token 消耗总量
:由企业自建或私有化托管的开源模型承担。这些模型执行日常流水线任务,因单位推理成本极低(甚至降至闭源 API 的几十分之一),其实际算力预算仅占企业的 10% 至 20%。 - 10% 至 20% 的极高难度推理任务
:留给最顶尖的闭源前沿实验室 API(如 GPT-4o、Claude 3.5 Sonnet)。这部分少量但关键的调用,占据了企业剩余 80% 至 90% 的 AI 预算。
企业 Token 消耗与预算对比: [Token 消耗量] ████████████████████ (80%-90% 开源模型) ██ (10%-20% 闭源前沿 API) [算力预算支出] ██ (10%-20% 开源模型成本) ████████████████████ (80%-90% 闭源 API)“合伙人与初级律师”的组织隐喻
YC 合伙人 Jared Friedman 将这种混合架构比喻为顶级律所的分工:
在大型律所中,资深合伙人时薪极高,不会亲自撰写基础法条索引或合规初稿;其核心工作是理解复杂案情、拆解任务并做最终把关。大量的材料检索、信息提炼和初稿撰写,交由大量时薪较低的初级律师完成。
在现代 AI 工作流中,最聪明的闭源前沿模型是“律所合伙人”,负责任务路由与复杂逻辑拆解;而遍布全公司的开源模型(如 DeepSeek Flash、GLM、Qwen 等)则是高效运转的“初级律师”,高吞吐、低成本地执行代码生成、文档解析等批量工作。
真实案例:AT&T 与芬兰国家电网
这种算力经济学的转移正在发生:
- 电信巨头 AT&T
:《The Information》报道显示,AT&T 已短时间内将其全公司 40% 的 Token 消费流量平滑迁移至开源模型。初期采用美欧开源模型,目前正全面评估中国开源模型的性价比与适用性。 - 芬兰国家电网
:芬兰国家级电力机构将基于开源框架微调的大模型部署在关键基础设施本地,用于实时分析高频电力数据、精准预测并检测“电涌”风险。对于要求零离线风险、极低延迟、数据绝对不出境的生命线工程,闭源 API 在合规与稳定性上无法满足要求。
3. 指数级增长的数据真相:从 128k 上下文到 150 倍 Token 井喷
作为底层 Token 流量枢纽,Ollama 拥有洞察行业趋势的绝佳视角。Jeffrey 展示了 Ollama Cloud 上“按模型家族划分的开发者周均 Token 使用量”图表,揭示了 2024 年至今的两次爆发式拐点。
Ollama Cloud 开发者周均 Token 使用量演进趋势: Token 消耗量 ▲ │ /── OpenClaw & Agent 爆发 (150x 增长) │ / (上下文破 1M+,非开发场景渗透) │ / │ /── Coding Agents 启动 / (Kimi, GLM-4, MiniMax, DeepSeek) │ / └─────────────────┴─────────────────────────┴───────────────────────────────► 时间 2024 年初 2024 年 4 月拐点一:Coding Agents(代码 Agent)引发的第一次冲锋
2024 年初,随着 Kimi、智谱 GLM 系列、MiniMax 及 DeepSeek 等开源模型的升级,开源模型首次具备高稳定性驱动代码 Agent(如 Cursor、OpenCode)的能力。开发者开始将整段代码库注入模型,触发第一波 Token 消耗高峰。
拐点二:OpenClaw 与 Hermes Agents 引爆的通用自动化
今年 4 月,随着 OpenClaw 及后续 Hermes Agent 项目的问世,AI 自动化从“程序员写代码”跨越至“非程序员的长期任务自动化”。在财务分析、客户支持、市场营销等场景,非技术人员开始设定复杂目标,让模型自主寻找工具、抓取数据并完成闭环。
这两个拐点叠加开源模型上下文窗口从 128k 跃升至 100 万+(1M+),导致单个开发者周均 Token 消耗量指数级飙升:
- 单开发者维度
:平均每周 Token 消耗量较年初猛增 5 倍以上(从早期不足 1500 万 Token 迅速冲破数亿); - 云端总量维度
:Ollama Cloud 自今年年初上线以来,整体 Token 消耗总量实现了惊人的 150 倍(150x)增长!
这种暴涨宣告新时代到来:开源模型不再只是备选项,而是成为了支撑企业高频自动化算力的主干水箱。
4. 中国开源模型的云端“统御”与 Flash 模型革命
Ollama Cloud 全局数据展示了一个震撼的对比:
- 本地端(Local Downloads)
:开发者在 Mac 或本地硬件下载运行的模型中,美国开源模型(如 Meta Llama、Google Gemma)与中国开源模型基本保持 46% 对 40% 的势均力敌态势; - 云端托管(Cloud Tokens)
:在 Ollama Cloud 托管的云端推理流量中,中国开源模型家族(DeepSeek、GLM、Kimi、MiniMax 等)的 Token 占比从去年年底一路飙升,一度占到惊人的 96%!
云端 vs 本地 开源模型份额对比: 本地下载份额 (Local) : [美系模型 46%] [中系模型 40%] [欧系模型 14%] 云端 Token 份额 (Cloud) : [中国开源模型 96% ] [其他 4%]为何中国开源模型在云端展现压倒性优势?
Jeffrey Morgan 从工程落地层面解析了核心驱动力:极致的算力效率与"Flash"模型类别的崛起。
以 DeepSeek Flash 为代表的新一代开源模型,打破了“模型越大越好”的盲目崇拜,转而攻克极度苛刻的“每任务成本”与“每 Token 成本”:
-
极度激进的工程优化:通过 MoE(混合专家架构)、极致的 FlashAttention 改进与量化推断,这些模型在维持对 80% 日常任务“足够好”的高水准同时,将显存占用与推理延迟降至极致。 -
“无限 Token"心态重现:DeepSeek Flash 这类极度便宜且高吞吐的模型,让企业和创业者重新找回了“无需精打细算、放手高频调用”的自由度。 -
多模型链式编排:现代 Agent 架构不再依靠单个模型一次性给出完美答案,而是通过编排层将多个便宜、快速的 Flash 模型串联:一个负责抓取,一个负责提取,一个负责校对。这种“小模型组网”的综合表现超越单体大模型,总成本仅为后者的几十分之一。
5. 解构“五层蛋糕”:AI 技术栈的彻底剥离
NVIDIA CEO 黄仁勋曾提出著名的 "AI 五层蛋糕”理论。但在 Jeffrey Morgan 看来,在开源模型实际落地过程中,这块蛋糕正在被进一步剥离,衍生出大量过去隐藏在闭源黑盒内部的“中间层”创业机会。
参考 Anthropic 平台团队的最新划分,现代 AI Agent 架构正清晰地解耦为三个核心支柱:
现代 AI Agent 架构三层解耦: ┌────────────────────────────────────────────────────────┐ │ 1. 知识管理层 (Knowledge Layer) │ │ - 链接企业私有数据、动态上下文、RAG 与向量数据库 │ ├────────────────────────────────────────────────────────┤ │ 2. 任务协调层 (Coordination Layer) │ │ - 复杂任务拆解、子 Agent 调度、云/本地计算路由 │ ├────────────────────────────────────────────────────────┤ │ 3. 沙盒执行层 (Sandbox Execution Layer) │ │ - 隔离计算环境、代码运行、命令行安全试错与测试 │ └────────────────────────────────────────────────────────┘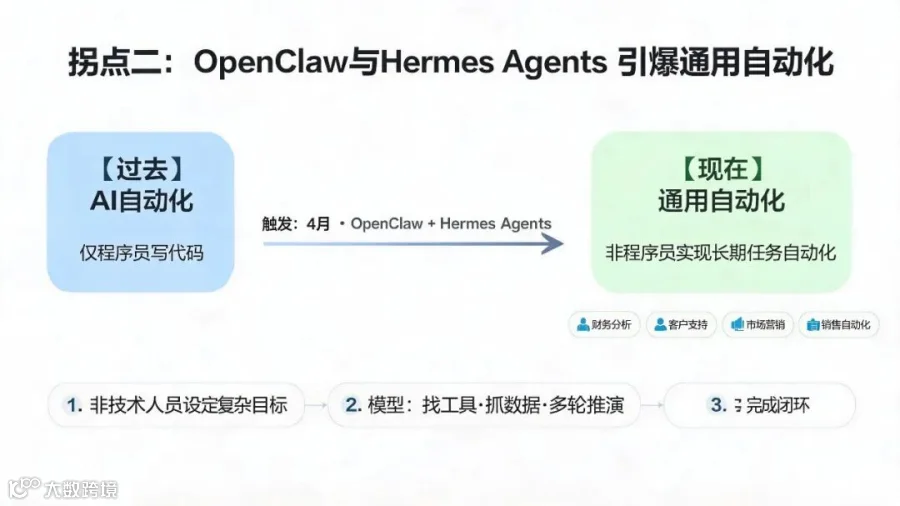
1. 知识管理层(Knowledge Layer)
模型本身不再承担百科全书存储功能,而是退化为纯粹的“逻辑推理 CPU"。企业私有文档、数据库、Memory 状态被彻底隔离在模型之外。由于大模型训练周期无法实时跟进秒级变动的业务数据,存储与状态管理成为了永远不可能被消化进模型权重内部的独立硬核层级。
2. 任务协调层(Coordination Layer)
当用户向 Cursor 或 OpenCode 提出高级指令时,后台会瞬间分裂出数十个子 Agent,有的在本地运行,有的分发至云端。如何高效协调这些子 Agent 之间的通信、上下文传递与异常中断,成为了全新的系统工程课题。
3. 沙盒执行层(Sandbox Execution Layer)
Agent 生成的代码或指令不能直接运行在宿主机上,必须运行在毫秒级拉起的云端或本地隔离沙盒中。模型在沙盒内自我测试、报错、修补代码,直到最终输出正确结果。
Garry Tan 总结道:“这就如同科技史上经典的 Bundling(打包)与 Unbundling(解耦) 循环。巨头实验室希望把你锁在‘私有花园’里;而全天下的创业者和开源社区,则会用一个个最佳组件将这个黑盒彻底拆解。”

6. Day 0 发布剧本与 Ollama 的“操作系统”生态位
当开源模型迭代节奏从“半年一更”缩短至“一周三更”,如何让全球开发者在模型发布的第一秒(Day 0)就能无缝用上,成为了极具挑战的工程难题。
Diana Hu 评价指出,Ollama 在整个 AI 生态中的角色,极其类似于传统计算机时代的 操作系统:向上承接多元化的开发者 Harness 与应用框架,向下适配极致复杂多样化的底层硬件与推理引擎(Apple Silicon、NVIDIA GPU、AMD、Intel)。
Ollama 的 Day 0 模型发布“四大标准剧本”
为了保障新型开源模型“发布即可用”,Ollama 团队总结出了一套标准化的工程发布剧本:
Ollama Day 0 模型发布流程: [实验室提前数周授权模型权重] │ ▼ ┌──────────────────────────┐ │ 1. 推理引擎深度适配 │ ➔ 确保速度、精度与参考实现一致 └──────────┬───────────────┘ │ ▼ ┌──────────────────────────┐ │ 2. 应用 Harness 整合 │ ➔ 匹配工具调用与多模态规范 └──────────┬───────────────┘ │ ▼ ┌──────────────────────────┐ │ 3. 硬件厂商算力打包 │ ➔ 联合 NVIDIA / Apple 优化内核与推理吞吐 └──────────┬───────────────┘ │ ▼ ┌──────────────────────────┐ │ 4. 发布前 24h 基准测试 │ ➔ 运行多维度 Benchmarking 复核,确保零回归误差 └──────────────────────────┘- 推理引擎深度适配
:在模型正式公开前数周,与模型实验室紧密对接,确保模型架构更新在底层推理引擎中得到最高效实现,避免速度变慢或精度衰减。 - 应用 Harness 整合
:针对模型新增的特殊能力(如多模态 LLM 架构),同步更新或适配开发者的 Harness/SDK,确保工具调用和图像解析指令能够无缝分发。 - 硬件与云供应商联合封装
:与 NVIDIA、Apple Silicon 团队提前协同,针对硬件算力进行极限吞吐优化,并在云端提前储备足够的并发算力池,预防发布首日流量峰值崩溃。 - 最后 24 小时的基准测试
:在模型向全球解锁的前 24 小时内,对最终封装完毕的二进制文件运行多轮严格的自动 Benchmarking,确保其实际运行表现与实验室发布的 Research Paper 完全吻合。
这种高度密集的系统工程,成功将过去繁重复杂的模型部署流程,封装为了开发者终端里一句简单的 ollama run <model>。
7. 本地算力大复兴:从 Mac Studio 到 NVIDIA DGX Spark
除了云端托管,硬件层面的突破正在推动一场极具革命性的**“本地算力复兴”**。
多年来,业内认为没有数十张 H100/A100 构成的云端集群就无法运行高质量 AI 模型。但 Apple Silicon 统一内存架构的普及,以及 NVIDIA 桌面级计算设备的跨越式演进,彻底打破了这一神话。
消费级硬件上的智商飞跃
在实际测试中,参数量在 20B 到 40B 范围内的开源模型(例如 Qwen 3 38B),在代码编写与补全逻辑上的 benchmark 评分,已经能够全面媲美闭源顶级模型。
而运行这样一个极其聪明的模型,根本不需要昂贵的服务器,只需要一台搭载统一内存的普通苹果 MacBook。
桌面级“微型数据中心”:NVIDIA DGX Spark
Jeffrey Morgan 与 Garry Tan 重点探讨了 NVIDIA 在硬件形态上的最新突破——DGX Spark:
- 桌面级形态
:体积如同精致的桌面主机,无需工业风扇,可安静摆放在工程师办公桌上; - 128GB 统一高带宽内存
:搭载全新芯片组,能以极高的 Token 吞吐速率本地顺畅运行 20B 到 120B 参数 的大模型; - 高速网络堆叠
:通过极快的高带宽专有网络接口,工程师可将多台 DGX Spark 像搭积木一样堆叠连接,直接在桌边拉起一个能够运行 400B 参数 超大模型的“微型数据中心”!
本地算力硬件演进对比: ┌─────────────────────────┬───────────────────────────────┬─────────────────────────────┐ │ 硬件设备 │ 内存/显存配置 │ 可运行模型参数规模 │ ├─────────────────────────┼───────────────────────────────┼─────────────────────────────┤ │ Apple MacBook Pro / M3 │ 36GB - 128GB 统一内存 │ 8B - 38B 参数 (Qwen, Llama) │ │ NVIDIA DGX Spark │ 128GB 统一内存 │ 20B - 120B 参数 │ │ 多台 DGX Spark 桌面堆叠 │ 512GB+ 级联内存 │ 最高 400B 参数超级模型 │ └─────────────────────────┴───────────────────────────────┴─────────────────────────────┘混合路由闭环:从本地到云端再回归本地
这一硬件演变促成了全新的**“混合路由工作流”**:
混合路由工作流逻辑: ┌───────────────────────────┐ │ 开发者/用户输入任务 │ └─────────────┬─────────────┘ │ ▼ ┌───────────────────────────┐ │ 本地路由器 (Router) │ └──────┬─────────────┬──────┘ │ │ (高频/轻量任务)│ │(极复杂/高难度任务) │ │ ▼ ▼ ┌──────────────────────────────┐ ┌──────────────────────────────┐ │ 本地硬件 (Mac / DGX Spark) │ │ 云端算力池 (Ollama Cloud) │ │ - 文档解析、代码补全、单元测试 │ │ - 跨系统架构设计、全局推演 │ │ - 零 API 成本、极低延迟 │ │ - 弹性按需扩展 │ │ - 数据 100% 绝对私有 │ │ │ └──────────────────────────────┘ └──────────────────────────────┘- 本地极速响应
:简单的文档处理、代码语法检查等占据日常 70% 的轻量任务,直接发往本地 Mac 或 DGX Spark,享受 100 毫秒级的极低延迟 与 零 API 边际成本,且隐私数据绝对不出设备; - 云端强力兜底
:当路由器识别到需要进行跨多个系统工程架构的深度推理或大型算法生成时,加密请求会自动无缝路由至云端托管的大参数开源模型集群。
Jeffrey Morgan 总结道:"Ollama 的旅程始于本地,随后因代码 Agent 对算力的巨大开销而走向云端;但随着桌面硬件的爆发,最极致的代码体验终将全面回归桌面,形成本地与云端深度共生的终局。”
8. 垂直杀手级应用:网络安全与渗透测试的“刚性破局”
在探讨开源与闭源大模型的竞争边界时,网络安全与渗透测试提供了一个极具说服力的差异化范例。
闭源模型的“拒答”死结
在企业网络安全攻防演练中,红队安全专家需利用 AI 模拟黑客攻击手法。然而,当安全工程师向 Claude 3.5 或 GPT-4 输入攻击性代码测试指令时,闭源前沿模型往往会直接触发安全合规红线,弹出拒答提示:
“抱歉,我不能协助编写可能用于网络攻击或渗透测试的脚本。”
这种无差别的“过度防御”,导致安全合规团队根本无法利用顶尖闭源 API 来提升防御效率。
开源模型在安全领域的无可替代性
与此形成鲜明对比的是,开源模型为网络安全领域带来了彻底的解绑:
- 去除束缚的安全专精模型
:开源社区允许安全团队在完全隔离的私有沙盒中部署模型,彻底解除不必要的拒答限制,自由执行白帽渗透与代码审计; - 防御端的“以毒攻毒”
:连知名开源平台 Hugging Face 本身,在近期遭遇潜伏渗透时,也是依靠基于开源权重模型定制的安全模型,才成功检测并拦截了这一隐蔽入侵; - 智谱 GLM-5-3 的安全能力突破
:最新的 GLM-5-3 等开源模型在网络安全攻防 Benchmark 上展现出了顶尖水准,为全球网络安全与治理类创业公司开辟了全新的万亿级市场。
解决“满洲候选人”与供应链毒化焦虑
针对“企业是否会担心中国开源模型带有后门风险”的敏感问题,Jeffrey Morgan 给出了专业的企业级视角:
“对于全球‘财富 500 强’企业的顶尖 IT 和安全团队来说,开源模型的安全性并不是全新难题。现代企业应用平均包含数千个开源代码依赖项,供应链毒化风险在软件工程界已经存在了数十年。
大模型虽然具备非确定性特征,但只要企业在本地部署时为其配套建立标准化的输入输出沙盒审查、安全栅栏与流量隔离机制,开源模型带来的巨大效率提升与成本优势,完全足以让全球企业放心地全面接纳。”
9. 总结:技术决策者的落地行动指南
从这场深度对话中,我们可以清晰看到大模型产业重构的四大底层逻辑:
- 算力经济学重塑
:不要继续为简单的提取、转换和流水线代码生成支付昂贵的闭源 API 溢价。将 80% 的日常 Token 消耗平滑迁移至低成本的开源 Flash 模型,是现代企业 CTO 降本增效的最快路径。 - 拥抱 AI 架构解耦
:模型权重正在退化为基础推理单元。应将工程精力集中在 知识管理层、Agent 任务协调层与沙盒执行层,在解耦的层级中建立真正的工程护城河。 - 部署本地与云端混合路由
:关注以 Apple Silicon 和 NVIDIA DGX Spark 为代表的桌面算力复兴,为核心研发团队配置高统一内存的本地计算设备,构建“本地极速响应 + 云端弹性兜底”的混合路由架构,兼顾极致速度与数据隐私。 - 建立 Day 0 模型的快速响应机制
:开源模型的迭代速度已全面压倒闭源模型。基于 Ollama 这种具备高度标准抽象层的基础设施构建应用,才能确保团队在任何新型开源模型发布的 Day 0,瞬间享受到全球最新的智商与性价比红利。