01 资本跑在产品之前:世界模型疯狂吸金的 2026
2026 年,世界模型赛道骤然拥挤。下半年行业风向突变:焦点从“能否生成世界”转向“生成的世界是否可用”。
9 月 1 日,李飞飞创办的 World Labs 发布 Atlas。不同于以往基于图片生成漫游场景的 Marble,Atlas 采用从头预训练策略,将文本、图像、视频和 3D 纳入同一空间上下文(spatial context)。它兼具生成、重建与演化模拟能力,被定义为承担多重任务的统一 "omni world model"。
评测端亦现显著变化。8 月,Odyssey 发布 CaliBench,直击核心痛点:World Model 是否符合物理规律?此前其连续推出多智能体模型 Agora-1、实时多模态模型 Starchild-1 及探索学习模型 PROWL-1。行业关注点迅速聚焦于状态稳定性、动作对未来的实际改变以及物理过程的可校准性。
商业化进程同步加速。Decart 发布 Oasis 3 后,直接将世界模型应用于自动驾驶模拟:实时生成交互式驾驶环境,通过 API 开放给开发者,用于构建现实世界中罕见或危险的长尾场景。其定位已超越生成工具,成为可供自动驾驶和机器人程序直接调用的仿真基础设施(simulation infrastructure)。
技术尚在试错,资本却已完成首轮定价。World Labs 最新估值约 54 亿美元,Decart 约 40 亿美元,Odyssey B 轮后估值达 14.5 亿美元;Yann LeCun 创办的 AMI Labs 更以 35 亿美元投前估值完成巨额种子轮。仅 2026 年,几家纯世界模型创业公司融资总额已超 30 亿美元。但需警惕的是,顶级估值锚定的是团队背景、底层路线与未来生态卡位,而非当前的商业变现能力。多数企业仍处项目制或早期试点阶段,估值成熟度与收入落地间的落差,成为行业最大隐忧。
一个定义未统、路线未收敛的赛道,已率先进入十亿美元估值时代,构成当下最鲜明的矛盾。本文将从技术演进的核心变量出发,系统梳理中美世界模型创业图谱、六条主要技术路线及其资本进展,并探讨该赛道的未来流向。
02 为什么是现在:世界模型爆发背后的五层变量
世界模型并非新概念。从强化学习环境模型到自动驾驶仿真,再到 LeCun 提出的预测式世界模型,AI 学界始终致力于解决同一问题:机器能否在内部建立外部世界模型并据此预测未来?
关键在于时间点的变化。过去两年,世界模型从强化学习和机器人的技术支线,快速进入 Google DeepMind、Meta、NVIDIA、World Labs 等头部实验室的核心路线图;Runway、Odyssey、Decart 等创业公司也将融资与产品重心押注于此。
资本是结果而非原因。世界模型此时爆发,实则是多条独立技术曲线首次交汇。
第一推动力:AI 任务从“理解世界”转向“预测世界”。过去十年 AI 范式擅长回答既定问题,但机器人、自动驾驶及长期行动的 Agent 需解决全新挑战:执行动作后会发生什么?这意味着模型不仅要理解当前状态,还需学习 State → Action → Next State。语言模型回答“世界是什么”,世界模型解决“世界将变成什么”。Google DeepMind 的 Genie 3 已能根据文本实时生成可导航环境,并保持数分钟一致性。
第二变量:视频模型跨过世界模拟的技术门槛。若无过去三年视频生成模型的进步,此轮热潮难以为继。视频天然包含图片与文本缺失的关键信息:时间。物体运动、人物行动、空间变化及遮挡关系,构成了关于世界动态规律的大规模训练数据。视频生成模型的发展无意间完成了世界模型最重要的基础设施建设。
两者模型结构相近但目标函数不同,导致视频生成与世界模型公司的边界日益模糊。Runway 将下一代模型定义为 world models;Odyssey 向机器人和模拟扩张;Decart 的 Oasis 3 率先用于自动驾驶模拟。Google DeepMind 的路线同样印证了这一趋势:Veo 解决高质量视频生成,Genie 加入动作条件与实时交互。Text-to-Video → Video Prediction → Action-conditioned Video → Interactive World正成为世界模型的重要 Scaling Path。
视频模型解决了“生成能力”,机器人与 Physical AI 则提供了巨大的需求端。核心逻辑在于:机器人缺的不是更聪明的聊天机器人,而是低成本犯错的世界。现实数据采集昂贵且长尾场景(如突发状况)难以复现,形成 Physical AI 的数据瓶颈。世界模型的价值在于让机器人在生成的虚拟世界中经历数百万种可能,无需在现实中试错。
NVIDIA 2026 年推出的 Cosmos 3 已将此路线产品化:整合视觉推理、世界生成与动作预测,服务于机器人、自动驾驶及视觉 Agent 训练。World Labs 也接入 Real-to-Sim-to-Real 流程,其发布的 Atlas 原生处理多模态信息。这意味着世界模型可能占据与 LLM 不同的生态位:LLM是 Agent 的“大脑”,world model 则是 Agent 的“训练场”,甚至是行动前的“想象空间”。
另一驱动力常被低估:数据。LLM 的 Scaling 依赖互联网数十年的文本积累,而世界模型需要长时间、连续、含动作信息的真实世界数据,这类数据远比普通视频稀缺。竞争焦点将从文本转向世界轨迹(world trajectories),探索新的 Scaling 范式:空间 × 时间 × Action。模型处理的不再是静态“内容”,而是状态不断变化的空间。
Origin Lab 等公司开始协助游戏公司将交互数据出售给 world-model builders。游戏数据天然包含环境状态、动作、物理反馈及结果,结构上更接近世界模型需求。自动驾驶历史数据、玩家轨迹、遥操作数据及 AR/VR 第一视角数据因此焕发新价值。未来壁垒不仅是模型,更在于谁拥有世界的数据。
此外,AI 原生内容形态正在演变。第一代生成式 AI 是静态的 Prompt-to-Result,而 Google DeepMind 的 Genie 3 允许用户进入生成世界实时探索,并通过 Prompt 动态调整事件。这标志着生成式 AI 正从 Generative Content 走向Generative Experience。游戏、影视、教育、数字人乃至 AI 原生社交产品均可能建立在此能力之上,催生多样化的商业模式。
03 六条技术流派,引领下一阶段的新范式
世界模型正经历范式演进。前四派探索“世界模型是什么”,Physical AI 派回答“如何成为产业基础设施",而 Active Inference 与因果派则试图补齐缺陷、引领新范式。
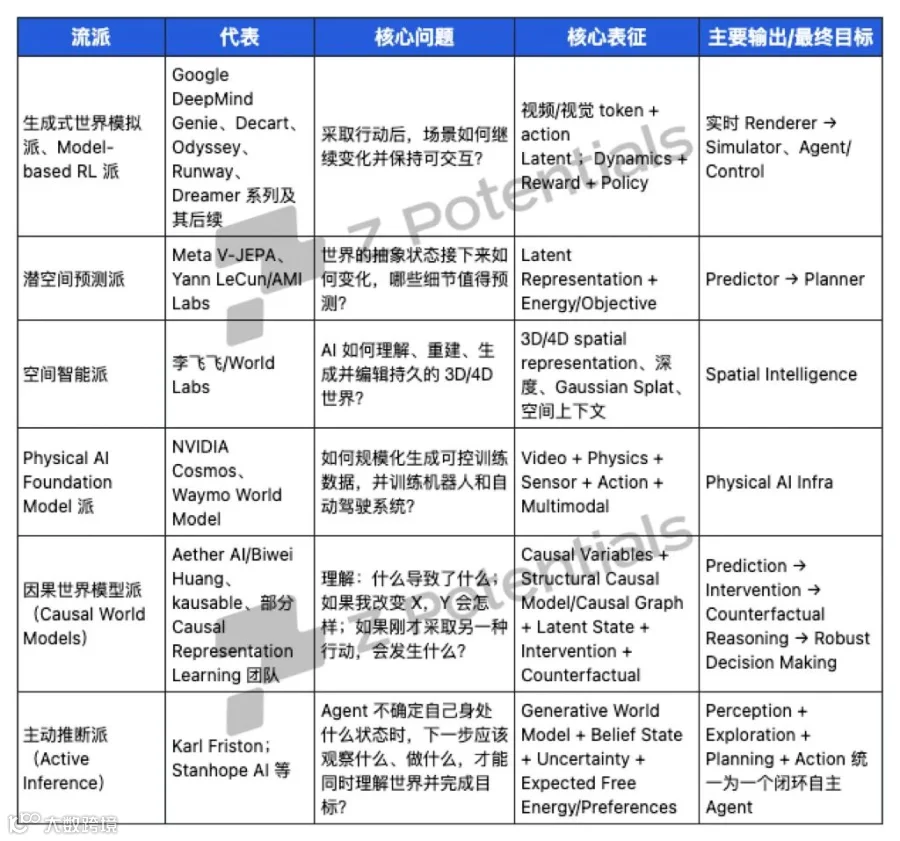
PS:以上图表为互联网公开信息不完全统计
1. 生成式世界模拟/Model-based RL:把视频生成推向可行动的模拟器
该路线本质是学习动作条件下的世界演化模型。给定当前状态和 action,模型持续预测“动作后的世界变化”。与普通视频生成相比,其核心差异在于生成结果受 action 控制且在连续交互中保持一致。Model-based RL 进一步将动力学模型接入奖励、策略与规划,让 Agent 先在内部“想象”后果再执行。
目前该方向已进入实时交互阶段。Google DeepMind 的 Genie 3 可生成 720p、24fps 的可实时探索环境,并保持数分钟一致性;2026 年 5 月,Google 将 Project Genie 与 Street View 结合,使生成世界锚定真实地点。

PS:以上图表为互联网公开信息不完全统计
这是资本最热、产品形态最直观的路线,竞争指标转向 action fidelity、长时一致性、实时生成及物理可信度。核心挑战包括:一、长时一致性,目前仅能维持几分钟;二、action fidelity,视觉合理不代表因果准确,难以成为可信模拟器;三、计算成本,实时生成高分辨率长时序世界代价高昂。
2. 潜空间预测派:不预测所有像素,只预测“世界真正重要的状态”
JEPA 路线主张世界无需逐像素重建。Yann LeCun 强调人类预测世界时形成的是抽象内部状态。因此 JEPA 先将观察编码为 latent representation,再预测其中“重要信息”的变化,而非直接生成完整画面。
该路线优势在于效率与抽象能力。Meta 推出的 V-JEPA 2 已从纯视觉表征推进至机器人规划:利用大量普通视频无监督预训练,仅需少量机器人数据即可在新环境中执行复杂任务。其 Scaling 路线为:Internet Video → Latent World Representation → 少量 Robot Data → Planning,突破了“必须海量机器人数据”的主流思路。
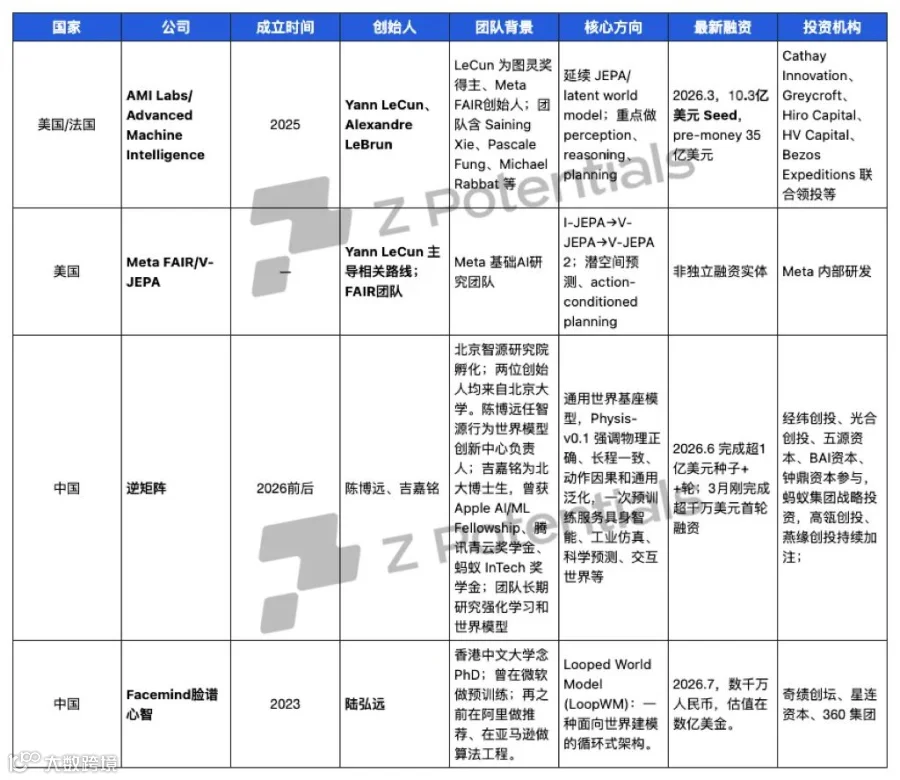
PS:以上图表为互联网公开信息不完全统计
核心挑战在于:一、latent representation 是否包含完成任务所需的全部物理信息尚难证明;二、可解释性弱,难以确认模型学到的是物体关系还是统计特征;三、在长时规划和复杂多步骤任务上的表现不及预期。
3. 空间智能派:从“生成一个画面”变成“建立一个持续存在的世界”
李飞飞和 World Labs 代表另一种出发点:AI 需建立空间的内部表征。该派核心并非简单 3D 生成,而是建立持续存在的 spatial context:物体在画面外依然存在,多角度观察位置形状一致,用户或机器人行动后空间保持一致。
2026 年该路线进展迅速。World Labs 发布新一代模型 Atlas,从头进行多模态预训练,原生处理 text、image、video 和 3D,统一进入 shared spatial context;基于多模态自回归扩散 Transformer,根据已有上下文预测生成后续内容并保持 3D 一致性。其路线正从“生成 3D 世界”扩展至机器人,提出 Real-to-Sim-to-Real:将真实世界转为可控模拟世界训练机器人,再迁移回现实。
挑战在于 Geometry 并不等于 Physics。理解物体位置与形状,不代表知晓质量、摩擦系数及力学规律。从 3D 重建到空间理解再到物理模拟,中间仍有巨大鸿沟。
下一阶段关键问题是让空间表示真正成为机器人 planning 和 interaction 的底层状态。

PS:以上图表为互联网公开信息不完全统计
4. Physical AI Foundation Model:世界模型开始变成机器人的“基础设施层”
这是中美资本最密集、中国公司最多的一派。与前几派讨论“如何表示与预测”不同,该派聚焦如何将能力规模化,成为机器人、自动驾驶和智能设备共用的基础模型与数据基础设施。
NVIDIA Cosmos 是典型代表。它试图建立完整的 Physical AI Stack:涵盖 world generation、reasoning、action prediction、synthetic data 等全流程。2026 年 5 月发布的 Cosmos 3 采用 Mixture-of-Transformers,将视觉语言推理塔与扩散生成塔统一,使单模型能同时处理视觉推理、world simulation 和 action generation,支持多模态输入。
产业变化显著:机器人基础模型正从 VLM → VLA 演变为VLM + World Model + Action Model。即先理解环境,再内部 simulate 不同行动的未来,最后生成 action。NVIDIA 将 Cosmos 3 定位为 World Action Model 的 backbone。Waymo World Model 则体现另一方向:作为数据机器和测试机器,规模化创造危险、极端场景,让系统提前经历“现实未遇情况”。
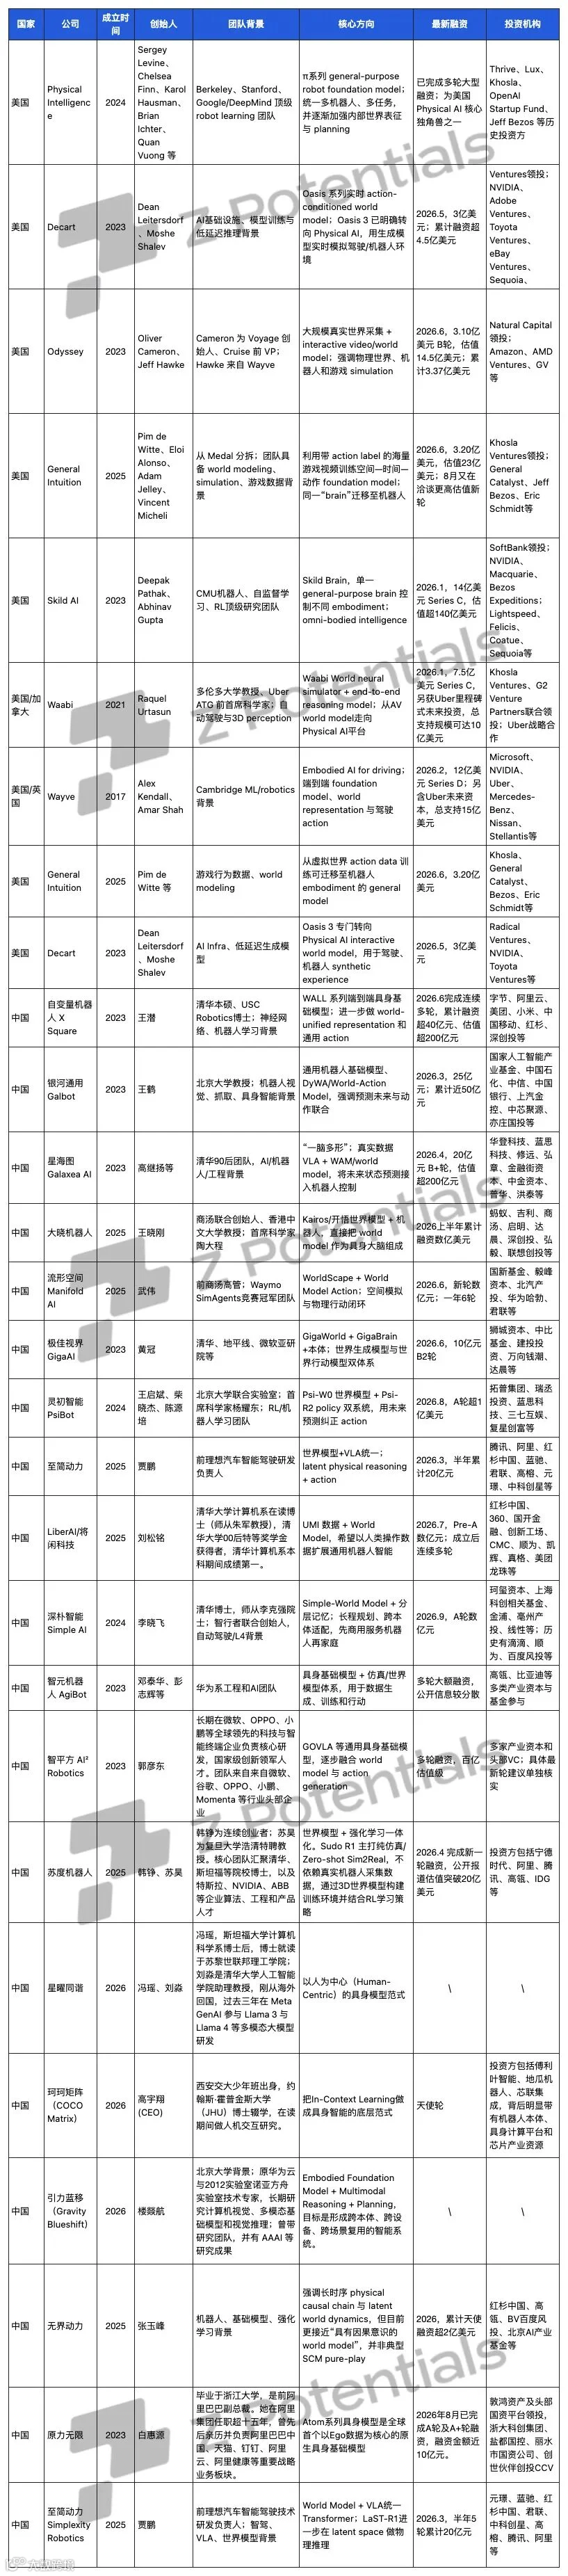
PS:以上图表为互联网公开信息不完全统计
最大挑战是 Sim-to-Real Gap。生成视频逼真不代表物理规律准确,错误 physics 可能导致机器人学习错误策略。因此,核心竞争在于谁生成的数据对真实世界 policy improvement 最有价值。
5. 因果世界模型:从“预测接下来发生什么”走向“理解为什么会发生”
这是值得单独强调的“新变量”。当前大部分世界模型学习 P(st+1|st,at),仅为相关性。因果世界模型旨在学习 P(Y|do(X))——主动改变 X 造成的结果,甚至反事实推理:若未做 A 而做 B 会怎样?
该派希望在 latent space 中形成:Causal Variables → Causal Structure → Causal Dynamics。例如机器人抓杯子,不仅知“手靠近杯动”,更应理解抓取点、摩擦力、力度与速度如何共同决定结果。
Aether AI 是该方向代表。其创始人黄碧薇长期研究 causal representation learning,核心目标是学习 latent causal variables 及 dynamics。2026 年 7 月公布的 CD-LAM 针对 embodied world model 中 action 控制力弱的问题,通过在训练前对 latent action 做 causal debiasing,显著降低 error 并减少 post-training 更新次数。
另一方向 kausable 定义为 reasoning-first causal world model,希望在少数据甚至无梯度重训情况下,根据新动态系统快速建立因果模型。研究界也出现如 LingBot-VA 等工作,将视觉 latent 和 action token 放入统一 causal sequence,并通过真实环境反馈不断 grounding。
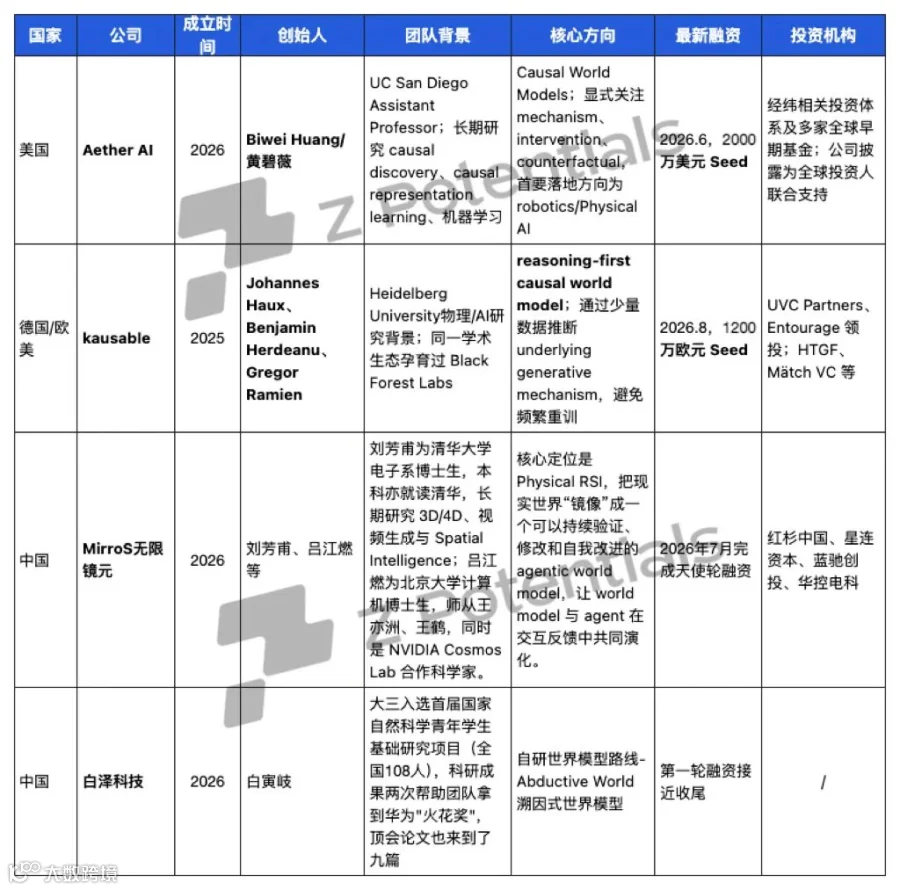
PS:以上图表为互联网公开信息不完全统计
最大难题是真实世界的 causal variables 无标签。质量、摩擦、意图等大量变量是 latent 的;仅靠观测视频难分相关与因果,而真实干预数据昂贵。
6. Active Inference:世界模型从预测环境变成主动减少自己的不确定性
Active Inference 源自 Karl Friston 的自由能原理与计算神经科学,解决更底层问题:智能体不仅预测世界,还主动决定“接下来需知道什么”。
根本区别在于:传统 world model 假设 State → Predict Future → Choose Action,而 Active Inference 强调Belief → Action → Observation → Update Belief。Agent 维持对世界的 belief distribution,行动既为完成任务也为获取信息(Epistemic Action),以降低不确定性。
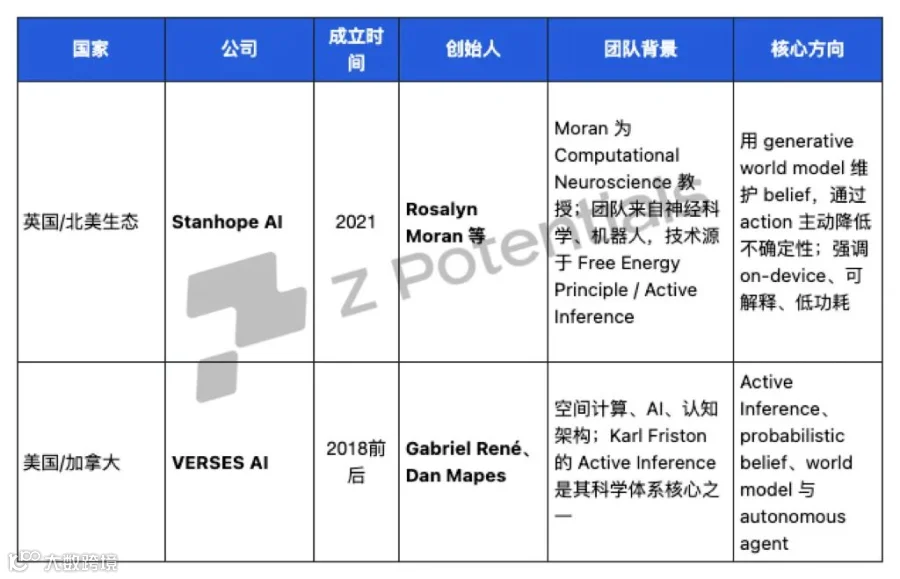
PS:以上图表为互联网公开信息不完全统计
Stanhope AI 是少数明确以 Active Inference 构建 embodied AI 的公司,目标是在低功耗边缘设备上维护轻量级、可解释的 world model。该框架已进入自动驾驶真实系统,如 Waymo 与 TU Delft 合作的 ReD 模型,利用 Active Inference 模拟人类司机面对碰撞时的预测与避让行为。
Active Inference 仍存在理论与工程鸿沟。虽在低维控制和机器人任务上有应用,但如何将 belief、expected free energy 等机制扩展至高维视觉世界及 Foundation Model 规模,尚无统一答案。
该方向从belief、uncertainty、epistemic action重新定义 Agent 认知与行动。目前处于“理论成熟、产业化早期”阶段,中国尚未形成明显创业群。
整体来看,六条路线资本密度差异明显。美国新范式创业更突出,AMI 押注 JEPA,World Labs 押注 Spatial Intelligence,Stanhope 押注 Active Inference,Aether/kausable 押注 causality。中国创业密度集中于 Physical AI/WAM,多从真实机器人任务倒推,出现一批VLA → VLA + World Model → WAM的公司。
04 跨过模型、数据、真实验证三道门槛,才能成为基础设施
世界模型正经历重心转移。当越来越多模型能生成“看起来像真的”世界后,真正拉开差距的是:世界能否被行动改变、变化是否符合物理规律、推演结果能否指导真实世界。
评价标准的变化促使分立的技术路线长期看可能走向汇合。
虽然目前各派信仰不同,但随着问题从“生成”走向“模拟”,单一路线局限显现。纯像素模型难提供稳定内部状态;纯 latent 模型难观察审计;3D/4D 表征难回答力学变化;仅有 policy 易退化为模式匹配。
下一代主流 world model Likely 是一次架构的汇流。成熟模型将根据任务同时维护多个层次的世界:看得见的、看不见的状态以及可被改变的未来。
下一阶段竞争核心将从Generation Quality 转向 Simulation Utility。决定进展速度的六个变量:一、时间一致性(从秒到小时);二、空间一致性(物体位置几何身份稳定);三、Action Controllability(动作真正改变世界);四、物理真实性(学到碰撞重力等规律);五、实时性与成本(延迟降至交互级);六、Sim-to-Real(虚拟能力迁移现实)。
为支撑转变,输入模态需从“文本/图像/视频”扩展至“动作、力、触觉、声音、深度及机器人状态”。竞争范式正从Next Frame Prediction 跨越至Next Physical State & Next Action 的联合建模。
另一核心卡点是数据。稀缺数据正从单纯的Observation变成:Observation + Action + Consequence。高价值数据还包括失败、恢复、奖励、多传感器同步信息等。游戏日志、自动驾驶车队、机器人真机网络正成为新数据入口,提供完整的状态、动作、结果及后续行动闭环。未来属于拥有更多真实可行动闭环 experience 的企业。
核心挑战还有评测错位。现有 Benchmark 多测清晰度、美学等,无法回答世界模型核心问题:世界是否按正确规律运行。
下一代 Benchmark 将转向四个底层问题:第一,Persistence(状态长期保持);第二,Action Fidelity(动作引发对应变化);第三,Long-horizon Rollout(长步推演误差控制);第四,Sim-to-Real(训练策略在真机有用)。这将是世界模型与视频生成模型真正分家的时刻。
05 商业化:世界模型的双轨结构、四层兑现与终局分水岭
从场景看,最早形成收入的市场来自数字世界。核心场景包括游戏、影视、广告、3D 设计、互动娱乐、数字孪生。这些行业需求明确、容错率高、反馈快,易形成商业收入。
另一条路线是:自动驾驶、机器人、工业 simulation。商业化周期更长,因生成结果需经受真实物理验证。但一旦证明能减少数据采集、降低测试成本、提高训练效率,其替代的将是现实世界中昂贵的数据、设备、时间与安全成本。
头部公司可能出现“双轨结构":左手用创意工具和数字世界获客变现;右手推进机器人、自动驾驶和 Physical AI。最终决定天花板的是能否从 Digital World 跨到 Physical World。
商业化将沿不同层级逐步兑现:
第一类是创作工具和订阅/API。按生成次数、算力或订阅收费,是最接近成熟 SaaS 的模式。
第二类是内容生产和行业解决方案。为更快的资产生成、场景制作付费,世界模型作为生产力工具。
第三类是Simulation-as-a-Service。面向自动驾驶和机器人,收费对象是“生成训练环境和测试场景”,核心价值在于减少真实采集成本和制造极端样本。
第四层:World Model as Infrastructure。模型成为训练、验证和决策依赖的基础设施,商业模式走向平台授权、企业部署和长期合同。
市场预期 World Model 从“工具”向“基础设施”上移,资本已提前计入估值。中美均出现大额融资,逻辑是抢团队、抢路线、抢 Scaling Curve。
但随着玩家增多,资本将追问具体问题:是否有可扩展预训练体系?模型是否受 action 控制?模拟结果能否被验证?客户为何持续付费?届时估值逻辑将被重定义。只有跨过模型、数据、真实验证三道门槛的公司,才能从热门 Startup 蜕变为 Physical AI 的基础设施公司。