


干买量这行的,应该都被这三个问题折磨过:
这条素材为什么爆?不知道,做它的创意策划换项目了。这条和上个月那条是不是同一个创意?翻聊天记录翻俩小时,翻出三张互相矛盾的 Excel。这个方向是不是试到头了?没人记得,再花一笔钱试一遍。
素材散在网盘里,数据躺在 Excel 里,真正值钱的判断全在几个人脑子里。
说白了,设计有 Figma,代码有 Git,投放执行有广告后台。唯独「创意是怎么一步步迭代出来」这件事,从来没有过自己的系统。
所以我就干脆自己造了一个,叫 Augura。
项目地址:
https://github.com/augura-os/augura一句话介绍:把每条素材拆成结构、连成图谱,让每一次人工判断都沉淀为团队资产,而不是跟着人走。
素材会过时,做素材的经验不该过时。 这是我写在它首页的一句话,也是做这东西的初衷。
它到底干什么
先说清楚它不是什么:它不是又一个 AI 生成素材的工具。市面上的生成工具已经够多了,讲真,生成出来的素材只会加速过时。
Augura 干的是另一件事——AI 创意决策系统。
流程大概是这样:你把素材传上去,AI 把每条视频拆成钩子、冲突、玩法、奖励这些结构;拆完的素材自动聚类,连成一张 DNA → Creative → Variant → Asset → TAG 的图谱;
从这之后,你做的每一次判断,像“这两条是不是同一个创意”、“这次裂变有没有效”,系统都会记住。下次遇到同类情况,它先给建议,你只负责点确认。

Demo 脱敏演示 - 主界面
还有一点必须放最前面说,因为这是我们跟市面上 SaaS 创意工具最大的区别:本地优先,数据全在你自己机器上。素材、投放明细、分析结果,都存在你自己的电脑、服务器或者 NAS 里。
AI 分析用的是你自己配置的模型 Key,不走我们的服务器。对 UA 团队来说,素材和投放数据属于最敏感的家底。
这玩意要是做不到数据主权,别的功能做得再花哨,搁我们自己身上我们也不敢用...将心比心吧。
核心功能
第一个,AI 拆素材。
视频抽帧之后交给视觉模型,输出结构化的 JSON:钩子是什么、冲突是什么、玩法类型、奖励机制、角色、情绪、标签。
关键的一条设计原则是:分析没把握的素材,自动进人工复核队列。AI 置信度不够,不会硬猜。一条错标混进图谱,污染的是后面所有判断,这个代价比让真人多看一眼大多了。
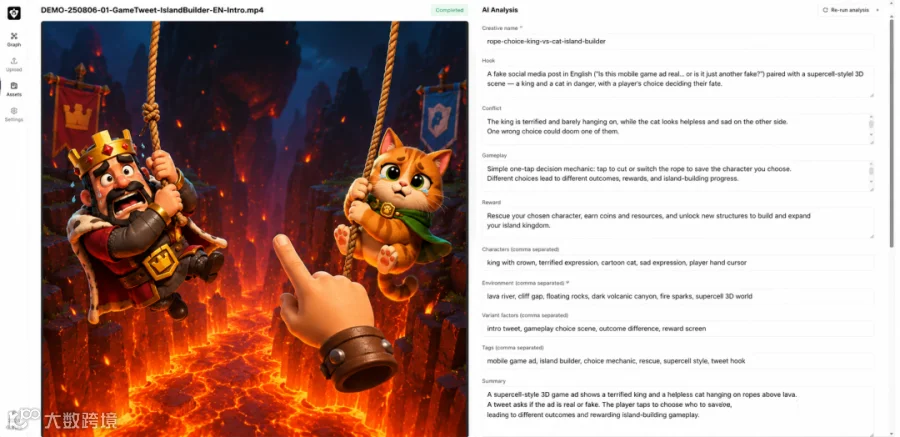
素材解析结果页-脱敏演示
第二个能力是知识图谱。
举个例子。KS_EN 和 KS_KR 两个文件夹里各躺着一个同名视频,人工看就是两条素材。系统直接认出那是同一条素材的两个市场版本,在图谱里连成候选,等你一句话合并。
整个素材库变成一张五层知识图谱,能够可视化地逛。创意之间的血缘关系,头一回变得能看见了。
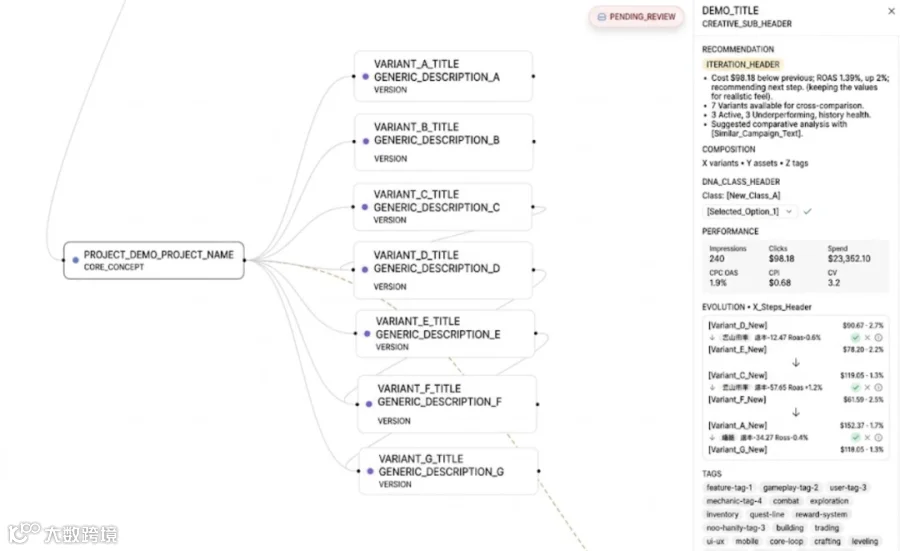
疑似同创意连线-脱敏演示
第三个能力,合并守卫。
这是我自己最喜欢的一个功能,没有之一。也是"经验沉淀"四个字最直接的体现。
你裁过一次这两条不是同一个创意,系统永久记住。以后不管是谁、啥时候想再合并这两条,必须写明理由才能提交。
以前这种判断是消耗品,判完就没了,换个新人接着踩坑。现在它是资产。就冲这个功能,前面那些折腾都值了。
我平时比较懒,所以在 setting 页面里增加了一个自动合并的开关,大家也可以打开。
第四个能力,裂变演化。
每条 Variant 都记着它从谁裂变而来、改了什么因子——换语言、换画幅、换前贴、换角色.....。投放数据回流之后,系统自动判定这次裂变有效还是无效。
一个方向连着几次裂变都无效,系统会直接劝你收手。搁以前,全靠资深策划拍脑袋,现在有数了。
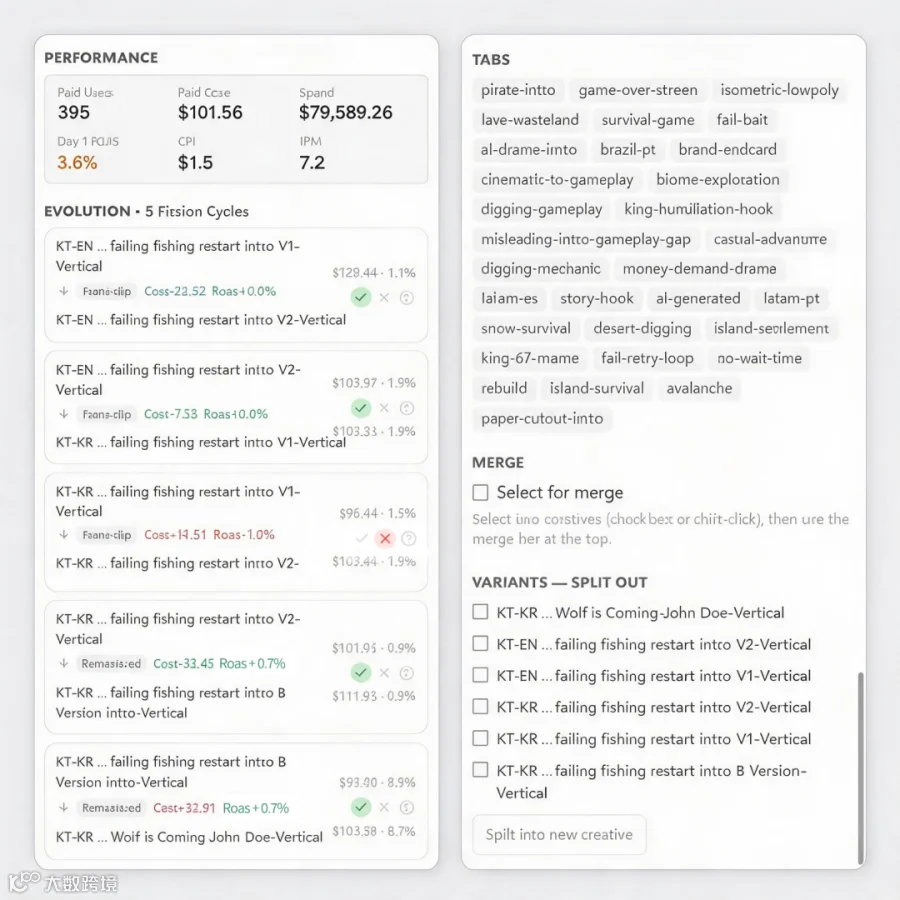
裂变谱系 - 脱敏演示
第五个,方向推荐。
所有待裁决的事(疑似合并、未归族、观察对结案)都进审核收件箱。每条都先由 LLM 自洽投票给出建议和理由,你一键处理。
但刹车我们也装了:如果某类建议的改判率超过阈值,系统会自动把这类建议降级成"仅建议"模式,不再给倾向性结论。说白了,AI 辅助的前提是它的错误有成本上限,不能让它撒开了判。
每周把新的投放报表传上来,消耗、付费、ROAS 等自动匹配回素材。然后「今日建议」面板会告诉你:哪些加注、哪些迭代、哪些该停。每条建议后面都挂着具体的数字,不是个黑盒。
付费成本红线、ROAS 绿线、D3 留存参不参与判定,这些口径都在 Settings 页自己调,不用改代码。各家 KPI 口径不一样,这东西写死了就是耍流氓。
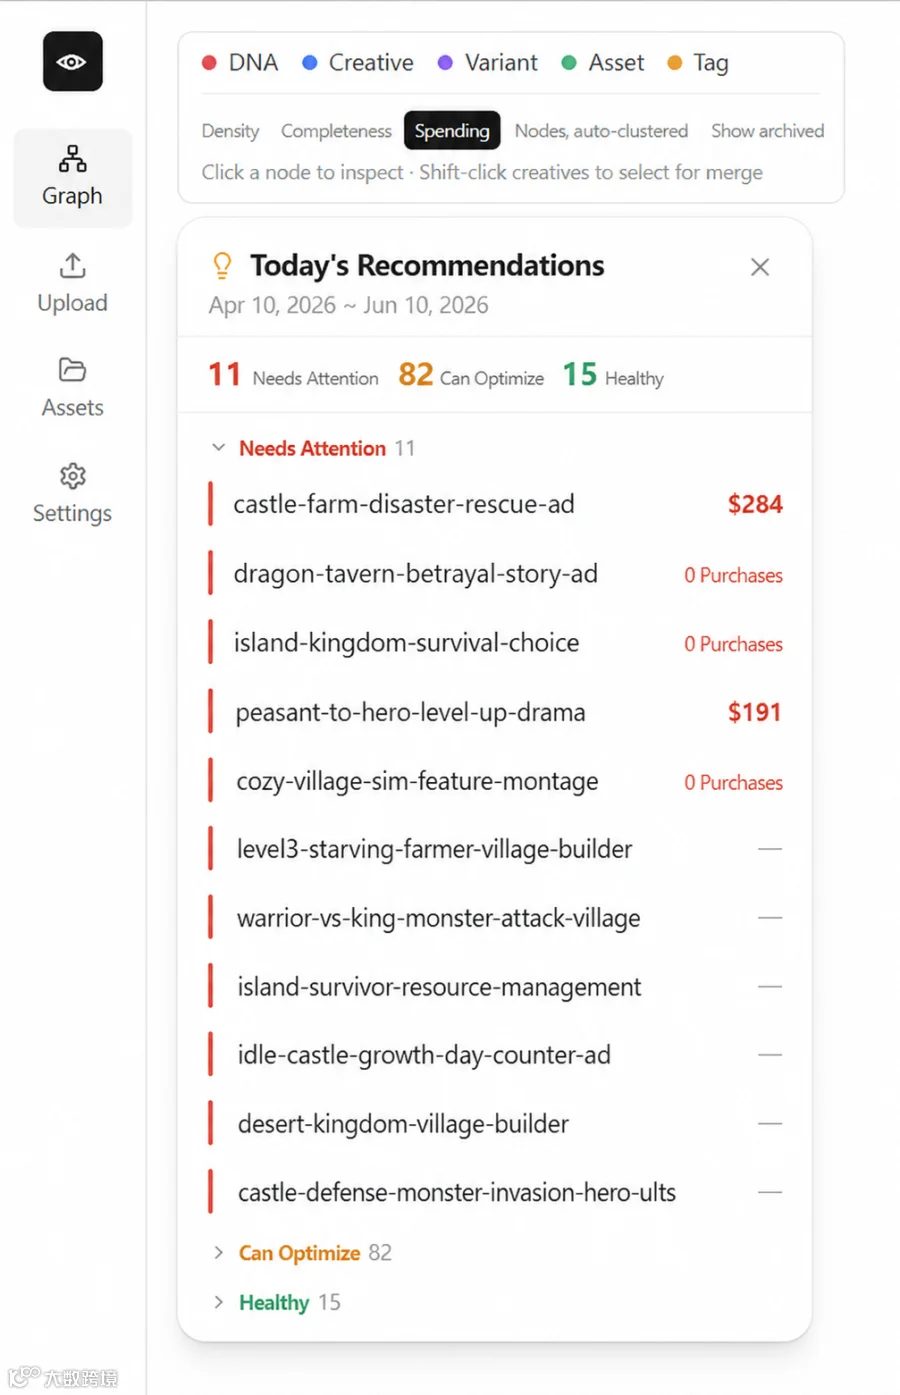
今日建议 - 脱敏演示
安装比想象中简单
前置要求就一个:Docker Desktop。
Windows 直接双击 install.bat,或者手动两行命令。发布版直接拉预构建镜像,两三分钟的事。装完打开 localhost:3000,首页就是创意图谱。
Mac 就一行命令,无需下载仓库:
curl -fsSL https://raw.githubusercontent.com/augura-os/augura/main/scripts/install.sh | bash当然,最方便的就是直接把 GitHub 地址发给你的 AI,让它帮你安装一下。
上手四步:
Settings 里填一个 OpenAI 兼容接口的 Key(GPT、Kimi 视觉模型都行),不上传素材不产生任何调用

Upload 页拖一批素材进去,解析每条几分钟,去喝杯咖啡,图谱会慢慢长出来
打开收件箱,把系统给的候选处理一遍
每周传一次投放 Excel(暂时仅限 Facebook 数据)
由于时间比较有限:Augura 目前是单用户本地工具,没有登录认证和多租户,端口默认只绑本机。别直接把它丢到公网服务器上。团队部署得自己加反向代理和认证层。
结语
做这个东西的出发点其实很简单:单个策划的判断力是有上限的,但一个会积累的团队没有。
人总会流动,项目总会换代,素材总会过时。唯一能穿越这些周期的,是被系统化存下来的判断。
这也是第一步,未来会陆续迭代,整体会朝着半 RSI 推进…
还有一个提示,现在这个框架在处理万级节点的时候会比较卡,可以人工把首批低质素材剔除掉,人为干预一下。
再就是,投放这行也比较杂。做 SLG 的跟做消除的,关注点完全是两码事;跑日韩的跟跑欧美的,素材逻辑也不一样;有的团队看 ROAS,有的团队死磕付费成本,有的还在用留存兜底。
我自己踩过的坑、总结出来的判断规则,放别人团队里未必都适用。
所以 Augura 选择开源(早期版本):
你是优化师或者策划,用就完事了,用得不顺手的地方来提 issue,比夸我们管用。哪个分类不对、哪个建议不靠谱、你们团队的口径系统里调不出来,都可以轻喷。
你会写代码,图谱逻辑、裂变判定、指标配置这些核心模块都在那,欢迎来 PR。投放场景的判读规则,越多真实团队的经验进来,它就越好用。
你不想写代码也不想提 issue,也可以把创意基因共建计划开着—只回传白名单脱敏字段。相当于匿名贡献你的判断数据,让整个社区的判断基准越来越准。当然,介意就一键关掉,绝不偷传。
项目地址再放一遍:
https://github.com/augura-os/augura觉得有用的话,分享一下就是最大的支持了。同时也是想要在这个 AI 时代留下一点自己的印迹。
耳闻者众,目见者寡,亲历者稀。
March to the beat of your own drum.
推荐阅读
深度拆解《Pixel Flow》- 关卡、数值、节奏
深度拆解《Last Asylum》- X 部分手游原型
深度拆解《Clash of Critters》- 塔塔冒险队