搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
深度拆解 Gemini 3.8 Live:一句插话,为什么会牵动整个 Agent 系统
>
深度拆解 Gemini 3.8 Live:一句插话,为什么会牵动整个 Agent 系统
AI科技评论
2026-09-16
2
导读:从异步 Tool 到 KV Cache,实时语音进入了持续计算阶段。
从异步 Tool 到 KV Cache,实时语音进入了持续计算阶段。
作者丨郑佳美
编辑丨岑峰
Google
正式发布 Gemini 3.8 Live 及 Extended Thinking 版本。此次升级不仅提升了语音响应
速度
与自然度,更关键的是将语音、视觉、推理和 Tool Calling 整合进同一条持续运行的链路中。
传统的 Voice Agent 多采用串行流程:用户说完后模型处理,必要时调用
工具
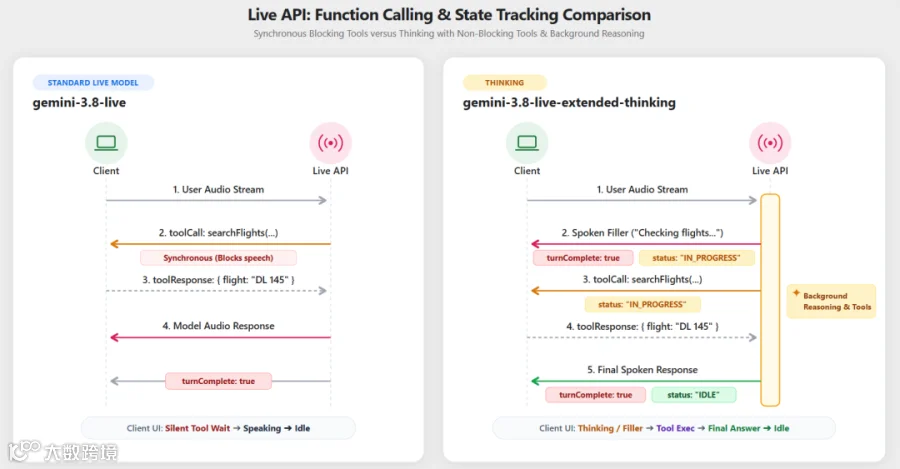
,待结果返回后再继续回答。而新架构将这一链路拆解:用户说话时模型即可处理前序内容,回应过程中后台 Tool 仍可运行,复杂推理不再阻塞前台交互。会话由此从独立请求转变为持续变化的执行环境。
这也带来了新挑战:实时语音要求前台不间断响应,而后台推理和工具任务可能耗时数秒;用户随时可能插话或修改目标,导致旧任务瞬间失效。单纯提升模型速度已不足以解决问题,系统需解决并发调度、旧结果有效性判定、后台计算终止时机及资源分配等难题。
Voice Agent 正进入 Runtime 阶段。语音仅是入口,真正的复杂性下沉至调度、状态一致性和持续计算层。这相当于为 AI 配置了两套系统:毫秒级响应的“脊髓”负责实时语音与情绪跟随,秒级甚至分钟级运转的“大脑皮层”负责深度推理与工具调用。Gemini 3.8 Live 的核心突破,在于工程上实现了这两套不同节奏系统的协同工作。
01
实时语音为何演变为调度问题
传统语音系统虽支持流式输入,但核心执行链通常仍是顺序的:用户表达完毕,模型处理并等待外部 Tool 返回,再生成结果。Gemini 3.8 Live 将各阶段拆解,使单条 Session 内同时存在音频输入、模型生成、后台推理和外部 I/O,它们共享会话状态却有着截然不同的
时间
要求。
语音输入运行在极短的时间尺度上。麦克风持续产生音频片段,VAD 判断说话起止,模型输出需经播放缓冲。若用户在模型回答时重新开口,客户端不能等待完整回答生成,否则几百毫秒的延迟都会让人感知到系统滞后。Google Live API 已将打断机制(interruption)纳入实时链路,新输入可直接中断当前生成。
后台推理和 Tool Calling 则运行在另一时间尺度。数据库查询需几百毫秒,搜索或浏览器操作可能持续数秒,多步推理还会生成新任务。若将这些任务与语音生成置于同一 FIFO 队列,长耗时任务极易造成队头阻塞(head-of-
line
blocking),拖累实时任务。
因此,Voice Agent 需要接近 deadline-aware scheduler 的调度方式:实时音频输入和前台 decode 拥有较短截止期,后台推理可获得更宽松窗口,Tool 任务则根据会话状态动态调整优先级。
新语音事件进入后,Runtime 需允许高优先级工作插入执行路径,并及时释放已失效的旧后台计算资源。此外,还需应对背压(backpressure)问题:若 Runtime 不断将输入、Tool 返回和推理 token 塞回 Context,Session 状态将持续膨胀,导致 prefill 变大、KV Cache 占用增加及 decode 排队时间延长。
Live API 提供的 context window compression 和 session resumption 表明,实时会话已无法按“请求结束即释放状态”的方式运行,而需长期维护、压缩和恢复 Session。
实时语音的延迟不能仅用 Time to First Token 描述,真正影响体验的是整条 latency path:音频调度时机、GPU 获取时间、后台任务是否阻塞前台、新指令进入后旧任务退出速度等。只要 Runtime 任务队列拥塞,Voice Agent 便会显得迟钝。
02
异步 Tool Calling:难点在于结果的有效性
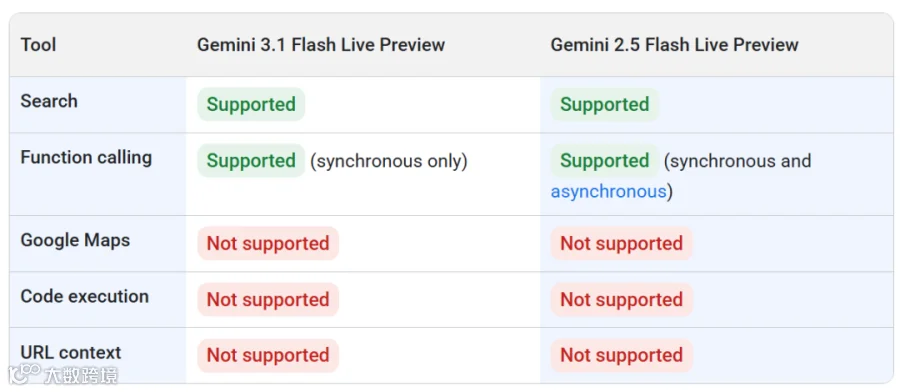
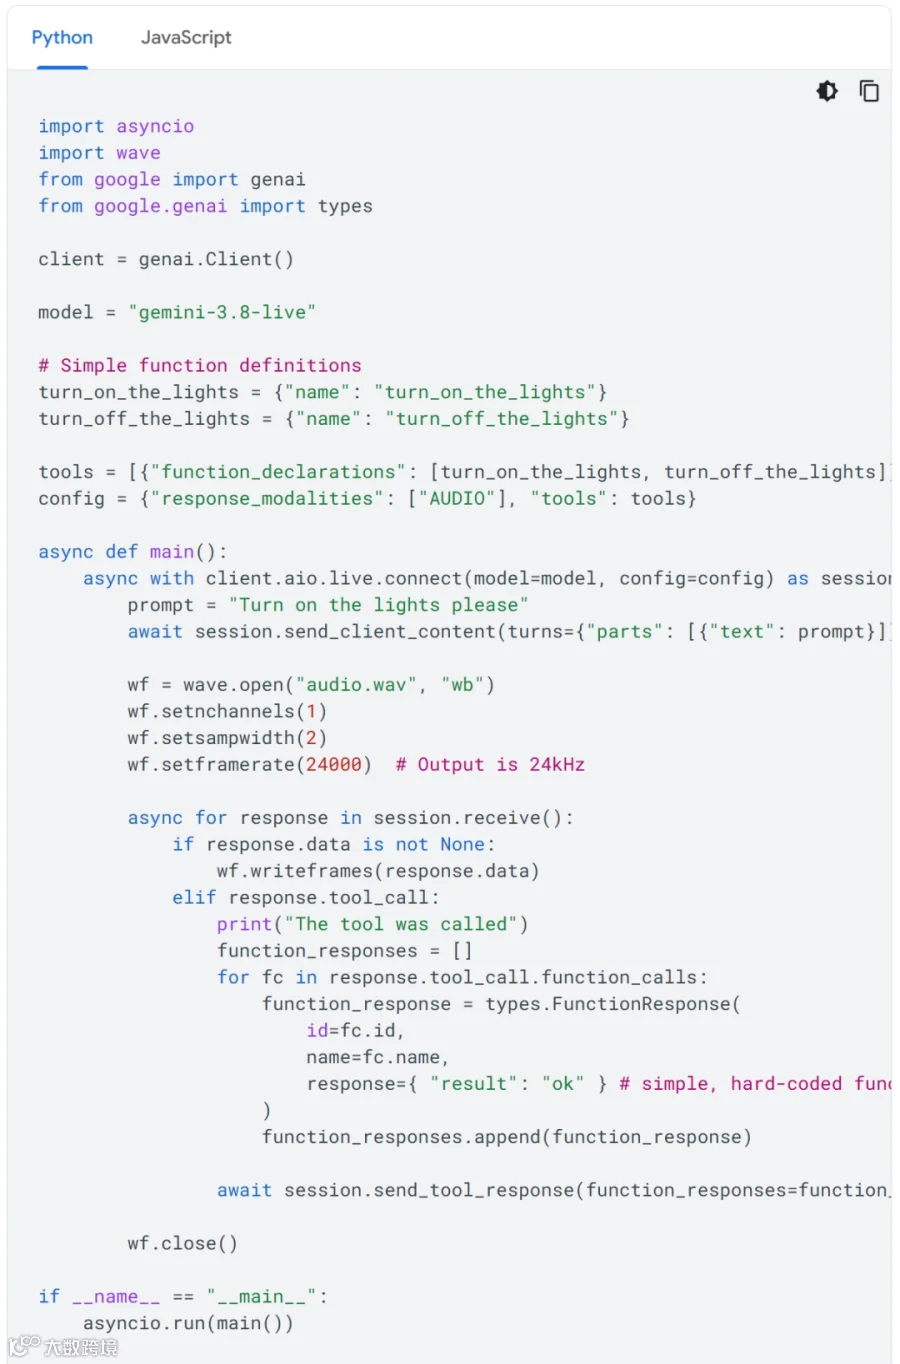
Gemini 3.8 Live 的异步 Function Calling 暴露了新问题。普通同步模式下,模型发起请求后暂停等待返回;异步模式则取消阻塞,工具运行期间模型仍可继续互动。
标准版甚至允许 FunctionResponse 以 INTERRUPT、WHEN_IDLE 或 SILENT 方式进入后续交互,这意味着 Tool Result 从函数返回值变成了异步事件。问题在于,事件返回时,其依赖的上下文可能已不存在。例如用户将查询日期从周五改为周六,几秒后周五的查询结果返回,虽无 API 错误,但已不属于当前任务。
Runtime 不能简单地将 Tool 完成结果写回 Context。合理实现是让每个后台任务携带 task identity 和 session epoch,记录创建时的会话状态。Tool Result 返回后需先经过有效性检查(validity check),确认依赖条件仍成立,再决定是否进入模型上下文。
这类似于数据库中的乐观并发控制(optimistic concurrency control)。系统不为慢 Tool 锁住整个 Session,而是允许多任务并行,在结果提交时检查版本。若用户目标已变,即使任务正确完成,结果也视为过时(stale result)。
核心在于管理 execution 和 commit 两个阶段。模型产生 Function Call 仅代表工作可开始,任务结束也不代表结果一定生效。中间需一层 commit gate,综合判断 Session、任务版本、结果时效及外部副作用。
读取型 Tool 较易处理,旧结果可直接失效。但涉及外部状态修改时,Runtime 会面临分布式系统中的重试歧义(retry ambiguity):网络超时无法说明远端
服务
是否执行了请求。若直接重调,可能导致动作重复执行。因此,Tool Runtime 需稳定的 operation id 和幂等语义(idempotency semantics)。
取消机制也变得复杂:停止模型生成、取消运行中的 HTTP 请求、撤销已在外部系统执行的动作,是三类不同的操作。对于已越过外部边界的任务,Runtime 可能只能记录完成状态,再通过补偿动作(compensating action)修正后续状态。这接近 Saga 模式处理长事务的思路:没有统一回滚,只能持续维护每个外部动作的生命周期。
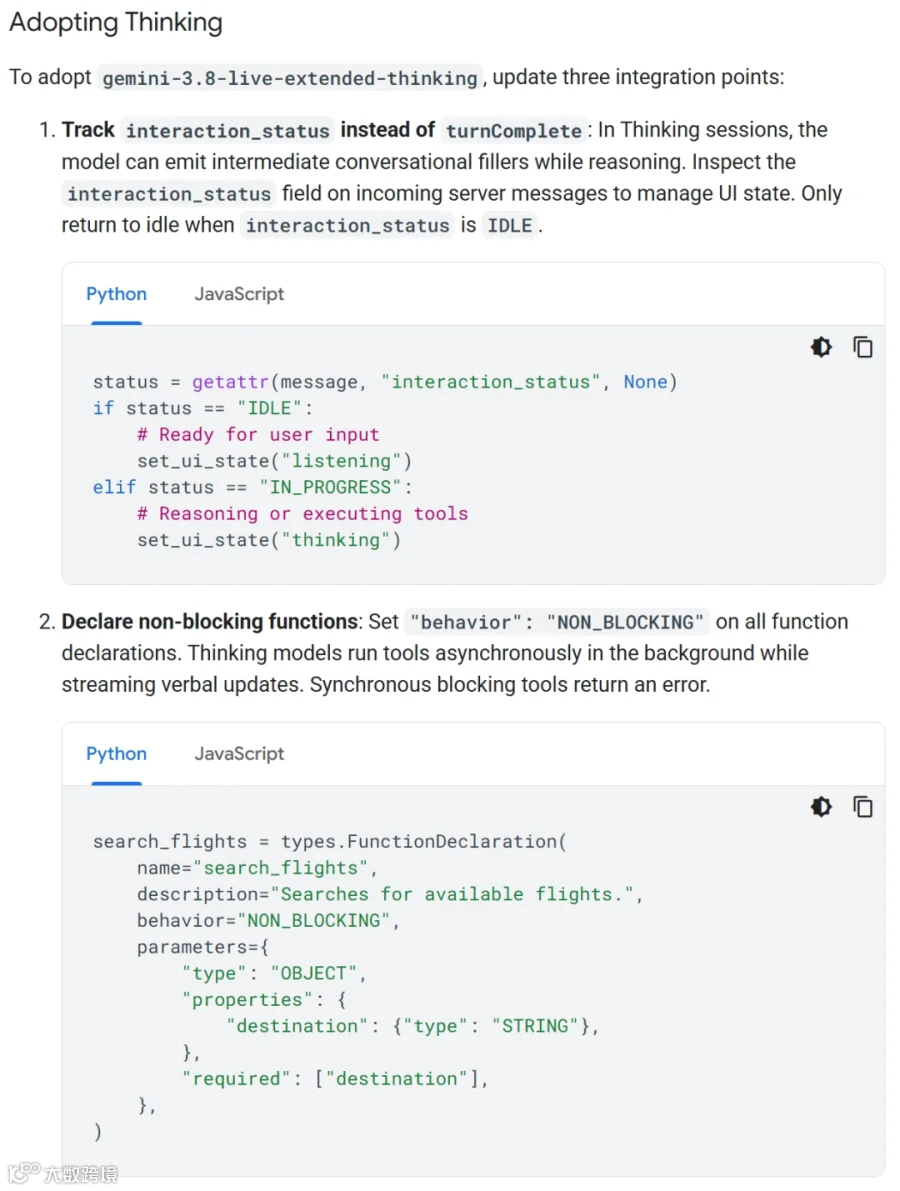
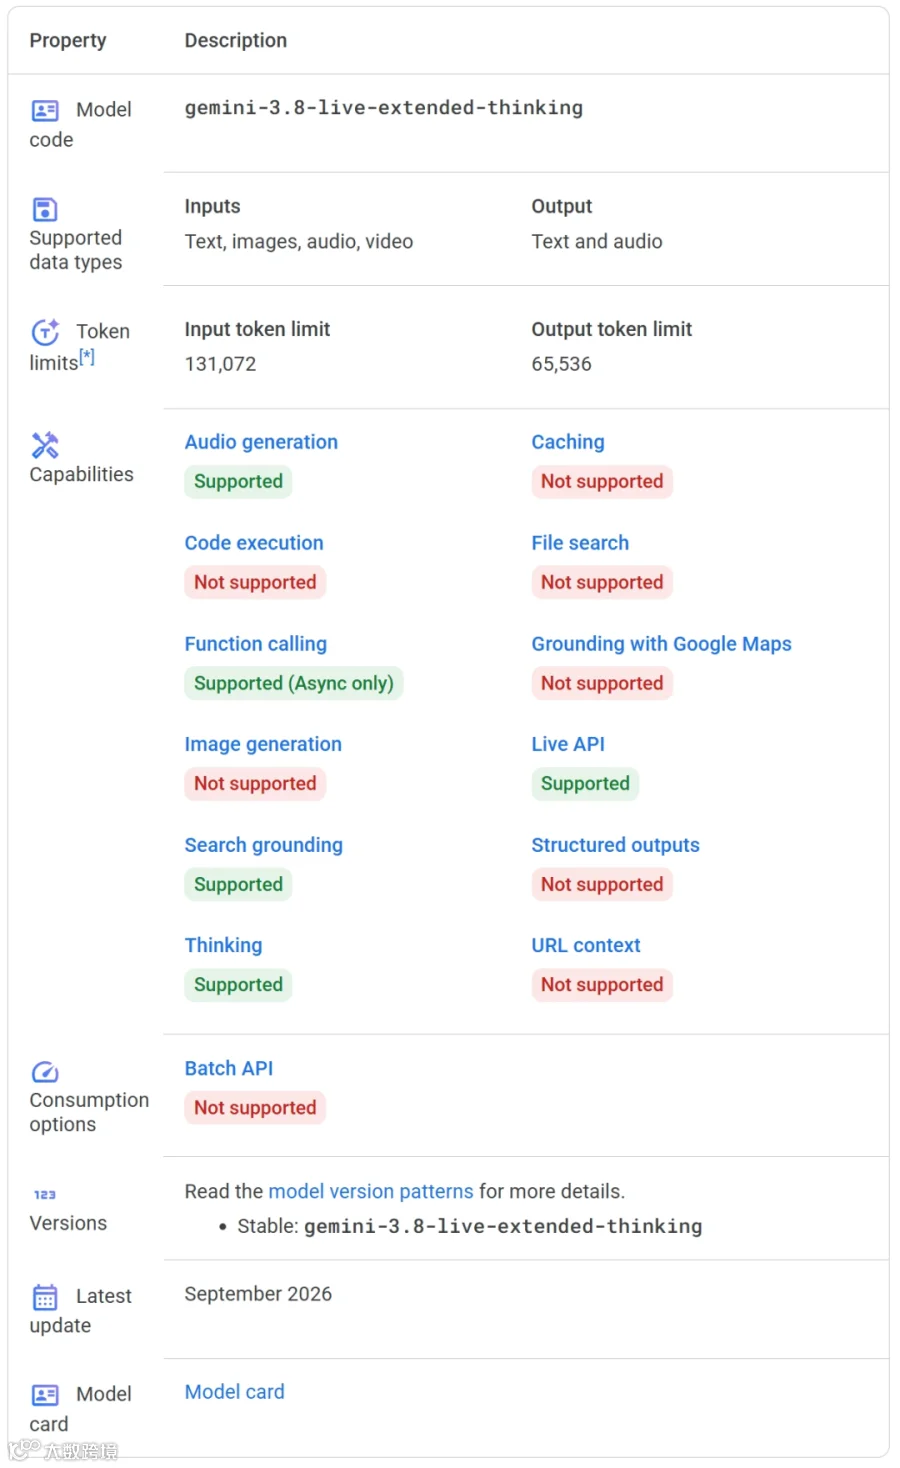
Extended Thinking 进一步拉长了状态机。在 Google 协议中,turnComplete 仅代表单次输出结束;只要后台推理或异步 Tool 仍在运行,interaction_status 保持 IN_PROGRESS,直至任务真正完成才进入 IDLE。
这是巨大的架构变化:一次用户输入不再严格对应一次模型输出,Turn 和 Task 被拆分为两个生命周期。前台可完成多次 utterance,后台仍属同一个 interaction。Voice Agent 的核心状态单位正从消息和回合,转向持续运行的任务图。
03
推理本身成为可调度资源
Extended Thinking 带来的另一层变化发生在 GPU Serving。Google 为 Gemini 3.8 Live Extended Thinking 提供 low、medium 和 high 三档 thinking level,后台推理可在语音会话进行时运行。标准版则采用固定延迟特征的 interleaved reasoning。
从 Runtime
角度
看,reasoning 不再是 Request 内部不可见的计算过程,而成为 Session 生命周期里的长期 workload。实时语音生成要求稳定的 inter-token latency,任何抖动都会导致声音停顿;后台推理则可接受较长执行时间,更在意总计算深度。
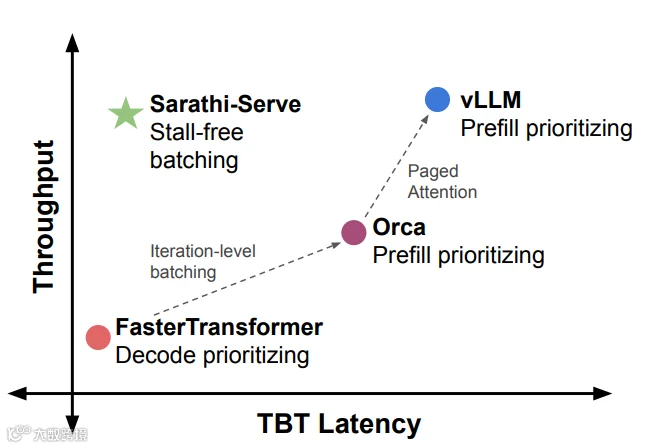
若两类 workload 直接进入同一 continuous batching 队列,大量 reasoning token 会占据 decode slot,长 prefill 也可能干扰前台节奏。因此,实时 Agent serving 需做延迟隔离(latency isolation),让前台 decode 保有较高调度权重,后台推理则被切分为较小的 execution quantum,允许在实时任务进入时被抢占(preemption)。
问题随之落到 KV Cache。后台推理暂停后,其产生的 KV 状态仍存在。保留可快速恢复计算但持续占用显存;驱逐到其他层级可腾出空间但增加搬运成本;直接释放则可能需要重算(recompute)。
随着 Session 数量增加,Runtime 需不断权衡 cache residency、recompute cost 和前台 latency。长时间 Voice Agent 的资源问题与普通 Chat 请求截然不同:Chat 请求结束后临时状态可释放,而 Voice Agent 的 Session 可能持续存在,Context 持续增长,后台 Tool 和 reasoning 也可能随时恢复。若每条 Session 长期保留较大 KV working set,服务容量将迅速受限于显存和内存带宽。
Thinking level 可理解为一种 resource budget。系统可根据任务复杂度决定 reasoning 使用的计算窗口,并根据 GPU 压力动态调整后台任务节奏。当用户修改目标后,与旧目标绑定的 reasoning branch 应尽快退出,避免为失效路径消耗算力。
更进一步,实时语音天然适合推测执行(speculative execution)。用户话语未结束时,模型已获部分语义,Runtime 可提前执行低成本 reasoning 或准备 Tool。若后续输入与已有路径一致,则减少等待;若用户改变方向,则丢弃错误分支。
这相当于用额外计算换取交互延迟,但必须设置明确的 commit boundary。内部 reasoning 可提前跑,但涉及真实外部状态变化的 Action 不能提前提交,否则错误推测将从计算浪费变成真实世界的错误操作。
尽管 Google 未公开具体的 continuous batching、KV eviction 或 GPU preemption 策略,但只要后台推理、实时 decode 和异步 Tool 长期共存于一条 Session 中,这些 serving 层问题就无法继续隐藏在单次模型调用之后。
04
Agent 开始需要自己的 Runtime
Gemini 3.8 Live 将 Voice Agent 推向了新的系统形态。一条会话中同时运行实时音频、模型生成、后台推理和外部 Tool,且用户可随时改变任务方向,原有的 Request-Response 架构已难以覆盖这种执行模式。
模型负责理解、推理和产生 Action,Runtime 则逐渐承担另一部分工作:维护任务生命周期,判断异步结果何时提交,在新输入到来时中断旧计算,并协调 GPU、KV Cache、Context 和外部 I/O。
沿此路线发展,
Agent Runtime 将越来越像操作系统与分布式运行时的结合体
。前台交互有 deadline,后台任务有生命周期,外部 Action 需 commit semantics,推理资源需持续调度。
用户的一次插话,在界面上只是多说了一句话,在系统内部却可能意味着任务版本推进、Tool Result 失效、reasoning branch 终止以及 GPU 调度重新排列。
实时语音率先暴露了这些矛盾。浏览器 Agent、桌面 Agent、机器人和长期在线的数字助手,只要开始持续感知环境、运行后台任务并修改外部状态,也会遇到同类问题。
当 Agent 从“回答问题”走向“持续执行”,Runtime 就不再只是模型外的胶水代码,而将成为整套 Agent 系统的核心基础设施。
如果说 2024 年大模型比拼的是“炼金”(谁把模型训得更强),那么 2026 年比拼的则是“精算”(谁把 Runtime 管得更好)。单体智力的红利正在见顶,下一步的胜负手不在于模型还能多聪明,而在于谁能先造出一套撑得住千万级并发、还带“逻辑刹车”的 AI 数字大脑。
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容
8963
粉丝
0
关注
在线咨询
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
总阅读
248.6k
粉丝
0
内容
9.0k








 AI科技评论