“程序正常退出”。理论上,这行终端提示意味着科研代码运行无误,但其背后可能隐藏着不易察觉的逻辑错误。
编译器未报错、计算按时结束、输出文件完整,然而当研究者将新旧结果对比时,发现关键物理量已偏离参考值。仅凭“程序正常退出”这一表象,AI 无法判断修改是否符合科学要求。
名为 ScienceIDE 的项目正试图解决这一痛点。该项目由牛津大学、斯坦福大学等全球 20 所顶尖高校联合研发,AItonomy Foundation 主导发布,PhAI Labs 与 Qwen 参与支持,沐晨科技提供联合研发与技术支持。ScienceIDE 旨在将科研代码、运行环境及科学验收规则整合为可执行、可验证的任务,让模型在真实的“执行 - 犯错 - 修正”循环中,依据科学结果获得有效反馈。
团队数据显示,在 1,769 个有完整记录的缺陷任务中,高达 55.2%(976 个)的程序能顺利编译并运行至结束,但最终给出的科学结果却是错误的。这些“成功的失败”若被用作训练奖励,将误导模型走向错误方向。ScienceIDE 的核心目标,正是让真实的科学结果约束 AI 行动,探索“科学反哺智能”的新路径。
图丨相关论文(来源:AItonomy Foundation)
ScienceIDE 赋予了"IDE"(集成开发环境)新的内涵:它不仅整合编写、运行和调试功能,更纳入了科学验证与模型学习机制。其核心在于开发模型在真实科学任务中“行动、观察并自我修正”的能力,使科学成为训练智能的天然环境。
最危险的失败往往看似“成功”
假设 AI tasked 修正代码中的数值偏差,它修改后编译运行无报错,数据也顺利生成。然而,真正的问题常隐藏在程序不主动报错的细节中:变量被重复归一化、重启文件状态读取错误、时间基准约定冲突等。这些逻辑陷阱虽不影响程序运行,却会导致科学结论失效。
实验表明,AI 处理公开物理常数或标准公式较为容易,但在面对代码库特有的内部状态(如时间步推进逻辑、模块间归一化责任、断点重启数据保存时机及单位换算层级)时极易出错。这正是通用代码 Agent 与科研领域 Agent 的本质区别:后者不仅要恢复功能,更要确保科学结果经得起检验。
常规软件工程拥有编译器报错、单元测试及 CI 系统构成的低成本试错环境,如 SWE-smith 研究利用自动化任务训练 Agent,Google DeepMind 的 AlphaEvolve 通过自动化评估筛选优化方案。然而,科学计算缺乏通用的“标尺”,不同学科对观察对象与容差范围的要求各异,简单的确定性测试无法适用于气候模拟或含随机扰动的物理系统。
科学研究提供的不仅是论文与代码,更是包含“过程证据”的宝贵资源:哪些尝试改变了结果、哪些修正恢复了守恒、哪些假设被事实推翻。ScienceIDE 致力于将这些散落在日志与经验中的过程系统化,转化为模型可直接学习的训练材料。
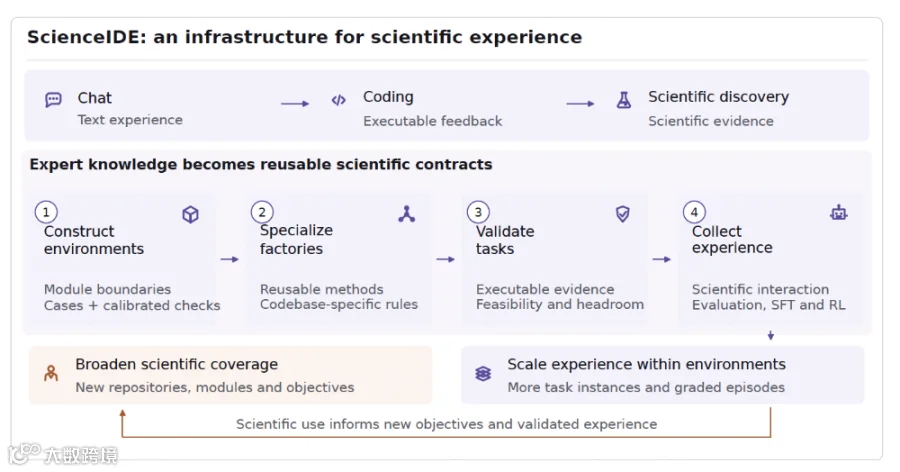
图丨科学知识成为可执行环境(来源:AItonomy Foundation)
训练 AI 前先校准“裁判”
要将科学构建为可靠的训练环境,必须确保题目有效且评分规则能区分优劣。ScienceIDE 将庞大的科研代码库按科学职责拆分为若干模块,并将运行环境、算例及验证流程封装为独立的“环境”。这些容器不仅封存技术外壳,更注入了专家的科学判断。
针对确定性任务,验证器直接比对输出;面对随机性或混沌效应,则需专家定义具有物理意义的观测量(如统计特征、守恒量),并设定合理容差。这些规则一旦固化为可执行代码,即可反复调用,实现标准化验证。
图丨ScienceIDE 从科研代码库到智能体经验的四步工作流(来源:AItonomy Foundation)
项目中的“任务工厂”可主动引入缺陷以生成修复任务,但自动生成并非终点。测试显示,在天体物理软件 PLUTO 的候选缺陷中,58.7% 并未引发可观测的科学异常。若直接使用此类无效任务,模型无需修改即可得分,导致训练失效。因此,每道任务均需经过严格的对照实验:确认缺陷程序存在可测量的科学偏差,且参考修复方案能恢复正确行为,同时严格区分基础设施故障与解题失败。
在此基础上,Agent 进入环境经历完整闭环:阅读代码、提出方案、编译计算、检查结果并调整动作。系统详细记录行动与反馈链条,包括操作细节、计算反馈、指标进展及放弃推测的依据。这种分级反馈机制使得失败本身也能转化为有价值的学习经验,而非简单的“未通过”标签。
从学会解题到掌握能力
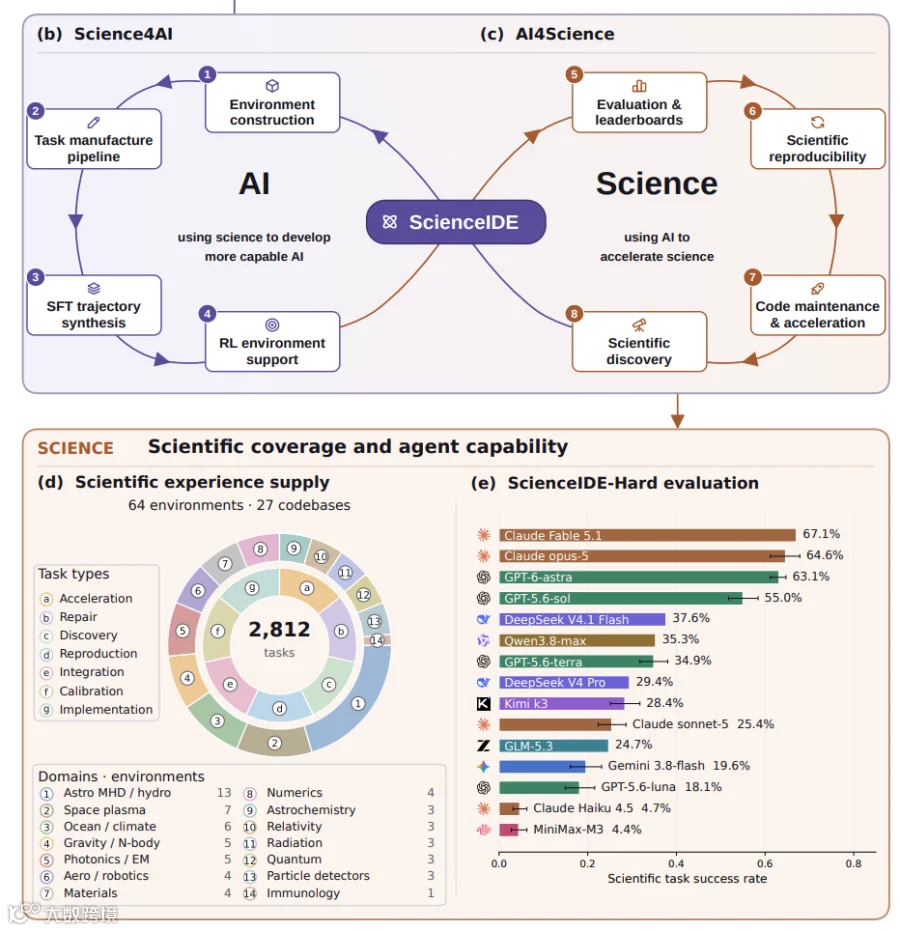
截至 2026 年 9 月 16 日,ScienceIDE 已收录来自 27 个开源代码库的 64 个环境定义,生成 2,812 个具体任务,涵盖天体物理、海洋气候、空间等离子体、材料科学等 14 个学科领域。
图丨ScienceIDE 连接“用科学训练 AI"与“用 AI 加速科学”的双向闭环(来源:AItonomy Foundation)
这些任务揭示了科学训练环境的隐性挑战:任务失效、验证误判、算力门槛及模型投机等。ScienceIDE 不仅测量模型能力,更持续审视题目与规则的有效性,致力于将科学探索经验规模化生产并转化为训练养料,超越静态基准测试的局限。
尽管目前已有监督微调与强化学习的接入接口,但完整的训练收益数据仍需进一步验证。关键在于确认模型是记住了特定修复技巧,还是真正学会了在陌生代码库中追踪状态、构建假设并依据证据修正思路。这需要严格的分布外实验来证实“科学训练下一代 AI"的可行性。
从 AI 做科学到科学训练 AI
PhAI Labs 支持 ScienceIDE,基于“科学经验反哺智能”的判断。在其 Discovery Foundation Models(DFM)框架中,目标从解决问题升级为识别未知、形成假设、设计干预并依据证据修正方向。在此范式下,答案不再是终点,研究价值取决于是否深化了对问题的理解并优化了后续探索。
视频丨Discovery Foundation Models(来源:PhAI Labs)
ScienceIDE 为 DFM 构想提供了落地的切入点:从逻辑闭环的科研代码任务入手,训练 AI 学会面对客观结果、解读试错反馈并调整行为。这是从“修补代码”迈向“开放式科学发现”的必经之路——学会依据客观事实修正主观判断。
对于大模型研发团队,ScienceIDE 提供了对比 Agent 架构、沉淀高价值轨迹的公共基座;对于科研团队,过往成熟的代码、算例与验收指标可转化为可执行的验证规则,使隐性经验得以复用。科学团队由此有机会成为下一代 AI 训练经验的生产者。
从依靠书本存量知识,到在行动执行中迭代,再到如今将科研中的行动、检验与修正持续转化为学习经验,ScienceIDE 迈出了关键一步。终端上的“程序正常退出”仅代表指令执行完毕,而科学结果能否站得住脚需经物理规律审视。AI 能否从这种严谨审视中汲取养分持续进化,才是 ScienceIDE 想要回答的核心命题。如果科学能够生产训练智能的经验,那么一次研究的价值,必将超越其最终答案。
技术报告:https://phai-labs.com/papers/scienceide/
网页链接:https://aitonomy.org/projects/scienceide
GitHub:https://github.com/aitofound/ScienceIDE
Hugging Face:https://huggingface.co/collections/AItonomy/scienceide-model-series



 DeepTech深科技