做出ChatGPT核心研究的人今天掀桌:大模型搞不定自动化,新架构提速200倍且输出免费 AI寒武纪
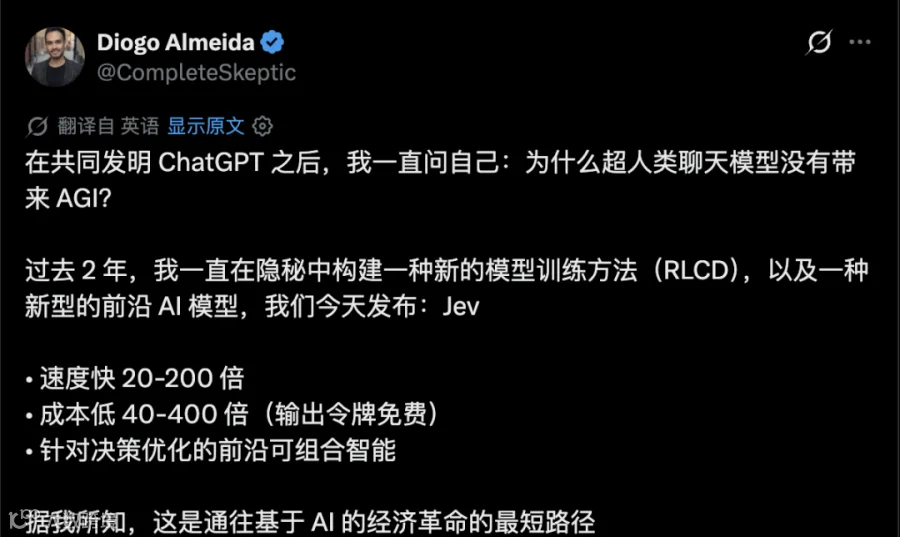
语言模型的对话能力已超越人类数年,但业务自动化的瓶颈究竟何在?前 OpenAI 研究员、ChatGPT 核心方法开发者 Diogo Almeida 历时四年钻研,终于给出答案。在摒弃纯聊天范式后,其创立的 TypeSafe AI 正式发布首款专为自动化设计的 System One 模型——Jev。
Jev 放弃了传统的长文本逐字生成,转而直接输出软件可执行的结构化决策。这一架构变革带来了显著优势:速度 提升两个数量级,输出成本归零,并从数学层面根除了类型错误与幻觉。简而言之,Jev 能接收无结构状态输入,直接返回带概率置信度的强类型决策。
两代前沿模型深度对比
传统大语言模型与 Jev 在底层设计上存在本质差异:
优化算法与目标
传统模型依赖人类反馈强化学习(RLHF)或可验证奖励强化学习(RLVR),旨在优化人类偏好或特定答案;Jev 则采用专为校准决策设计的强化学习(RLCD),核心目标是优化决策校准度,确保在判断任务中提供真实可信的概率。
输入输出与采样机制
在格式上,传统模型侧重连续对话消息,输出自由字符串,需后续解析且易出错;Jev 侧重结构化程序状态,输出预定义的强类型数值,杜绝类型错误并自带置信度。在采样方式上,传统模型采用自回归单 Token 生成,而 Jev 实现并行采样,单次查询即刻返回所有结果,极度契合硬件加速。
成本、速度与可靠性
成本方面,传统模型输入价格通常在每百万 Token 0.2 至 10 美元之间,输出更贵;Jev 输入仅需 0.042 美元,输出完全免费。速度上,传统模型端到端耗时 3 秒至 329 秒,Jev 仅需 70 毫秒至 500 毫秒,提速 40 至 200 倍。此外,Jev 严格校准置信度,解决了传统模型过度自信且结果不稳定的痛点。
适用场景
传统模型擅长有人类把关的聊天、辅助编程及原型演示;Jev 则专为嵌入软件系统设计,适用于分类、路由、评分、大规模 Map-Reduce 分析、实时系统控制以及作为大模型的安全护栏。
实测数据与技术细节
TypeSafe AI 团队公开了多项对比验证及测试细节,展示了 Jev 在实际应用中的表现。
实时并排对比
测试显示,Jev 接收输入后可瞬间并行返回所有概率,而对比组 GPT-5.6 Terra 仍处于逐字推理阶段。测试选用短密集段落以突显 Jev 的并行采样优势,并以默认推理模式的 GPT-5.6 Terra 为基准(两者智能水平接近)。除在一处存在歧义的用户流失概率等级上略有分歧外,其余判断高度一致。
真实工作流评估
团队设计了全新的评估方法:将模型嵌入生产级业务工作流代码,以 GPT-6 Astra 和 Fable 5.1 的平均判断为基准。在四个实际业务工作流测试中,Jev 占据帕累托最优前沿,准确率达约 68%,成本较 OpenAI、Anthropic、Google 等主流模型降低 100 至 1000 倍。
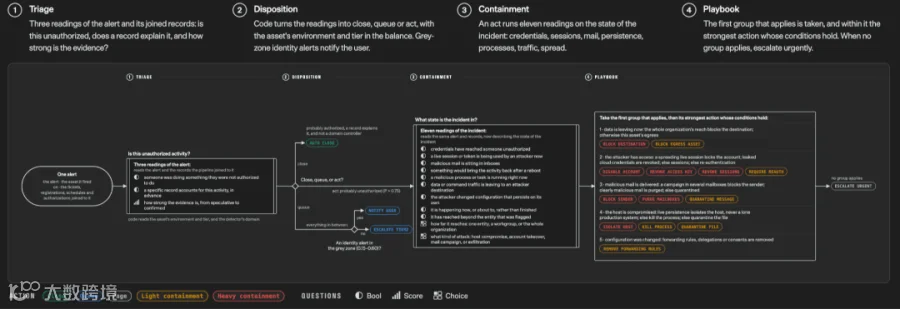
以最简单的“分流、处置、遏制、剧本”工作流为例,该流程包含大量独立解耦问题与细粒度概率分支。团队指出,宣传中提到的提速 193.6 倍、降本 444.6 倍即源于此测试上限。需注意的是,参考标准采用了竞品模型均值,且对比中大模型使用了适配层限制输出规范,这可能导致大模型调用成本上升,从而凸显 Jev 的优势。
杜绝幻觉与类型错误
OpenRouter 统计数据显示,现有大模型的结构化输出错误率在 0.58% 至 45.5% 之间,工具 调用错误率在 0.7% 至 17.2% 之间。相比之下,Jev 在这两项指标上的错误率均为 0%。得益于底层锁死的 Schema 模式匹配机制,Jev 从数学原理上彻底杜绝了类型错误与幻觉。
应用场景演示
毁灭战士(Doom)游戏控制
团队将 Jev 接入 Doom 游戏,每秒进行 10 次决策判断,每小时成本仅约 7 美元。测试输入为游戏的结构化文本状态数据而非图像。尽管专用非 AI 脚本可能表现更佳,但该演示充分证明了 Jev 极快的指令跟随与响应速度。
维基百科 竞速(Wikiracing)
在该任务中,模型需从一个词条出发,仅通过点击链接跳转至目标词条。Jev 支持最高 255 个高基数选项,面对海量链接时采用“先独立打分再做选择”的两阶段处理策略。对比结果显示,Jev 完成任务所需的跳跃步数明显更少。
研发理念与命名渊源
命名含义: "System One"源自丹尼尔·卡尼曼《思考,快与慢》中的系统 1,代表快速直觉反应;"Jev"取自经济学家威廉·斯坦利·杰文斯(杰文斯悖论),寓意算力成本每降一个数量级,将引爆成倍的自动化需求。
算法创新: 鉴于 RLHF 适合聊天但不适合严密自动化,RLVR 仅适用于可代码判分的问题,团队研发了全新的 RLCD 算法,以决策校准度为核心训练目标。
模型定位: Jev 并非小型大语言模型,而是完全不同的架构体系。团队拒绝刷榜公开基准测试,认为这会扭曲模型能力,建议开发者在真实场景中建立专属评估集。
数据安全: TypeSafe AI 作为数据研究实验室,所有训练数据均由团队自研构建,承诺绝不使用用户数据进行训练。目前,Jev 已开放早期预览申请。 关注
在线咨询




 AI寒武纪