

专注 AIGC 技术的专业社区,关注大语言模型(LLM)的发展和应用落地,聚焦 LLM 及 AI 技术的市场研究和开发者生态。
想象这样一个场景:你正在与 AI 讨论出行计划,话音未落它已开始查询航班;你将镜头对准桌上设备,它能依据画面实时回应;即便后台任务尚未完成,它也不会突然沉默,而是主动告知“正在处理”。
这正是 Google 于当地时间 9 月 15 日发布的 Gemini 3.8 Live 系列旨在实现的交互体验。此次更新包含两款模型:Gemini 3.8 Live主打实时、低延迟的语音交互;Gemini 3.8 Live Extended Thinking则进一步强化了后台推理与多步骤任务处理能力。
消除交互等待,实现连续对话
传统语音助手的交互逻辑多为“用户说完—AI 识别—给出回答”。一旦涉及查资料、比价或安排日程等复杂任务,AI 往往需等待工具返回结果,导致用户无法判断系统是处于思考状态还是已卡死。
Gemini 3.8 Live 致力于隐藏这段“空白期”。据 Google 开发者文档显示,该模型支持文本、图片、音频和视频多模态输入,具备实时音频流、交错式推理及异步函数调用能力。这意味着 AI 可在用户持续讲话时处理新信息,或在对话中无缝调用外部工具,将交互从“一问一答”升级为连续交流。
此外,Google 宣称该模型能自动识别并切换 97 种语言。不过需注意,实际效果仍受口音、环境噪声及具体语言组合的影响。
Extended Thinking:从问答工具进阶为任务助手
Gemini 3.8 Live Extended Thinking 的升级更为显著。当面对复杂规划、数据分析或耗时较长的工具调用时,该模型可在后台持续推理,并通过语音向用户实时反馈进度。
例如,当用户提出“制定周末上海行程”的需求时,模型可先确认预算与时间,随即并行查询交通、酒店及景点信息。在等待数据返回期间,模型不会静默,而是维持对话互动。
这一特性标志着语音 AI 正从单纯的“问答工具”向“任务助手”演进。当然,模型能否精准完成任务,仍取决于工具接口的可靠性、数据的及时性以及对用户意图的理解深度。
双模型定位:适配不同工作状态
根据 Google 的开发说明,两款模型各有侧重:
- Gemini 3.8 Live:适用于快速响应场景,如语音搜索、客服分流、语言练习及基础设备控制。
- Extended Thinking:更适合多步骤复杂任务,包括技术排障、深度出行规划、复杂信息检索及代码辅导。
目前,两款模型已接入 Gemini API 和 Google AI Studio。企业侧能力主要以私有预览形式提供,普通用户的具体可用功能则取决于所在地区、产品类型及订阅等级。对开发者而言,这意味着语音应用不再局限于“语音转文字后处理”,而是可以直接构建实时、双向且具备工具调用能力的语音智能体。
核心挑战:稳定性胜过榜单成绩
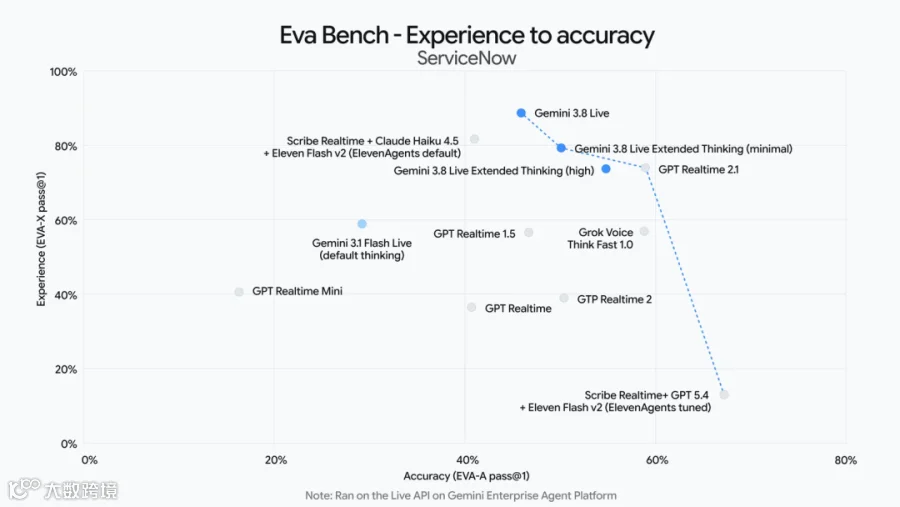
Google 引用了 Artificial Analysis、τ-Voice 和 Sierra 等机构的评测数据,显示 Extended Thinking 在部分语音和智能体测试中表现优异。
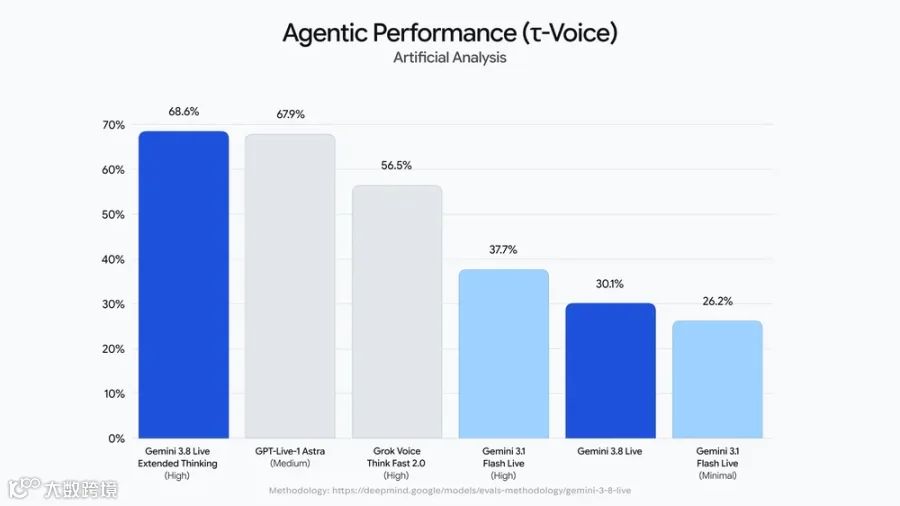

然而,对于语音智能体而言,榜单成绩仅是参考维度之一。用户更关注的是:AI 是否会出现听识错误、能否妥善处理打断、工具调用是否准确,以及在遇到异常时能否清晰说明。特别是在客服、办公和车载等高风险场景中,一次错误的执行操作远比回答错一个知识点后果严重。因此,随着语音交互无限接近真实工作流,其对系统稳定性、权限管理及数据安全的要求也水涨船高。
Gemini 3.8 Live 系列的核心价值,不仅在于 Google 公布的各项评测指标,更在于其尝试重塑人机交流范式:AI 无需等待用户说完,也不必在后台处理时保持沉默,而是能够实现“边听、边想、边做”。
这条技术路线最终能走多远,尚需经受真实用户体验与第三方测试的检验。但可以确定的是,语音 AI 的发展方向已从单纯的“会回答”迈向“能协助完成事务”。