


作为多学科、系统化的AI4S工程实战宝典,“AI4S实战派”栏目立足开放生态、持续演进,致力于“手把手”带你率先跑通科学大模型,将复杂、多学科的AI模型转化为能跑、能用、能创新的生产力工具,帮助科研人员和开发者零门槛上手,加速科学新发现。
一条氨基酸序列,如何决定了其折叠后形成的蛋白质三维结构?
9月10日晚,《AI4S实战派》生命科学专题第四场直播中,南开大学统计与数据科学学院教授郑伟带来以《从序列到三维结构:AlphaFold范式与后AlphaFold时代》为主题,梳理了蛋白质结构预测领域近几十年的发展脉络,其博士生倪文韬还在线演示了 AlphaFold3 的服务器版与本地版使用。
郑伟曾带领团队多次获得被誉为“蛋白质结构预测领域的奥林匹克竞赛”的国际赛事CASP的冠军,累计在Nature Biotechnology、PNAS等高水平SCI期刊发表文章60余篇、被引4600余次,算法已服务100个国家超10万用户。对入门者来说,他带来了一条从算法创新到科研落地、再到全球社区影响力的参考路径,本场直播回顾值得一读。

(点击文末“阅读原文”,也可在B站“上海科学智能研究院”温故知新)
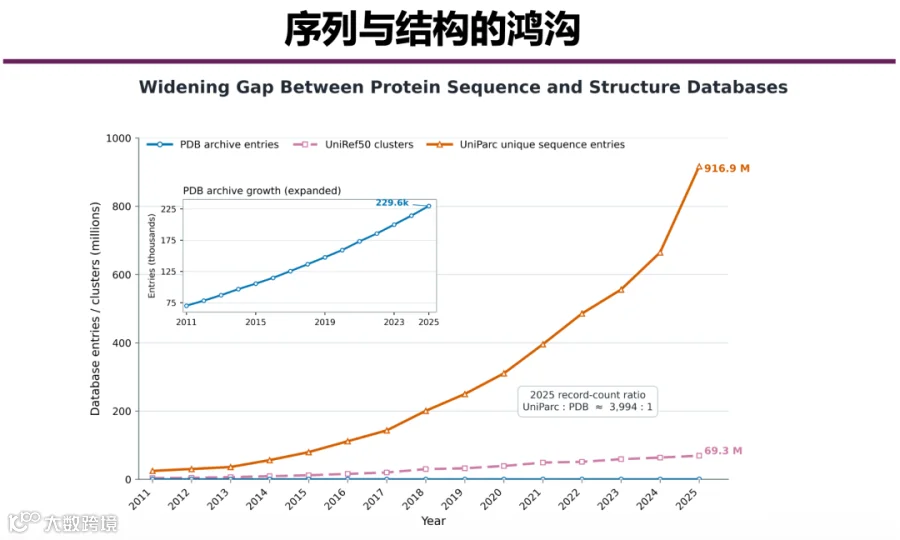
为何需要结构预测?4000:1的鸿沟
获取蛋白质三维结构的实验手段主要有三种:X射线晶体学、核磁共振(NMR)、以及2000年后迅速发展的冷冻电镜。从伦琴发现X射线,到第一次用它解出蛋白质结构,人类花了约六十年;三种技术加起来,积累了超过百年。
但它们都很贵、很慢。
而测序技术却在飞速发展。截至2025年,UniProt收录的序列已近十亿量级,PDB中真实解析的结构却只有二十多万个。两者比例达到将近4000:1,且这道鸿沟还在持续扩大。
换句话说,我们已知的蛋白质序列里,只有约四千分之一拥有真实结构。
于是问题就变成了:能不能用计算方法高通量地获得结构?对应的描述其实颇为简单:输入一串氨基酸字母,输出所有原子的三维坐标。但做起来,难了将近六十年。
AlphaFold之前:三条主流路线和CASP
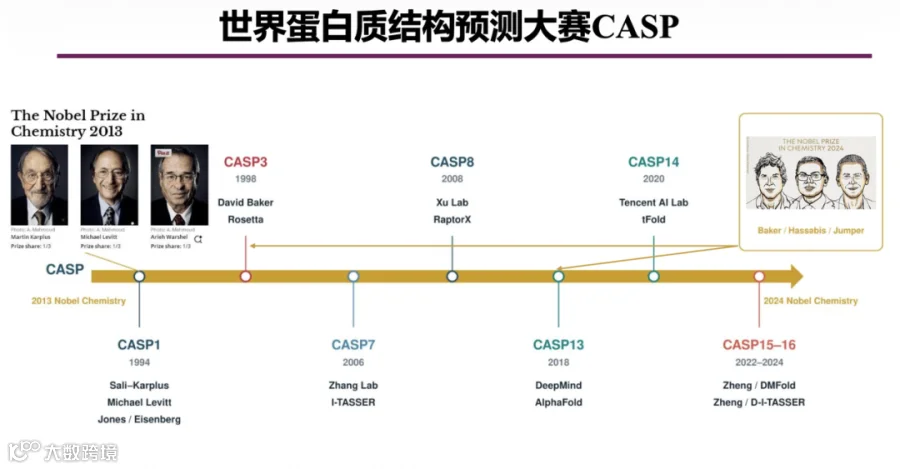
郑伟把2020年之前的结构预测方法,梳理成了如下几条路线。
同源建模(1970s):进化上相近的序列,结构往往相似。若未知序列与PDB中某结构高度相似(如人与猪的血红蛋白),就把两条序列对齐、把已知坐标“赋值”过去。代表工具是Modeller。
基于物理力场的从头建模(1980s):找不到模板怎么办?既然蛋白质也是微观粒子集合,就让它在力场中做能量最小化。代表是分子动力学力场CHARMM,其开发者Martin Karplus获2013年诺贝尔化学奖。
Threading(1990s):人们发现有些蛋白结构很像、序列相似度却极低。于是不再看单个氨基酸像不像,而是看它在同源家族中的氨基酸成分,据此完成对齐。
片段组装式从头预测(1990s):在物理力场之外加入统计力场。代表是David Baker的Rosetta,该工作把整条蛋白切成小片段,逐个检索候选结构,再通过模拟退火拼装组合。
方法多了,谁最好?1994年,马里兰大学的John Moult发起了CASP。 组委会收集尚未公开的真实结构,把序列分发给全球课题组,三个月后交由独立第三方评测;评测人不知团队身份,参赛者看不到真实结构,全程双盲。正因这份权威性,CASP至今已举办十七届。2018年CASP13,DeepMind带着第一代AlphaFold首次登场。
共进化:AlphaFold背后的基石
在讲AlphaFold2之前,必须先理解一个关键概念——共进化(Coevolution)。
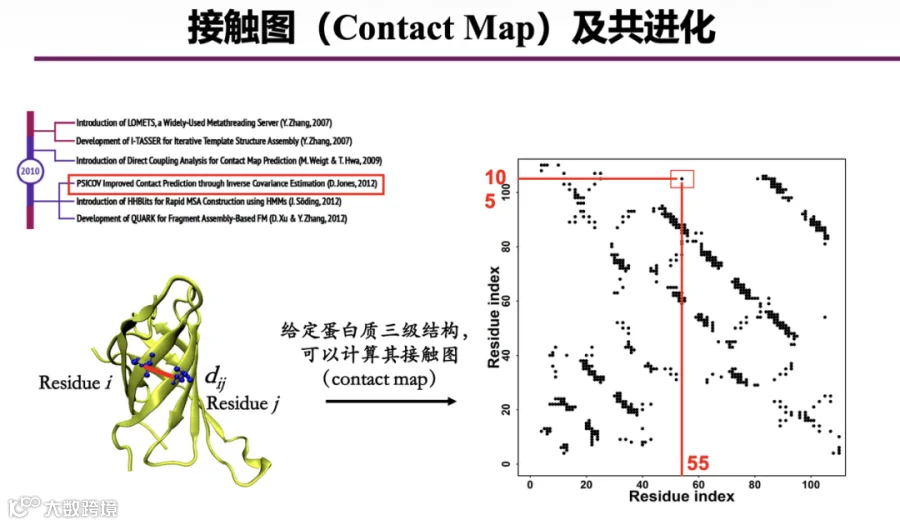
先看“接触图”(Contact Map):拿到三维结构后,任意两个氨基酸的距离都可算出,定义小于8Å为”接触”,就能把三维结构转成一张二维点阵图。
反过来问:知道接触图,能否恢复三维结构? 2010年前后就已可以实现,精度还相当高。
那怎么从序列预测接触图?答案是共进化。把查询序列在UniProt中检索、对所有物种的同源序列做多序列比对(MSA),会发现:在空间中形成接触的两个氨基酸,往往在同源序列中一起发生突变。这个变成Y,那个就跟着变。
2010到2020年,领域主攻方向就是提取共进化特征、用深度学习预测接触图与距离图,再用这些约束引导折叠。郑伟强调:共进化是这个领域的关键基石。直到今天,生物分子结构预测的底层机制大多仍建立在它之上。
AlphaFold2:端到端框架和置信度
从1994到2018年,领域精度经历了二十多年缓慢爬升;而从CASP13到CASP14,在2019-2020年的两年间,AlphaFold2的跃升超过了此前十几年的总和,在总分排名上一骑绝尘。
它做对了什么?
端到端框架。 此前主流是“两阶段”:先预测空间约束,再用力场引导折叠。AlphaFold2把所有约束放进统一网络,输入序列、直接输出三维坐标。架构堆叠48层Evoformer,同时更新多序列比对表示(MSA Representation)与配对表示(Pair Representation),再交给结构模块生成坐标。
值得注意的是,它并没有脱离共进化框架,依然依赖MSA与模板。郑伟团队还做过一项分析:AlphaFold 2的pair representation中编码了丰富的残基对几何信息,其通过距离分布预测头可以预测残基间距离分布,他们测试发现其精度在当时同类方法中最高。换句话说,不管是不是端到端,它在空间约束预测上本来就遥遥领先。
另一个同样重要的贡献是置信度。 此前用户常困惑预测到底准不准。AlphaFold2给出两个打分:pLDDT衡量氨基酸级别的局部准确度(可视化时蓝色高、橙黄色低,后者多为loop);pTM衡量整体拓扑对不对(是球形还是杆形)。两者与真实指标高度相关,让预测结构第一次有了可信度标尺。

后AlphaFold时代:领域空前繁荣
AlphaFold2之后,做结构预测的人失业了吗?恰恰相反。
常规蛋白仍有难题。 AlphaFold并未把所有蛋白都预测准,细菌、病毒等同源序列稀少的蛋白精度仍很差,多结构域蛋白同样困难。
单序列预测。 MSA是基石也是瓶颈:检索一个MSA可能在CPU上跑半小时,而GPU推理只需一分钟。Meta用预训练蛋白质语言模型ESM替代MSA,开发了 ESMFold。
复合物预测。 2018年有人提出把两个蛋白的MSA拼接成“假序列”以观测跨链共进化,随后AlphaFold-Multimer出现。
抗体抗原。 免疫蛋白复合物预测长期极难,但2022年CASP15上,有两个课题组(其一正是郑伟团队)的精度远超AlphaFold2,被Nature报道,引发领域内颇多关注。
它有多实用?郑伟分享了一个案例:猴痘病毒爆发时,传统抗体筛选需从病人血清分离出几千个抗体逐一做中和实验。借助AI复合物结构预测按置信度排序,团队推荐Top 40交给实验方,其中5个被验证为具结合能力的抗体。
此外还有核酸结构预测(数据少、精度明显偏低)、多构象与动态预测(如新冠spike蛋白RBD的开合)。
最后是通用平台。2024年AlphaFold3问世。它在AlphaFold2的基础上进一步简化了网络,并把原来的结构生成方式换成了扩散模型,可以更自然地处理蛋白质、核酸、小分子等不同类型的生物分子,预测速度也比二代更快。同年David Baker团队在Science发表RoseTTAFold All-Atom,此后 Chai-1、Boltz、Protenix、SeedFold、ESMFold2等相继涌现。

用好AlphaFold3,有两个“坑”必须知道
第一,排名分数里藏着无序性加分。
AlphaFold3对复合物给出多个指标:pTM(全局拓扑)、ipTM(界面对不对)、以及综合两者的排名分数。后者还对无序区域给了鼓励、对原子失序做了罚分。
问题在于:如果蛋白loop区域特别多,排名分数可能很高,但结构未必准。 做有序蛋白预测时通常建议使用经典组合0.2 × pTM + 0.8 × ipTM;关注界面时主要看ipTM。
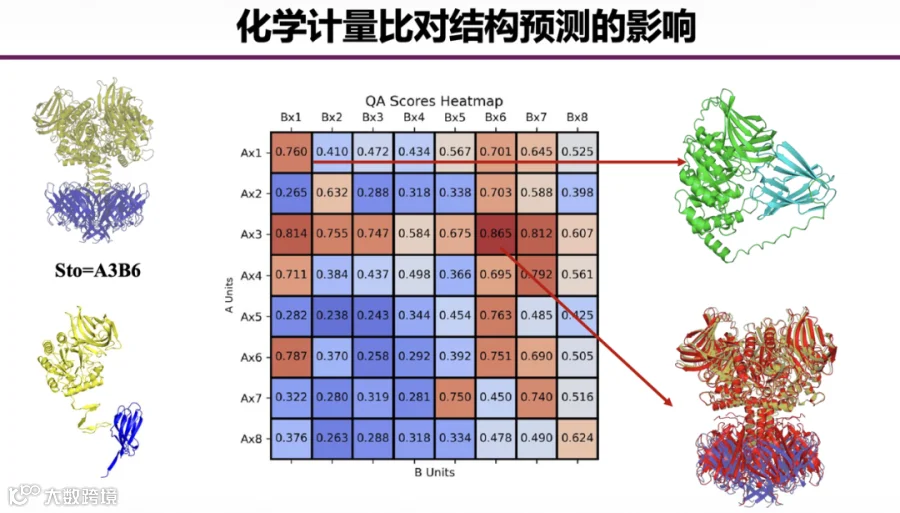
第二,化学计量比会彻底改变结果。
两个蛋白结合未必是1:1。郑伟举例:某复合物真实构成是A3B6。按1:1输入,打分是0.76;按正确的A3B6输入,预测结构与真实高度吻合,打分跃升到0.86。
同样两条序列,化学计量比给错,你可能得出“它们不结合”的错误结论。
实操:AlphaFold3的两种用法
理论之后,倪文韬现场演示了AlphaFold3的完整使用流程。
服务器版:选择分子类型、填入拷贝数(即化学计量比)与序列,提交即可。结果页左侧是按pLDDT着色的三维结构(越蓝置信度越高),右侧是PAE矩阵(颜色越深值越小、置信度越高,黑线分隔不同链)。也支持上传JSON。
本地版:需GPU服务器与近1TB存储(仅数据库解压就约630GB),推荐 A40/A100/H100。流程为安装依赖 → 安装 UV → 克隆源码 → 安装 HMMER → 构建环境 → 下载参数与数据库。
一个实用技巧:把MSA搜索与模型推理拆成两步执行。因为MSA检索极耗时,拆开后可让CPU检索与GPU推理分属不同进程,大幅提升批量任务效率。
输出包含5个扩散采样样本的结果,每个样本含结构文件与置信度数据文件;顶层放置排名分数最高的模型,另有完整的预测对齐误差矩阵与链级置信度。
notebook已开源,可以点击网址下载。
https://www.modelscope.cn/gallery/nwt123456/cbc66ab7-b04c-4b6f-8316-b34dae5ebb01
Q&A:AlphaFold的结果一定准吗?
AlphaFold的结果一定准吗?郑伟表示不一定,很多情况下就是错的,尤其在复合物与RNA领域出错概率仍然很高,所以务必参考置信度,但也要知道置信度与真实精度虽高度相关、却并非对每个target都成立。
关于蛋白质设计,他指出它与结构预测互为逆问题,且坦言设计出的序列能否表达、纯化并行使功能,失败率其实还挺高。
至于分子动力学方法与AlphaFold3谁更可靠,他认为二者本就不在同一维度。分子动力学方法看的是长时间平衡态,AlphaFold3给的是静态结合构象,实践中更常见的做法是先用AlphaFold3预测、再用分子动力学方法做扰动验证。
这个领域仍在快速生长,也仍然缺人。郑伟课题组长期招收博士后、博士、硕士与科研助理,有志于生物分子结构预测方向的同学,欢迎联系:jlspzw@nankai.edu.cn
下一讲预约:AI与空间生物学
从DNA、蛋白质、RNA 的序列,到分子结构,我们正在逐渐深入生命世界。
但生命的复杂性并不止于单个分子。
当我们把视角从一个分子拉到一张组织切片,会看到什么?细胞如何分布?不同细胞之间如何相互作用?疾病发生时,组织内部的分子信息又如何发生变化?
下一期,我们将走进细胞与组织尺度。9月17日19:30,西湖大学人工智能系特聘研究员李昊阳将以《AI与空间生物学:一张病理切片里藏着多少分子信息》为主题,从空间生物学的基本概念出发,介绍病理切片预测空间组学的方法。
他将围绕“判别→生成→单细胞级别”的线索展开,结合空间组学基础模型与实操案例,探索AI如何从病理切片中进一步挖掘隐藏的分子信息。
欢迎预约直播、同学同行!
