

 colibri简介
AI/ML
Colibri 是一个纯 C 语言编写的轻量级推理引擎,专门用于在消费级和异构硬件上运行 744B 至 2.8T 参数规模的前沿混合专家(MoE)大模型。它将显存、内存和磁盘存储视为统一的推理层级,通过按需流式加载被激活的专家权重,彻底打破了超大模型对昂贵数据中心级硬件的依赖。
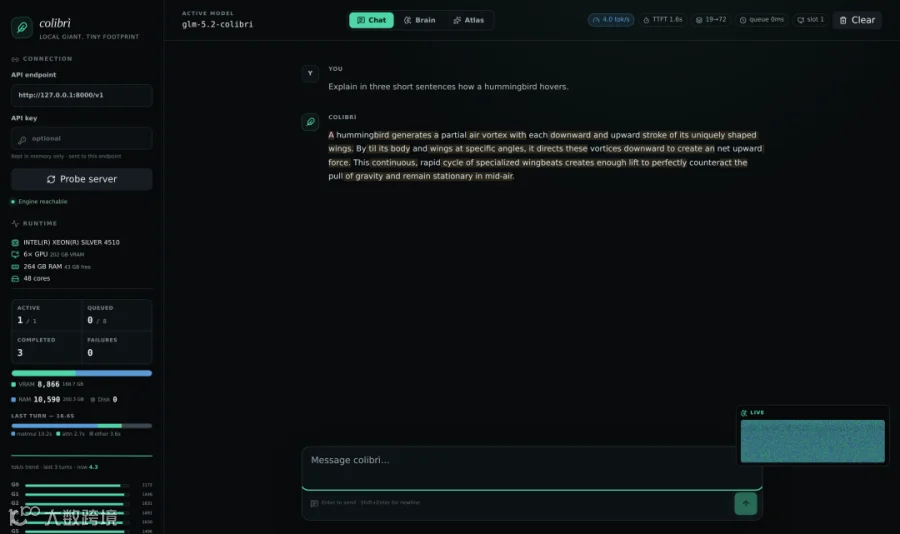
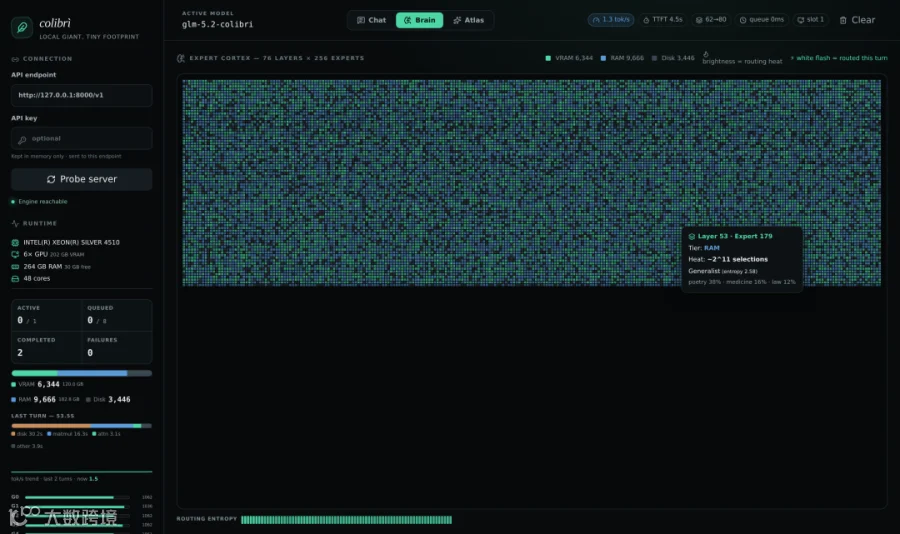
它解决了前沿大模型本地化部署成本极高的问题。由于 MoE 模型每次推理仅激活极少部分参数,Colibri 利用这一稀疏性,将未激活的专家权重存放在磁盘中动态调度,使得开发者仅凭普通台式机甚至笔记本电脑,就能在本地完整运行并研究千亿乃至万亿级别的开源大模型。
 亮点特性
01极致轻量化架构
核心引擎仅为单个 C 语言文件,运行时零外部依赖,无需 BLAS 库、Python 环境或强制 GPU 支持
02统一多级存储调度
将 VRAM、RAM 和 NVMe 磁盘视为单一存储层级,结合 LRU 缓存与学习机制动态驻留热点专家权重,实现按需流式推理
03广泛的模型与硬件支持
单套前端命令即可运行 GLM-5.2、Kimi K3 (2.8T)、DeepSeek V4 Flash 等 8 个系列模型,并原生支持 CUDA、Metal、Vulkan 及多节点集群模式
 使用场景
场景 1个人开发者或研究人员在普通工作站/游戏本上本地运行 GLM-5.2、Kimi K3 等千亿级 MoE 模型进行实验与测试
场景 2利用多台 Mac 或 PC 组建本地集群,分布式协同推理超大参数模型,摆脱云端 API 限制
场景 3作为大模型系统级优化的研究平台,验证专家路由缓存、多级存储调度、推测解码等底层推理优化假设


 快速上手
安装步骤
方式一:下载预编译版本(推荐)
从 GitHub Releases 页面下载对应操作系统的压缩包并解压,无需编译器:
|
方式二:源码编译
需要安装支持 OpenMP 的 gcc 或 clang:
|
获取模型
以 GLM-5.2 int4 为例,需从 Hugging Face 下载约 372GB 的预转换权重文件(推荐使用 gs64 容器格式),放置在高速 NVMe 固态硬盘中。
核心用法示例
启动交互式命令行聊天:
|
启动带 Web 可视化面板的 API 服务:
|
以无头模式提供 OpenAI 兼容 API:
|
检查当前机器的显存/内存/磁盘分配计划:
|
 替代方案
对比 1llama.cpp
业界最流行的本地推理框架,生态极其丰富且支持海量模型格式,但 Colibri 针对 MoE 架构的磁盘流式加载和多级存储进行了更极端的专项优化,能在更低配的硬件上运行更大规模的 MoE 模型
对比 2kTransformers
同样专注于 MoE 模型的 CPU/GPU 异构推理加速,但 Colibri 采用纯 C 实现且将磁盘 I/O 深度整合进推理引擎,整体依赖更少、部署更轻量
对比 3vLLM
面向生产环境的高吞吐量推理框架,强项在于连续批处理和高并发服务,但高度依赖高端 GPU 显存,无法像 Colibri 一样在消费级硬件上通过磁盘卸载运行万亿参数模型
 相关资源
项目地址github.com/JustVugg/colibri
官网justvugg.github.io/colibri