
2026年9月15日,阶跃星辰正式发布新一代语音大模型StepAudio 3系列,
覆盖实时语音交互、语音识别、真人级语音生成、音频生成和音乐创作等场景。
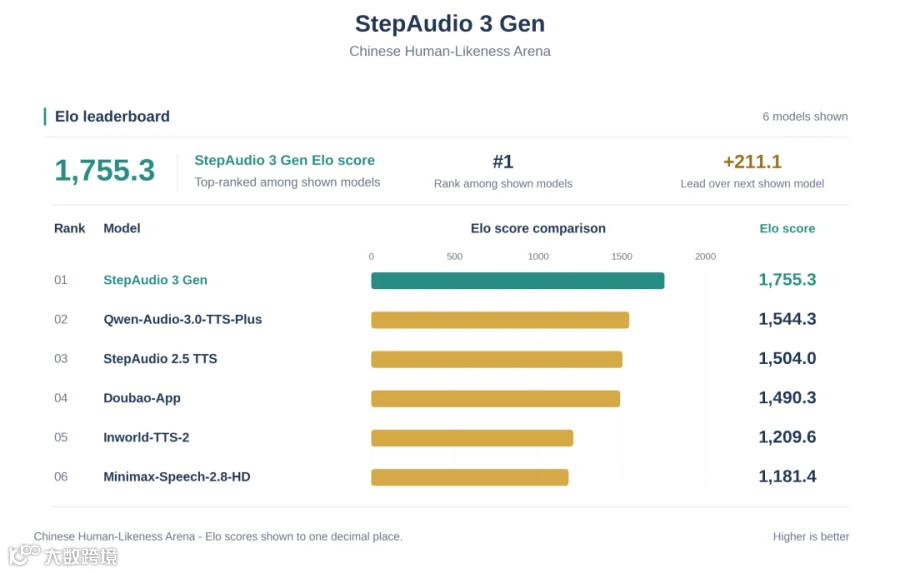
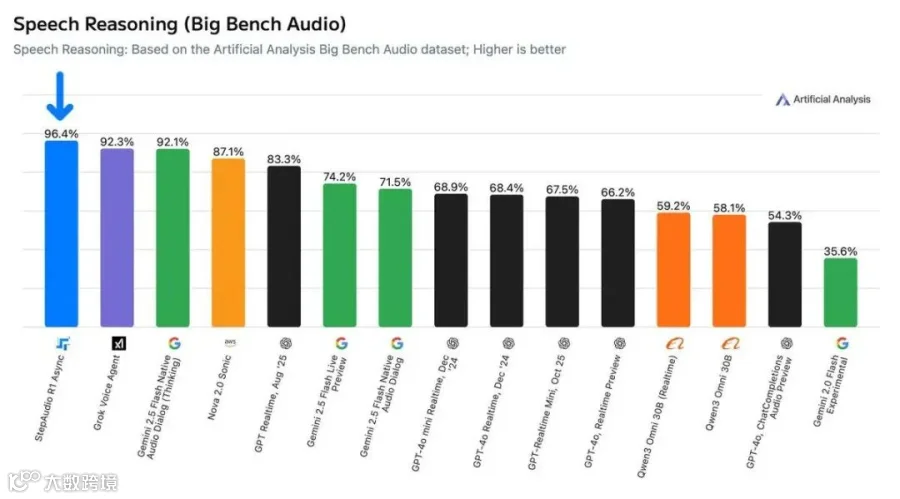
多款模型在权威第三方评测机构Artificial Analysis榜单中位列全球第一。
带来了哪些全新变化
1、从“对话”升级为“对话+推理+执行”
StepAudio 3 Realtime面向实时语音交互场景,支持原生全双工对话,可在持续交流中判断回应和等待时机,处理临时打断和连续反馈。
模型可同时理解语义、语气、情绪及环境声音,支持推理与语音生成并行;Tool Call和长任务可异步执行,在任务运行期间不打断当前对话。
在Artificial Analysis Conversational Dynamics榜单中,以98.9%的综合得分排名全球第一;在Speech Reasoning榜单中以99.7%的语音推理准确率同样位列全球第一。
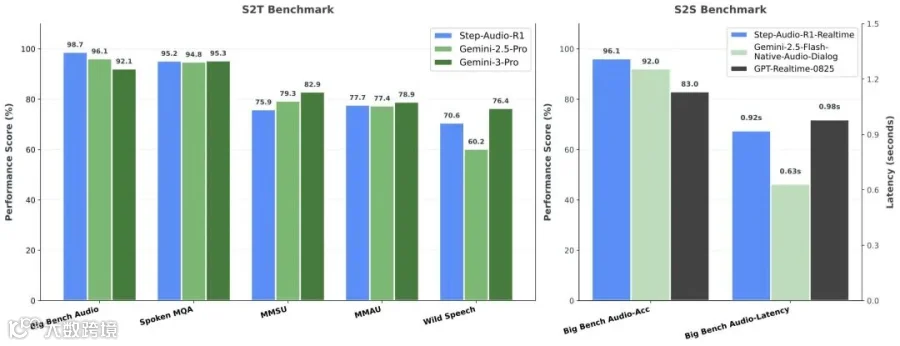
2、识别精度进入1.7%时代
高精度语音识别与大语言模型的上下文理解能力相结合,支持中文、英文、方言、中英混说、长音频及专业领域识别,并针对低声、快速语音、含糊连读以及背景音乐等复杂输入进行优化。
在Artificial Analysis非流式语音识别准确性榜单中,其WER(词错误率)仅为1.7%,并列全球第一。
3、从“念出文字”变为“演出表达”
StepAudio 3 TTS面向真人级语音生成,核心变化是在音色、语调、节奏、停顿和情绪控制之外,还能生成笑声、迟疑、重复、改口等真实交流中常见的副语言表现。

4、从“单点生成”变为“统一音频生成”
将人声、音效、环境声和背景音乐等原本分散的生成环节整合到统一框架中。
StepAudio 3 Gen基于StepAudio Tokenizer构建,以12.5 Hz的帧率在共享残差码空间中联合量化语义和波形级声学特征,每个码层均保留这两类信息。

5、从“一句话生成”变为“多轮协作创作”
面向音乐创作,不再局限于“一句话生成一首歌”,而是支持歌曲创作、清唱配乐、歌曲翻唱以及基于ABC记谱法的多轮交互创作。

如何用
1、我们先上阶跃星辰语音体验中心,按需求选 Realtime、ASR、TTS、Gen 或 Music 在线试效果。
2、要接入自己应用,去阶跃星辰开放平台。
3、Realtime 用 WebSocket 长连接调用,ASR/TTS/Gen/Music 用 HTTP API 传文本或音频,按对应文档接入。
全新kimi
尝鲜体验