

本文由响指 HaiSnap 整理,主要依据 Google 2026 年 9 月 15 日发布的《AI for everyone in every language》,并对照其产品与研究页面。原文属于企业官方叙事,文中已将已上线功能、预览项目与长期目标分开标注。
数据与产品状态截至 2026 年 9 月 16 日 · 预计阅读 8 分钟

你可能遇到过这种时刻:跨国会议开完,字幕每个词都认识,语气却全丢了;同事说“这个方案挺有意思”,机器翻得像在热情表扬,熟悉语境的人却知道,那句话其实是在委婉拒绝。
翻译工具越来越多,真正麻烦的反而不再是“这句话是什么意思”,而是:对方是在开玩笑、犹豫,还是已经不耐烦?
Google 最近发了一篇长文,集中讲了它在语言 AI 上的新路线。新闻一句话就能说完:Google 称,它的技术和产品目前覆盖 300 多种语言、触达全球 86% 的人口,下一步要让 AI 理解真实说话中的语气、节奏、口音、混说和文化背景,而不只是翻译文字。
对你,先记住三句:
-
AI 翻译正在从“换字”变成“听人”。 -
语言覆盖数字很大,不代表每种语言、口音和场景都同样可靠。 -
现在最值得试的,不是背参数,而是拿一段真实会议录音,看它会不会把语气也翻错。
01 · 真正的变化:翻译不再先把声音压成文字
过去的语音翻译像一条流水线:先把声音转成文字,再翻译文字,最后合成另一种语言的声音。
这套办法能用,但有个天然损耗:笑声、停顿、抢话、重音、犹豫,经过“文字中转站”以后,往往只剩下一排语法正确的句子。人说得有血有肉,机器交付得像会议纪要。
Google 现在强调的是原生音频理解:模型直接处理声音,同时判断内容与表达意图。其 Gemini 3.5 Live Translate 已开始在 Google 翻译 App 等产品中推出,官方称支持 70 多种语言、2000 多种语言组合,并尽量保留说话人的语调、节奏和音高。
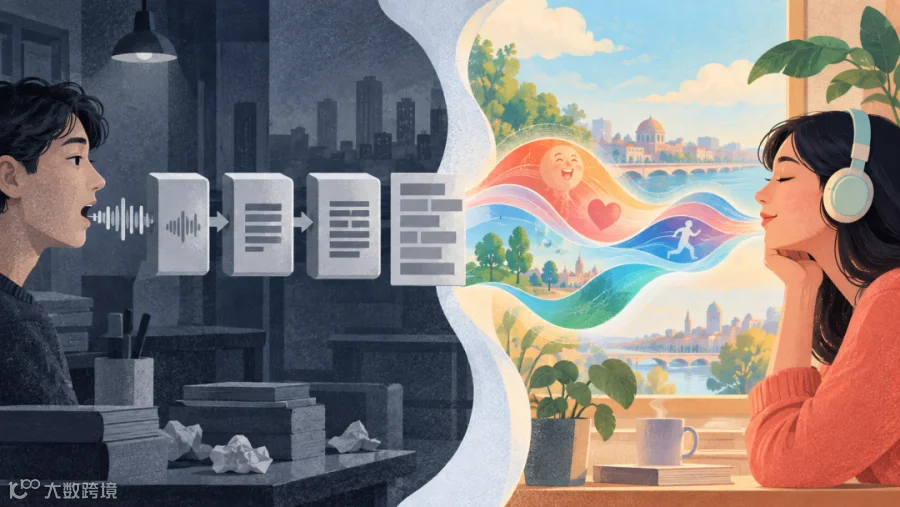
人话解释:过去机器主要回答“你说了什么”;下一步还想回答“你是怎么说的”。
这对日常工作的价值很直接:
-
跨国会议里,少把礼貌的保留意见翻成明确赞同; -
客服通话里,除了识别投诉内容,也能更早察觉情绪变化; -
采访和课程里,减少说话节奏被机械配音抹平; -
中英文混说时,不必每切一次语言就重新设置。
但要注意,“尽量保留”不等于“已经等同真人同传”。涉及合同、医疗、财务和人事决定,机器可以帮你听懂大意,不能替你承担误译责任。
02 · 难点不是再收一批文字,而是找到真实说话的人
主流语言在互联网上留下了海量文本;很多小语种、方言和手语却没有这么幸运。网页上没有足够材料,模型就很难学会真实口音、口语节奏和本地表达。
所以 Google 这次花了大量篇幅讲“数据从哪里来”。它列出的几个项目都不是简单抓网页:
-
WAXAL:与当地高校和机构合作,建设覆盖 27 种撒哈拉以南非洲语言的开放语音数据集; -
Project Vaani:按地区而非只按语言采集印度语音,官方称已收集 109 种语言、3 万多小时语音,来自 15.5 万多名说话者; -
Amplify Initiative:邀请 1600 多名当地专家和 20 所大学参与,收集带有本地语境的多模态数据; -
Language Explorer:把 7000 多种口语、书面语和手语的数据状况做成可视化地图。
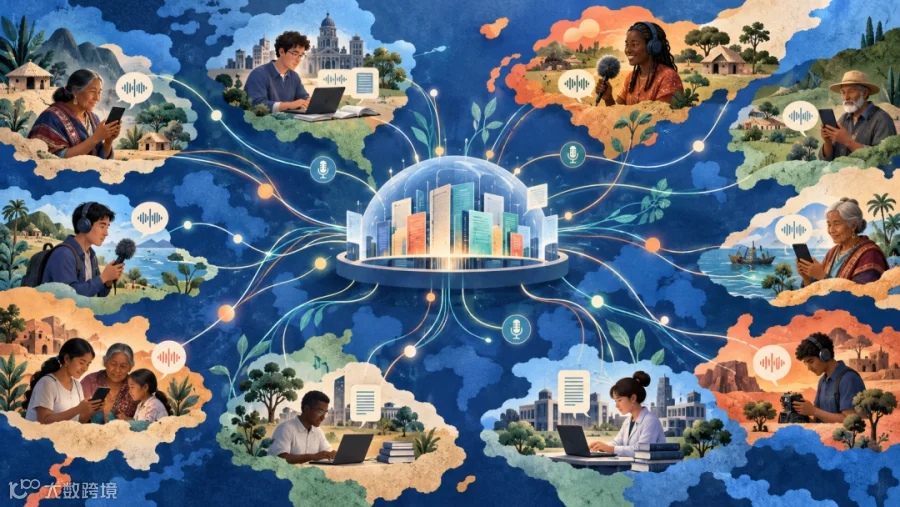
图注:语言 AI 的底座不是一张全球网页,而是一群真实说话的人。配图由 AI 生成,仅作概念示意。
这里有一个容易被忽略的判断:语言不是词表,而是社区。
如果数据只来自大城市、新闻播音和标准口音,模型即使“支持某种语言”,也可能听不懂乡镇口音、行业黑话和年轻人的混说。覆盖语言数量适合写在发布会上;能不能听懂你的客户,才适合写进采购表。
03 · 对你有什么用:先看三个具体场景
场景一:跨语言会议
如果你经常参加英文、日文或东南亚市场会议,实时语音翻译比逐句字幕更值得关注。它的目标不是让字幕更漂亮,而是让翻译少几秒停顿、少丢一点语气。
测试时不要选官方演示。找一段你有权使用的真实会议录音,里面最好包含打断、笑声、口音和中英文混说。看它能不能把“表面赞同、实际保留”区别出来。
场景二:录音转写和口述写作
Google 同期介绍的 Gemini 3.5 Transcribe,主打在噪声、术语、停顿和自我纠正中生成整理过的文本,官方称可自动识别 85 种以上语言。
这意味着口述周报、访谈整理和会议纪要可能少一道“先逐字稿,再人工清理口头禅”的工序。但自动删掉“嗯、啊”也有风险:它有时会把犹豫、修正和不确定性一起擦掉。做访谈证据时,应保留原始音频。
场景三:没网或设备一般
全球仍有超过 30 亿人无法稳定上网。Google 给出的答案之一是 TranslateGemma:一组面向 55 种语言的轻量开放翻译模型,强调可在设备端运行;另一个方向,是通过 Viamo 把语音 AI 接到功能手机上。

图注:真正的“人人可用”,还要经过网络、设备和使用成本这一关。配图由 AI 生成,仅作概念示意。
对经常出差的人,这一层尤其实际:机场、展会、工厂和乡镇,不会为了配合 AI 永远提供满格信号。
04 · 要花多少钱:这次没有一张统一价目表
原文讲的是一组研究与产品进展,不是一项单独收费的新会员。因此,“多少钱”要拆开看:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
因此,对个人用户最稳妥的动作不是先买会员,而是:先在现有手机和现有账号里看功能是否已经出现,再决定值不值得迁移工作流。
“模型免费”“App 免费”“长期使用没成本”,是三件不同的事。
05 · 和谁比:机器翻译、人类翻译,不在同一条线上
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Google 的方向并不是证明“机器马上替代译员”,而是在填传统翻译工具中间那块空白:比字幕更像交流,比真人服务更容易随手调用。
最实际的组合仍然是:机器负责第一遍,人负责高风险内容和最终判断。
06 · 需要冷静的四件事
-
300 多种语言是生态覆盖,不是单一功能都支持 300 多种。 实时翻译、转写、端侧模型和手语识别,各自支持范围不同。 -
“保留情绪”最难客观评分。 同一句讽刺、客套或含蓄拒绝,在不同文化里可能完全相反。 -
低资源语言的数据更珍贵,也更敏感。 谁同意采集、如何授权、社区是否获得长期收益,都不能被“开放数据”四个字带过。 -
许多能力仍在预览或逐步推出。 Google Meet 的新翻译能力、手语转文字等,并非所有用户今天都能使用。
还有一个产品边界:Google 展示的是自己的路线图,官方指标与合作伙伴评价不能代替独立横评。你真正要信的,仍是自己场景里的错译率和返工次数。
07 · 今晚可以怎么做
不用研究模型参数。准备一段 60 秒、你有权使用的双语音频,最好有口音、停顿和一次中途改口,然后在你现有的翻译工具里走三步:
-
查意思:人名、数字、否定词有没有翻错; -
听语气:犹豫、玩笑、强调有没有被抹平; -
做人审:把结果交给懂两种语言的人快速核对。
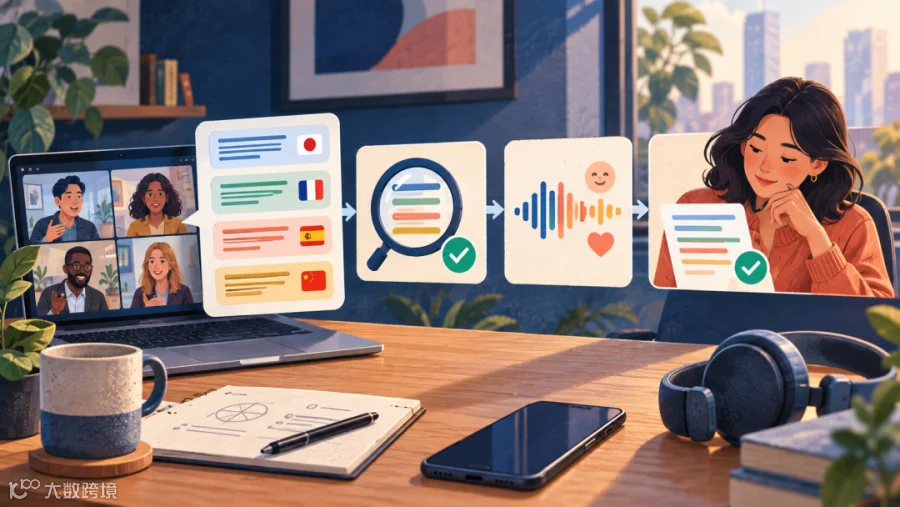
图注:测试工具不要只看“能不能翻”,还要看“错在哪里、谁来兜底”。配图由 AI 生成,仅作概念示意。
只记录三个数字:明显错译几处、节省几分钟、人工改了几次。
这比“支持多少种语言”的宣传页更接近你的答案。
08 · 响指与这篇稿
响指 HaiSnap 是北京海新智能科技有限公司推出的AI Agent 创作平台。你用自然语言描述目标,Agent 会规划步骤、搜索资料、调用工具,并交付文档、报告、PPT、图片等成果,而不只是停在聊天框里给一段回答。
这篇稿的产出过程包括:
-
阅读 Google 原文,拆出实时音频、转写、社区数据、端侧模型和无障碍五条线; -
回查 Google 产品与研究页面,区分已经推出、预览中和长期目标; -
按“有没有用、要不要动、多少钱、和谁比、哪里不确定”重组为中文文章; -
为首图和四个正文节点生成统一风格配图; -
对数字、日期、产品状态和引用链接进行人工复核。
如果你经常要把一篇外文长文连同相关页面整理成可发布文章、报告或汇报,这类“搜索—对照—成稿—配图”的完整任务,适合交给 Agent 跑流程。若你只是翻一句话,现有翻译 App 更直接,不必切换工具。
收束
过去,翻译工具努力把每个词放到正确的位置。现在,语言 AI 开始尝试保住词语之外的东西:停顿、情绪、口音、关系和文化。
这一步比“再多支持 50 种语言”难得多,也重要得多。
真正的进步,不是让所有人说得越来越像机器,而是让机器终于愿意适应人本来的说话方式。
如果这篇帮你看清了“支持语言数量”和“真正听懂人”之间的差别,欢迎点赞、在看,并转给经常参加跨语言会议的同事。
信源与说明
-
Google:AI for everyone in every language,2026-09-15。 -
Google:Gemini 3.5 Live Translate,2026-06-09。 -
Google:Gemini 3.5 Transcribe,2026-08-26。 -
Google Research:WAXAL。 -
VAANI 论文。 -
Google:TranslateGemma。 -
Google DeepMind:Sign Language-to-Text。
产品支持范围、地区可用性、价格与配额可能变化,请以各产品实时页面为准。本文为响指编辑整理,不构成采购、医疗、法律或投资建议。