

这篇文章由苏神发表于科学空间,尝试从数据误差、优化误差和架构误差三个角度理解 Scaling Law,并串起学习率、批大小、模型规模与训练数据之间的关系。对于想弄清“模型该做多大、数据该用多少、训练预算该怎么分”的读者,它提供了一套值得细读的分析思路。以下为原文,文末有原文链接。

训练一个大型的神经网络,最终效果会受到非常多因素的影响,换个优化器,换个模型架构,或者换一个训练集,结果都可能截然不同。在工程实践中,我们将调试这些因素的经验结果,戏称为“炼丹”。但如何从经验上升到规律,更准确、定量地描述它们之间的关系呢?如果能搞清楚这个问题,我们的炼丹将会更有底气。
“Scaling Law”便试图以一种相对定量的方式来回答这个问题。自OpenAI在2020年的奠基性工作(Kaplan Law)以来,Scaling Law已成为深度学习最可靠的经验规律之一,它可以用来预估模型性能、指导超参数选择、判断某个改动的有效性等。为此,也有不少工作,试图对Scaling Law做进一步的更贴近本质的解读。
本文也来分享笔者对Scaling Law的一些理解。
准备篇
后文会反复遇到“在某个约束下,求幂律组合的最小值”这类问题,所以我们这一篇先准备两个基础结论。
异幂不等式
首先是一个使用次数最多的不等式,设a,b,p,q,x>0,那么

取等号的条件是
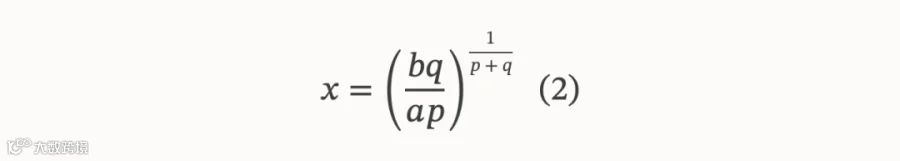
它是简单不等式x+x⁻¹≥2的推广,可以通过求导或者加权AM-GM不等式来证明。下面演示后者,加权AM-GM不等式为w₁x₁+w₂x₂≥(w₁+w₂)(x₁^(w₁)x₂^(w₂))^((1)/(w₁+w₂)),于是我们有

等号成立的条件为(axᵖ)/(q)=(bx^(−q))/(p),即x=((bq)/(ap))^((1)/(p+q))。为了方便使用,我们称这个不等式结论为“异幂不等式”,它的主要特点是有两项指数异号的幂函数。更有趣的是,最小值点和最小值本身依然还是幂律,这是后续一系列推导的基石之一。
最优配比率
异幂不等式是固定乘积((xᵖ)^q(x^(−q))ᵖ=1)后,求两项幂律之和的最小值,还有一些场景(比如求参数量的最优配比)需要我们要固定它们的“和”来求最小值。具体来说,设a,b,p,q,x,y>0,我们要求

很遗憾,这个问题没有初等的解析解,但数值求解是没有问题的。不难看出最小值一定是存在的,将y=1−x代入,然后求导得bq(1−x)^(−q−1)−apx⁻ᵖ⁻¹,令它等于零得

左端在(0,1)内关于x显然是单调递增的,并且x→1时,左端趋于∞,当x→0时,左端趋于0。由介值定理可知它在(0,1)内存在唯一解,直接二分法即可求得。
思想篇
一个模型的训练过程,可以形式化为
在给定数据D、架构A和优化器O之下,最小化损失函数L(E|D,A,O)。
这里E表示某个理想分布,也可以将它想象为一个无比巨大的测试集,而我们能构建的任意训练集D,都是它的一个子集,或者说一个采样结果;L(E|D,A,O)则表示在这些条件之下,模型在理想分布E上能达到的损失值。
三重分解
我们考虑如下分解

这个分解看上去将问题复杂化了,但实际上它将当前训练状态到理想目标的距离,分解成了层层递进的三步。在“越多越好”的常规假设下,每个括号都是非负的,因此它相当于把总差距写成三段各自可解释的距离之和,尽可能解耦了各个变量对损失函数的影响,使我们可以更合理地推测它们之间的依赖关系。
现在我们就来逐一解释式中每一项的含义。
数据误差
第一层分解是

其中L(D|A,O)代表着给定架构A和优化器O下,模型在训练集D上的损失值。
注意,根据定义,L(E|D,A,O)代表模型在理想分布E下的损失,这是我们的终极目标。然而,E在训练过程中是不可触碰的,我们只能跟训练集D打交道,所以只能得到训练损失L(D|A,O),然后设法通过L(E|D,A,O)−L(D|A,O)来描述它们之间的差距。
这一项通常也叫“泛化误差”,其关键影响因素是数据——比如数据的数量、质量、多样性,等等。此外,架构A、优化器O也可能改变泛化误差,具体要考虑哪些变量,取决于我们的分析目标。
优化误差
第二层分解是
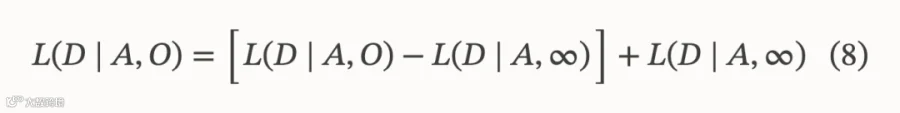
其中L(D|A,∞)代表把优化推到极致——比如有一个完美的超级优化器,或者把训练步数与调参次数都推向无穷——时,训练集上能达到的理想损失。
所以,L(D|A,∞)代表了优化器的天花板,而L(D|A,O)−L(D|A,∞)则表示实践优化器与这个天花板的距离,它衡量的是优化器是否足够好——比如学习率是否合适、训练步数够不够、批大小是否足够稳定梯度,等等。
架构误差
第三层分解是

其中L(D|∞,∞)代表优化和架构都推到极致——任意优秀的优化器、任意强大的模型——时,训练集上能达到的最理想损失。
所以,L(D|∞,∞)是当前这份数据自身决定的理论极限,而L(D|A,∞)−L(D|∞,∞)则表示实践模型与其理论极限的效果差距,它衡量的是架构是否足够好——参数量够不够、深度宽度够不够、残差还有没有改进空间,等等。
优化篇
这一节我们先来探讨优化差距Fₒₚₜ=L(D|A,O)−L(D|A,∞)。给定优化器(比如Adam或Muon)后,我们主要关心学习率η、批大小B和训练步数T这三个核心参数的影响。当然,理论上可以把其他参数如动量还有其他细节都考虑进去,但这里我们主要考虑这三个参数。
关系分析
首先,一个合理的假设是“训得越多,效果越好”,这里训得越多包括“步数越多”以及“学习率越大”两重含义,或者我们可以直观地认为,Tη才是模型走过的“路程”,走的路程越长,效果越好,于是可以猜测有一项贡献是α₁(Tη)^(−γ₁)。
另一方面,训练效果也会受到噪声影响,合理的假设是噪声越大效果越差。噪声来源于两方面,一是批大小B,它越小噪声越大,二是学习率,它代表着训练过程的不光滑程度,它越大也意味着噪声越大,所以我们猜测还有另外一项α₂B^(−γ₂)+α₃η^(γ₃)。
将这两部分加起来得到
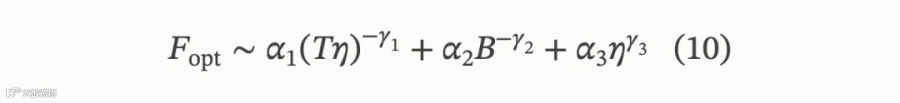
我们也可以将训练过程分为两阶段来理解上式:训练初期,噪声是次要的,α₁(Tη)^(−γ₁)这一项让损失函数先快速降下来,随后,噪声开始逐渐发挥作用,模型开始在目标点附近震荡,类似螺旋下降的轨迹。
这个形式跟2503.12645、2603.15958所用的一致。值得指出的是,这两篇工作并不是实验拟合,而是直接对SignSGD、Muon等类型的优化器的收敛性做理论分析得出,结论是γ₁=γ₃=1,γ₂=1/2。在后面的推导中,我们可以代入这几个数值进行简单验算。
最优学习率
式(10)里边有6个参数,直接拿去拟合的话,需要打非常多的点,成本会非常高。同时也非常容易出现过拟合问题。对此,我们可以利用最优参数假设,进一步简化形式。
首先,根据异幂不等式,可以求得让右端最小的最优学习率是

相应的最小值是
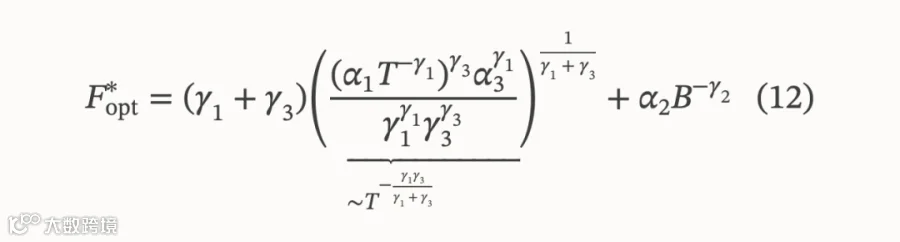
这告诉我们两个结果:1、存在某个0<c<1,使得最优学习率反比于Tᶜ;2、假设我们总能为每个配置找到最优学习率,那么优化误差的渐近规律可简化成α̃₁T^(−γ̃₁)+α₂B^(−γ₂)的形式,参数降低至4个,这正是2607.01487提议使用的解耦形式,而2605.09154从带噪二次型出发推导,也得出将B,T分开建模的结论。
最优批大小
现在从最优学习率的假设出发,优化误差设为

记K=BT,它表示训练过程中所学过的样本数,注意我们没限制Multi-Epoch,所以不排除某些样本会被重复学习多次的可能。如果固定K,那么右端变成α̃₁(B/K)^(γ̃₁)+α₂B^(−γ₂),继续由异幂不等式可以求得最小值为
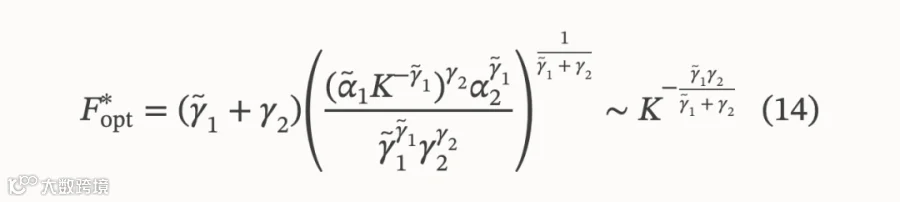
等号在

这同样有两个结论:给定总训练样本数K下,最优批大小B^∗正比于Kᶜ,其中c∈(0,1);而在最优批大小下,Scaling Law简化成α̂₁K^(−γ̂₁),这正是经典的Scaling Law形式。
小结一下
现在我们可以总结一下:优化器一般的Scaling Law是α₁(Tη)^(−γ₁)+α₂B^(−γ₂)+α₃η^(γ₃),如果假设总在最优学习率下跑,那么可以简化成α̃₁T^(−γ̃₁)+α₂B^(−γ₂),如果进一步给定训练样本数K,假设总能找到最优批大小,那么简化成α̂₁K^(−γ̂₁)。
而对于最优参数,最优批大小则正比于K的某个不大于1的幂,这跟Step Law吻合;最优学习率反比于T的某个不大于1的幂,按照T^∗=K/B^∗换算,最优学习率也反比于K的某个不大于1的幂,这跟Microsoft Law吻合,但跟Step Law相反。
如果代入前面提到的理论值γ₁=γ₃=1,γ₂=1/2,那么有γ̃₁=1/2,继而得B^∗∼K^(1/2),这跟Step Law给出的B^∗∼K^(0.571)还是比较接近的;此外还有η^∗∼T^(−1/2),按照T^∗=K/B^∗换算得η^∗∼K^(−1/4),这跟Microsoft Law的η^∗∼K^(−0.32)也相差不远。最后还有Fₒₚₜ^∗∼K^(−1/4),这跟Chinchilla Law给出的∼K^(−0.28)也很接近。
架构篇
接着我们转到模型差距F_(arch)=L(D|A,∞)−L(D|∞,∞),这是单纯讨论架构A对损失函数的贡献,经典变量包括参数量N、宽度W、深度H等,同时架构变量的引入又会反过来影响优化差距的变化规律,我们尽可能将这些内容都捋一捋。
模型参数
在固定整体架构的前提下,模型的主要变量就是参数量N了,假设参数量越大,效果越好,那么可以合理认为
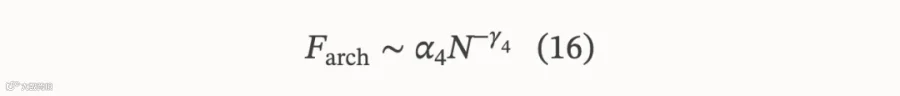
这是Scaling Law对参数量最朴素的假设,跟Kaplan Law、Chinchilla Law等一致,其中Kaplan Law给出的结果是γ₄=0.076,而Chinchilla Law给出的拟合结果是γ₄=0.34,目前普遍认为Chinchilla Law在训练规模变大时更加准确。
这里有个争议点是,参数量N的统计要不要包含Embedding,主流做法是不计入,但这在小规模时可能会有较大偏差,这可能是Kaplan Law和Chinchilla Law结果差异的原因之一(Kaplan实验的年代,训练规模普遍不大),论文2406.12907对此做了详细的分析。如何更准确地考虑Embedding的贡献,可以参考后面的“记忆之层”一节。
除了把整个架构压缩成一个参数量N外,我们可以做得更精细一点,比如,可以分开宽度W和深度H,研究模型是“高瘦”还是“矮胖”好:
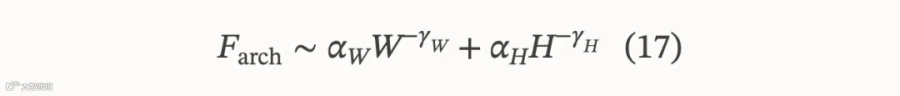
根据模型参数量大致上N∼W²H,那么就可以在固定参数量下,求出最优宽度、高度以及对应的F_(arch)^∗:
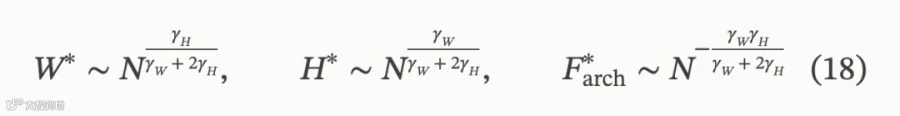
论文2606.25008从理论出发(2505.10465、2602.05970)提出γ_W=γ_H=1,代入得

最终的F_(arch)^∗∼N^(−1/3)跟Chinchilla Law还是很接近的。
优化规律
同时,参数量的变化也会影响优化过程。在式(10)中,三个系数α₁,α₂,α₃被视为常数,那是在假设给定架构A的前提下,现在我们引入了参数量N,那么α₁,α₂,α₃自然也是N的函数了。
我们同样分两部分来理解:一方面,参数量越大,模型能力越强,损失函数下降也越快,所以α₁我们换成α₁N^(−γ₅);另一边,参数量越大,模型越复杂,带来的噪声也越大,所以α₂,α₃我们分别换成α₂N^(γ₆)和α₃N^(γ₇),于是

这里有一个自然的问题:为什么只考虑α₁,α₂,α₃随N的变化,不考虑指数γ₁,γ₂,γ₃的变化呢?这个问题我们放到“幂律篇”讨论。现在重复“优化篇”的计算,我们可以得到

如果我们认同Kaplan Law、Chinchilla Law和Step Law等结果,那么B^∗和Fₒₚₜ^∗就跟N无关,通过让这两项N的指数为0,可以解得
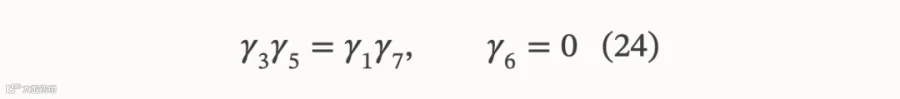
代入各式后,发现只新增了一个γ₇参数:

有趣的是,η^∗的形式正好跟Microsoft Law一致,即跟K和N都负相关,这并不是平凡的,因为我们只假设了B^∗和Fₒₚₜ^∗跟N无关,对η^∗并无假设。最后代入理论值γ₁=γ₃=1,γ₂=1/2,得
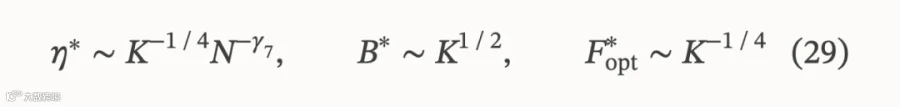
至于γ₇,Microsoft Law给出0.23,Step Law则给出0.713,考虑到这两个Law对K的依赖完全相反,所以它们在这个指数上有明显差异是正常的。理论大体上更偏向Microsoft Law一些,从一些凸优化结果观察,N^(γ₇)跟全体参数的梯度的标准差有关,所以猜测它在0∼0.5之间,结合Microsoft Law,我们可以拍一个1/4。
给定算力
综合Fₒₚₜ^∗和F_(arch),我们有
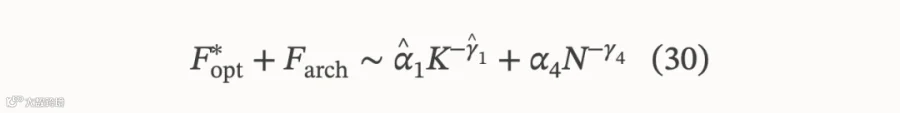
对于稠密模型来说,模型的每一步计算量基本上跟参数量N成正比,K是训练过程中学习过的样本数,它也跟训练的计算量成正比,所以训练过程消耗的总的计算成本为C∼NK,标准架构的比例系数大致是6,包括2NK的前向传播和4NK的反向传播。
在实际训练中,算力通常是有限的,我们希望在固定的算力预算C下实现最大的智能,那么就需要在约束NK∼C下求最优的K^∗和N^∗。把K∼C/N代入上式(常数因子吸收进系数),得到
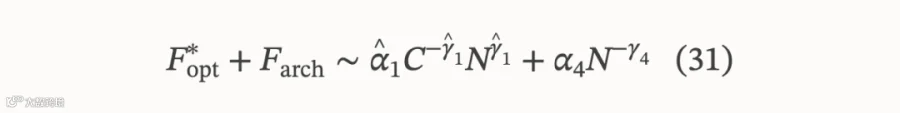
这又一次是异幂不等式的形状,直接套用公式,得到

如果代入前面的理论值γ̂₁=1/4和γ₄=1/3,那么
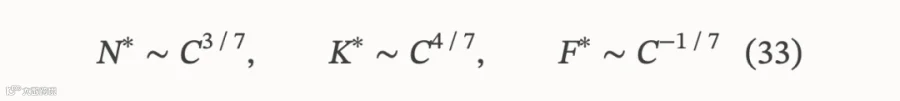
这跟Chinchilla Law的核心结论很接近:最优模型规模与最优数据量应大致等比例扩展(论文的拟合结果是N^∗∼C^(0.46), K^∗∼C^(0.54))。最后,将N^∗和K^∗的表达式代入到上一节的η^∗∼K^(−1/4)N^(−γ₇)和B^∗∼K^(1/2),得到

其中B^∗∼C^(2/7)倒是跟DeepSeek Law的B^∗∼C^(0.3271)相差不多,但DeepSeek Law给出η^∗∼C^(−0.1250),而这里即便代入γ₇=1/4也只能得到η^∗∼C^(−1/4),还是差得有点远。这样看来,各家的结果在最优批大小上是比较一致的,但最优学习率上分歧比较大,这可能跟具体的优化设置和学习率Schedule等比较相关。
稀疏架构
刚才我们说“计算量大致正比于参数量N”,这是在Dense模型下成立的,假设模型核心运算是Linear层,a×b的输入与b×c的参数相乘,计算量是O(abc),参数量是bc,大家都正比于bc,从而参数量即计算量。但近年来大家也致力于研究参数量和计算量解耦的架构,比如MoE。
MoE自然是目前当之无愧的主流架构了,几乎每一个开源的大型模型都是MoE,它一个重要的新参数是稀疏度S,它可以定义为总参数量与激活参数量之比,或者总Expert数与激活Expert数之比。从理论上来看,MoE理论计算量大致上只取决于激活参数量,也就是说增加稀疏度S理论上不增加计算量,但损失可以降,所以增加稀疏度总是划算的。
将稀疏度纳入到Scaling Law中的一个简单方案是:

其中N_(act),Nₜₒₜₐₗ分别是激活参数量和总参数量,S=Nₜₒₜₐₗ/N_(act),相似的形式也出现在2501.12370。如果从式(16)看,这相当于同样假设S只以幂律的方式影响系数α₄,但不影响指数γ₄。从上式中,我们还能导出“等效参数量”的概念:
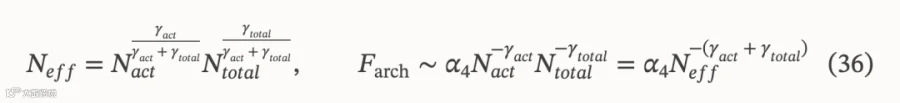
即激活参数量为N_(act)、总参数量为Nₜₒₜₐₗ的MoE模型,等效于一个参数量为N_(eff)的Dense模型,一个民间常用的经验公式是N_(eff)=√(N_(act)Nₜₒₜₐₗ)(参考)。该概念可追溯自2202.01169提出的Effective Parameter Count,后来Ling Law将它进一步拓展成“效率杠杆”,并探究了其变化规律。
然而,计算量只正比于激活参数量N_(act),这意味着我们可以让N_(eff)不变的同时让N_(act)→0,换言之将计算量降到近乎零但效果不变,但这看起来不大现实。因此,合理猜测F_(arch)应当多一项关于N_(act)的惩罚项,来保证一定的激活参数:
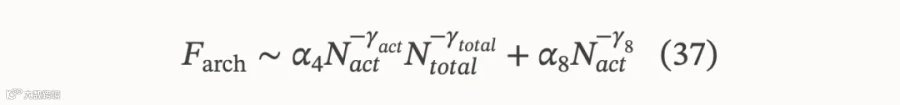
建模稀疏度的工作还包括2309.08520、2501.12370、2502.05172等,它们所设的Scaling Law形式各不相同。除稀疏度外,Expert的颗粒度(由2402.07871首次建模)、Shared Expert对效果也有一定影响,2509.23678将这些因素都糅合成了一个非常庞大的形式来实验拟合。
当然,“任意增加稀疏度都划算”仅仅是理论上的,实践中还要考虑路由开销、推理效率等问题,增加稀疏度并不是完全免费的,需要算法和Infra的共同设计。
记忆之层
除了MoE外,解耦参数量和计算量的途径还包括稀疏型的Memory层,经典的比如PKM、UltraMem等,而新兴起的比如Over-Encoding、Engram等都可以归入此类。
事实上,这类工作也可以看成是MoE的另一个极端:它们的“Expert”简化为没有任何计算的可训练向量,然后基于可训练Router(Pointer)或N-gram Hash来选出要激活的“Expert”。从这个角度看,它们的Scaling Law应该跟MoE类似,比如一个Dense模型配上若干Memory层后,Scaling Law应该同样呈现式(37)的样子。
如果MoE和Memory这两类不同的稀疏型设计同时使用,那么Scaling Law应该长什么样呢?我们先定义几个记号N_(act),Nₘₒₑ,Nₘₑₘ,Nₜₒₜₐₗ,分别代表“激活参数量(只统计产生计算量的参数,即Dense部分加激活Expert)”、“去掉Memory后的总参数量”、“去掉未激活Expert之后的总参数量”、“总参数量”,它们成立恒等式
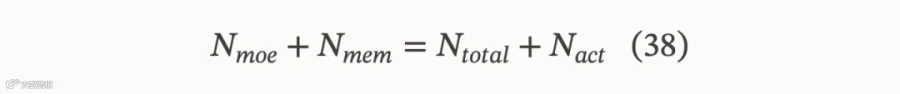
如果猜测MoE和Memory的作用是互补的,那么它们的Scaling Law可能是加性的,即

这里还引申出一个新的优化问题:如果我们必须固定激活参数量N_(act)(计算瓶颈)和总参数量Nₜₒₜₐₗ(内存瓶颈),那么该如何分配MoE和Memory的参数呢?根据恒等式(38),此时Nₘₒₑ+Nₘₑₘ就是一个常数,要在该约束下最小化上述。设Nₘₒₑ=λ(Nₜₒₜₐₗ+N_(act)),代入到上式后,问题就变成了“最优配比率”一节介绍的和约束最小化问题,可以数值求解出来。
也就是说,并不是将全部参数都分配到MoE或Memory最好,而是存在一个最优配比,这跟Engram的发现类似。
小结一下
跟优化篇类似,本篇也是先根据经验作出幂律假设,然后主要使用异幂不等式进行优化计算。
量化模型的最简单变量是总参数量N,更细致一点则可以分别考虑宽度W和深度H。模型的变化,也会引起优化误差的变化,所以我们也简单讨论了各个优化参数与参数量的联合作用。在Dense模型的假设下,参数量本身也代表着计算量,而优化器的训练步数T和批大小B也跟计算量正相关,那么我们还可以探究在固定总预算C时,如何确定最优的参数量以及对应的优化器参数。
如果进一步细化,模型架构的变量就更多了,比如MoE架构会有“激活参数”和“总参数”的区别,诸如Engram等Memory设计也类似,而当它们一起出现时,又会出现参数的最优分配问题,诸如MHC、AttnRes等残差改进我们也还没提及,等等。总之,模型这一块能考虑的变量非常之多,这里就只能简单带过了。
数据篇
最后我们转到数据差距F_(data)=L(E|D,A,O)−L(D|A,O)。根据定义,这一项需要我们关注在理想分布E上的效果,但我们又说理想分布理论上是不可触达的,既然如此,那该怎么测量呢?
事实上,也没有什么好办法,我们只能选一个没有训练过的、我们认为足够有代表性的数据集作为测试集,以它算出来的测试损失作为L(E|D,A,O)的近似。所以,跟benchmark类似,测试集的建设也尤为重要,它代表着我们对理想目标的理解和描述的准确程度。
数据大小
数据核心超参数是训练集的大小D,我们认为训练集越大,泛化性能越好(即“见多识广”),所以贡献一项α₉D^(−γ₉)。
每一步的数据是从训练集中均匀随机采样的,那么K/D就是平均每个样本被训练的次数,也就是训练的Epoch数,我们认为Multi-Epoch越严重,泛化性能越差,所以贡献一项α₁₀(K/D)^(γ₁₀),于是一个基本形式是
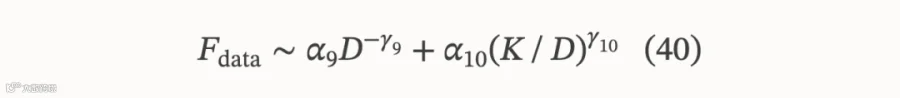
大多数Scaling Law工作,都是在Single-Epoch假设下,将K和D视为同一个,本文把它们区分开来,为的就是能考虑Multi-Epoch的影响。
最近的论文《Prescriptive Scaling Laws for Data Constrained Training》中也引入了类似的幂律,但将K/D换成了K/D−1,并同时考虑了模型参数量的影响,大致上认为模型参数量越大,越容易过拟合,所以越不应该Multi-Epoch训练,因此让α₁₀跟N正相关,这些改动我们也可以按需调整。
另一方面,《Scaling Data-Constrained Language Models》等文章,则通过引入“价值衰减”的概念,将Multi-Epoch后的数据量折算成“有效数据量”,从而修正Scaling Law,但笔者感觉没有区分K和D才需要这一项,我们已经区分了K和D,只需要直接对Multi-Epoch带来的过拟合风险进行惩罚。
最优轮数
把优化误差与数据误差合在一起(固定D、N,并假设总在最优超参数下训练),结果是:

这可以清晰看出:训得越多,优化误差越小,但数据重复越严重、泛化误差越大。于是再次根据异幂不等式,可以求得K的最优值

这提供了关于Multi-Epoch的缩放规律,结论是:数据越少,反而应该训更多轮;数据越多,最优Epoch数越小,结论跟2511.13421正好相反。一个可能的改进方案是将α₁₀(K/D)^(γ₁₀)一般化为α₁₀K^(γ₁₀)D^(−γ₁₁),此时有

这样一来,最优Epoch数随数据增加而增加/减少都有可能出现。
但即便换成α₁₀K^(γ₁₀)D^(−γ₁₁),这里也还存在一些不合理的地方,比如当K→∞时它也是趋于无穷的,但根据经验,即便我们不断训练下去,测试集损失也不应该无穷大。不过,如果只在小范围内拟合(假设Multi-Epoch数不可能太多),那么幂律假设依然可能给出实践能用的结果。
延伸思考
除了数据量D这一核心参数外,还有很多工作对数据的组成做了细致的区分,比如领域配比(2403.16952、2507.09404、2603.19149、2605.12715、2606.08167)、质量高低(2510.03313)、模态配比(2607.22043)等,这些工作五花八门,不好提炼出统一的形式,所以就不一一展开了。
相比优化和架构,数据侧的Scaling Law确实给人一种“凌乱”和“模糊”的感觉。原因不难理解:优化器的变量(η,B,T)和架构的变量(N,W,H,S)都是比较明确的数字,而数据这一块,除了数据量D是能比较准确量化外,像专业领域、质量、模态等维度,本来就没有太明确的边界,也无法用单一标量去准确刻画。
此外,从L(E|D,A,O)这一记号可以看出,D,A,O都是它的条件,也就是说,优化器变量和架构变量的变化原则上也会对数据侧的Scaling Law产生影响,各种变量相互作用,这使得我们很难能在一个“干净”的设置下,清晰地研究数据的依赖规律。
更要命的是,如果我们仔细思考,会发现“Data Scaling Law”这个命题本身就让人疑惑:为了公平测量效果,我们需要先准备一个足够有代表性的测试集,然后“装作”不知道测试集的样子,试图去研究训练数据上的“Scaling Law”,使得测试集的效果尽可能好,这个流程不管怎么看都挺莫名其妙。
小结一下
这一节我们简单介绍了数据差距的Scaling Law,主要引入了数据量D这一参数,考虑了数据量增加带来的正面作用,以及对Multi-Epoch带来过拟合风险,并跟优化误差结合在一块,推导了最优Epoch数的结果。但总的来说,数据侧的Scaling Law还有很多让人迷惑的地方,亟待深入思考。
幂律篇
到目前为止,我们所有的变化规律都假设成了“幂律”的和或积的形式,然后通过“异幂不等式”推出一些最优选择。现在回过头来看,有两个问题值得思考一下:1、为什么我们要假设变化规律是幂律形式?2、当我们引入其他条件时,为什么只考虑幂律的系数变化,而不考虑指数变化?
幂律之问
为什么是幂律?有很多研究人员试图提出更“本质”的解释,但笔者感觉很多尝试都只是将一个假设换成另一个假设,并无实质变化,比如《基于量子化假设推导模型的尺度定律(Scaling Law)》。
笔者认为,最直接的解释是:当我们确定一个变量的依赖关系是单调递减、并且只关心渐近行为时,能选择的函数其实不多,一般就是幂函数和指数函数两类。指数函数衰减得太快——用分布的语言说,它是“短尾”的——这意味着某种资源稍加投入,收益就迅速触顶,这与我们对现实世界的“体感”不符;而幂函数则是“长尾”的,它衰减得更慢,更能描述“持续投入、持续改善”的现象。
说得更哲学一些,如果这个世界是指数函数主导的,那就太无趣了:各种东西很快就达到天花板,各种投入很快失去意义。正因为是幂律主导,Scale Up的故事才生动起来。
另一个视角是,幂律等价于“无标度性”:f(λx)=λ^(−γ)f(x),函数在任何尺度下看起来都一样,而“Scaling”这个词的本义恰恰是跨尺度的规律——能担当这个角色的初等函数,似乎就只有幂律了。从实用的角度看:幂律在 log-log 坐标下是一条直线,这让它更容易拟合和可视化,以及“异幂不等式”的存在、它的最小值点和最小值本身依然还是幂律,这些都是它能成为“经验规律”的重要原因。
当然,幂律并不是唯一的答案,“数据篇”里便有论文用指数函数描述Multi-Epoch的价值衰减。只能说,幂律是大多数情况下都可以首先尝试的基本规律,如果遇到特别难以拟合的问题,我们可以再考虑作出调整。又或者说,如果我们要外推的区间并不大,那可能更重要的是函数的单调性,而不同的函数形式之间区别可能并没有那么大。
系数之问
第二个问题首次出现在“架构篇”,我们假设条件的变化,顶多对幂律的系数产生影响,比如架构的变化只对优化误差幂律的系数产生影响,MoE稀疏度的变化只对架构误差的幂律产生影响,而保持指数不变,这是出于什么考虑?有什么更本质的道理在里边?
首先是数学上的务实:如果指数也随条件变化,那么幂律形式本身就被破坏了——结果不再是幂律,异幂不等式也不再适用,整个框架会失去最简单的可操作性。只让系数变化,是保持形式不变的前提下最小的推广,是一个值得首先尝试的假设形式。
其次是物理上的类比:在统计物理中,相变的临界指数是普适的,同一普适类里的不同材料共享同一组指数,材料细节只改变非普适的前置因子。类似地,Scaling Law的指数也理解为问题本身的“难度”——它由数据分布与任务决定;而系数则是解决方案的“工程水平”——它随优化器、架构的改进而变化,而这本质上是在同一个问题上做得更好,因此改变的应当是幂律前面的系数,而不是指数。
反过来想,如果某项有限的工程改进真能改变指数,那么在渐近意义下,它带来的相对优势会随着规模增长而无界放大——有限的投入换来无界的相对收益,这相当于凭空出现指数级进步,通常是不现实的。除非这项改进改变了问题本身,但那已经不是“同一问题上的工程改进”,而是换了一个问题。
当然,这更多是笔者基于简洁性与自洽性的一个猜想,算是开放问题,欢迎讨论。
总结篇
看完这篇博客,可能有读者的感受是“好像什么都说了,又好像什么都没说。”——我们没有证明任何定理,只是写下了一个三重分解,以及凭经验写下了一堆幂律假设,然后利用最优化方法做了一些基本的分析。
我们试图以这种方式,找出各种Scaling Law结果的共性,理清楚它们的相互作用机理。幸运的是,本文也确实得到了一些启发式的结果,但限于笔者水平,多数内容只能做出粗浅的介绍,尤其是“数据篇”,笔者的理解还停留在非常肤浅的阶段。
整个推导流程走下来,个人感觉有种物理中的“量纲分析”的味道:它不像第一性原理推导那样严密,而是先凭直觉和单调性猜出各项的幂律形式,进一步推导最优解的规律,最后再对照经典结果,进行简化或修正。
希望本文的视角,能为读者理解和运用Scaling Law提供一点帮助。
参考链接
-
原文链接:https://spaces.ac.cn/archives/11833 Kaplan Law:https://papers.cool/arxiv/2001.08361
-
加权AM-GM不等式:https://en.wikipedia.org/wiki/AM%E2%80%93GM_inequality#Weighted_AM%E2%80%93GM_inequality -
2503.12645:https://papers.cool/arxiv/2503.12645 -
2603.15958:https://papers.cool/arxiv/2603.15958 -
2607.01487:https://papers.cool/arxiv/2607.01487 -
2605.09154:https://papers.cool/arxiv/2605.09154 -
Step Law:https://papers.cool/arxiv/2503.04715 -
Microsoft Law:https://papers.cool/arxiv/2409.19913 -
Chinchilla Law:https://papers.cool/arxiv/2203.15556 -
2406.12907:https://papers.cool/arxiv/2406.12907 -
记忆之层:https://spaces.ac.cn/archives/11833#%E8%AE%B0%E5%BF%86%E4%B9%8B%E5%B1%82 -
2606.25008:https://papers.cool/arxiv/2606.25008 -
2505.10465:https://papers.cool/arxiv/2505.10465 -
2602.05970:https://papers.cool/arxiv/2602.05970 -
幂律篇:https://spaces.ac.cn/archives/11833#%E5%B9%82%E5%BE%8B%E7%AF%87 -
DeepSeek Law:https://papers.cool/arxiv/2401.02954 -
2501.12370:https://papers.cool/arxiv/2501.12370 -
参考:https://www.reddit.com/r/LocalLLaMA/comments/1bqa96t/geometric_mean_prediction_of_moe_performance/ -
2202.01169:https://papers.cool/arxiv/2202.01169 -
Ling Law:https://papers.cool/arxiv/2507.17702 -
2309.08520:https://papers.cool/arxiv/2309.08520 -
2502.05172:https://papers.cool/arxiv/2502.05172 -
2402.07871:https://papers.cool/arxiv/2402.07871 -
2509.23678:https://papers.cool/arxiv/2509.23678 -
PKM:https://papers.cool/arxiv/1907.05242 -
UltraMem:https://papers.cool/arxiv/2411.12364 -
Over-Encoding:https://papers.cool/arxiv/2501.16975 -
Engram:https://papers.cool/arxiv/2601.07372 -
最优配比率:https://spaces.ac.cn/archives/11833#%E6%9C%80%E4%BC%98%E9%85%8D%E6%AF%94%E7%8E%87 -
MHC:https://papers.cool/arxiv/2512.24880 -
AttnRes:https://papers.cool/arxiv/2603.15031 -
《Prescriptive Scaling Laws for Data Constrained Training》:https://papers.cool/arxiv/2605.01640 -
《Scaling Data-Constrained Language Models》:https://papers.cool/arxiv/2305.16264 -
2511.13421:https://papers.cool/arxiv/2511.13421 -
2403.16952:https://papers.cool/arxiv/2403.16952 -
2507.09404:https://papers.cool/arxiv/2507.09404 -
2603.19149:https://papers.cool/arxiv/2603.19149 -
2605.12715:https://papers.cool/arxiv/2605.12715 -
2606.08167:https://papers.cool/arxiv/2606.08167 -
2510.03313:https://papers.cool/arxiv/2510.03313 -
2607.22043:https://papers.cool/arxiv/2607.22043 -
《基于量子化假设推导模型的尺度定律(Scaling Law)》:https://spaces.ac.cn/archives/9607 -
数据篇:https://spaces.ac.cn/archives/11833#%E6%95%B0%E6%8D%AE%E7%AF%87 -
架构篇:https://spaces.ac.cn/archives/11833#%E6%9E%B6%E6%9E%84%E7%AF%87