


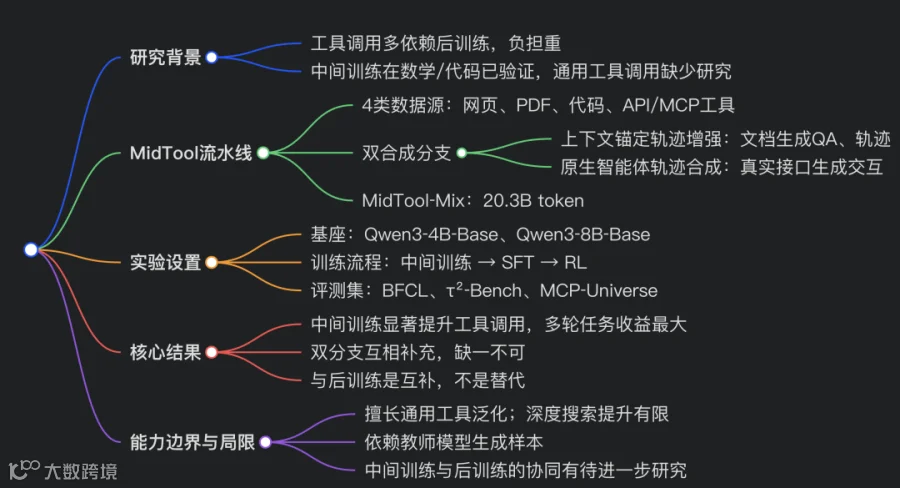
编者摘要:MidTool 是面向大模型智能体工具调用中间训练的开源数据集构建流水线,产出 203 亿 token 混合数据集 MidTool‑Mix。现有工具调用能力大多依靠后训练(SFT/RL)习得,给后训练带来巨大负担;该工作提出在预训练与后训练之间插入工具导向中间训练,提前打下工具调用基础先验。
数据集融合网页、PDF、代码、API/MCP 工具四类数据源,采用双分支合成:
①上下文锚定轨迹增强,从文档提取工具知识;
②原生智能体轨迹合成,基于真实接口生成多轮交互样本。在 Qwen3‑4B/8B 基座模型开展实验,经过 MidTool‑Mix 中间训练后,再做 SFT、RL,在 BFCL、τ²‑Bench、MCP‑Universe 评测集稳定提升性能,多轮复杂交互增益最大。消融证明两条合成分支缺一不可。同时发现能力边界:数据集擅长通用工具、陌生 API 泛化,但深度搜索类探索任务提升有限,这类任务还需要专项训练数据。该方案不是替代后训练,而是与后训练互补。
7 个关键问题问与答
Q1:什么是中间训练(Mid‑training)?
A:介于通用预训练和后训练(SFT/RL)之间的训练阶段,使用领域定向大规模语料继续训练基座模型,提前注入特定能力先验,降低后训练学习压力。
Q2:为什么要做工具调用的中间训练,全部交给 SFT/RL 不行吗?
A:仅靠后训练,模型要在少量交互样本同时学习工具识别、参数提取、多步规划、故障恢复;大量工具知识分散在文档、代码,不在交互轨迹中;中间训练提前构建工具先验,减轻后训练负担。
Q3:MidTool‑Mix 两大合成分支分别解决什么问题?
A:①上下文锚定轨迹增强:从网页 / PDF / 代码文档学习识别工具、推断参数;②原生智能体轨迹合成:基于真实 API/MCP,学习多轮规划、信息澄清、工具执行恢复。两个分支互补,缺一不可。
Q4:MidTool 实验得到的核心性能结论是什么?
A:对 4B、8B 基座,经过 MidTool‑Mix 中间训练,后续 SFT、RL 在三项评测集性能均提升;多轮、复杂交互任务增益最明显;RL 会进一步放大中间训练带来的收益。
Q5:MidTool 揭示了怎样的智能体能力边界?
A:该数据集极大提升通用工具、陌生 MCP 工具的泛化;但深度搜索这类长周期探索任务几乎无提升。说明通用工具先验不能覆盖全部智能体能力,搜索类任务需要专门训练数据。
Q6:MidTool 中间训练是否可以完全取代 SFT、RL 后训练?
A:不能。二者是互补而非替代。中间训练提供更好的模型初始化与工具先验,仍然需要 SFT 做对齐、RL 进一步优化智能体策略。
Q7:MidTool 存在哪些主要局限?
A:轨迹合成依赖强教师模型;没有系统探索中间训练数据集和下游 SFT/RL 数据集的协同关系;对深度搜索等高探索任务效果弱,需要额外专项数据。
附录 MidTool:面向智能体工具调用的中间训练数据合成

冯庆 ¹†,王亦特 ²,刘博毅 ²,王兆阳 ³†,徐灿文 ²,姚哲伟 ²,拉达・普温德兰 ¹‡,何玉雄 ²‡ ¹ 华盛顿大学 ²Snowflake 公司 ³ 北卡罗来纳大学教堂山分校 †该作者在 Snowflake 任职期间完成本工作 ‡共同指导
摘要 中间训练(Mid‑training)正被越来越多地视为塑造大语言模型能力的关键阶段。已有研究表明,定向中间训练可以强化数学、科学这类推理密集型能力,同样也能提升软件工程场景下的智能体能力。本文研究另一块探索较少的平行方向:通用工具调用的智能体能力。本文提出 MidTool,一套面向智能体工具调用中间训练的开源数据集构建流水线,融合大规模网页、PDF、代码数据,结合真实应用程序接口、MCP 技能、文档驱动工作流生成监督信号。MidTool 旨在教会模型识别工具可用能力、从上下文提取参数、编排工具调用工作流、在信息不全时做故障恢复。我们使用 MidTool‑Mix 数据集对 Qwen3‑4B‑Base、Qwen3‑8B‑Base 开展中间训练,后续再执行监督微调与强化学习的后训练流程。在 BFCL、τ²‑Bench、MCP‑Universe 多个评测集上,无论是监督微调还是强化学习设置,基于 MidTool‑Mix 训练得到的模型相比基线均取得稳定性能提升。实验结果说明:和其他大模型核心能力一样,通用工具调用能力可以通过专门的中间训练得到增强,而不是完全交由后训练阶段实现。
联系邮箱:yite.wang@snowflake.com 数据与模型:https://hf.co/collections/MidTool/midtool‑release

图 1左:MidTool‑Mix 是拥有 203 亿 token 的中间训练语料,数据源来自网页、PDF、代码、工具,附带合成得到的智能体交互轨迹。中间:从基座模型出发的完整训练流水线。右:MCP‑Universe 评测结果,经过 MidTool 中间训练的 4B、8B 模型性能超过官方 Qwen3 模型,证明专门的中间训练相比单纯扩大模型规模,可以获得更强的智能体能力。
arXiv:2608.20314v1 [cs.AI] 2026‑08‑20
1 引言
工具调用已经成为大语言模型智能体的标志性能力。高性能系统需要自主判断何时调用外部工具、基于工具模式生成调用、从冗长嘈杂的上下文抽取入参、将多个工具编排成完整工作流,信息缺失时能够做故障恢复。这类能力广泛作用于函数调用、API 编排、交互式智能体评测,以及新兴的模型上下文协议(MCP)生态系统。
然而目前工具调用领域的多数进展来自后训练阶段:在整理好的交互轨迹上做监督微调(SFT)、强化学习(RL),确实大幅提升了函数调用与智能体表现,但这也给后训练带来巨大负担。模型需要在有限监督样本下,同时学会一系列基础智能体能力:识别工具、基于模式构造参数、信息缺失时澄清问题、多步执行。更本质的一点:支撑工具调用的底层知识不只存在于显式交互轨迹中,还分散在开发者文档、手册、PDF 文档、代码仓库、API 接口说明、结构化工具定义里,其中绝大多数都没有整理成干净的智能体演示样本。
由此引出一个关键问题:通用工具调用能力,是否可以通过专门的中间训练更早塑造,而不是几乎全部交给后训练?中间训练属于多阶段预训练的一个独立环节,衔接通用预训练与后训练阶段。现有工作证明定向中间训练可以显著提升推理能力;也有部分工作探索面向深度研究、代码、软件工程的智能体中间训练。但是通用工具调用作为中间训练目标,仍少有研究。对比数学、软件工程任务,工具调用的数据需要覆盖更广、异构性更强的能力集合:自然语言文档、可执行代码范式、结构化模式、多工具工作流、信息缺失带来的各类失败案例。
本文提出 MidTool,一套可扩展的流水线,用于构建面向通用工具调用的智能体中间训练数据;同时产出 MidTool‑Mix,总规模 203 亿 token 混合数据集。流水线的输入来自四类互补数据源:网页、PDF、代码仓库、API/MCP 技能等结构化工具产物。通过两条合成分支生成训练监督信号,分别解决工具调用两大核心短板:上下文锚定(grounding)与执行(execution)。
- 上下文锚定轨迹增强分支
把文档、代码转为监督信号,训练模型识别工具边界、推断参数、从杂乱真实素材还原工作流结构,解决锚定问题。 - 原生智能体轨迹合成分支
直接基于真实 API、MCP 技能、采集的交互样本生成可执行交互轨迹,训练多轮规划、信息澄清、故障恢复,严格校验模式匹配、轮次顺序、必填参数、工具返回一致性,解决执行问题。
该混合数据集不只是告诉模型有哪些工具,更教会模型一系列基础智能体能力:识别工具的可用能力、编排工具工作流、信息不全时恢复执行。
表 1主流预训练 (PT)/ 中间训练 (MT) 开源语料对比。Tool Div.= 工具多样性;Agent Traj.= 是否包含智能体交互轨迹;✓代表有,✗代表无。
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
我们选取 Qwen3‑4B‑Base、Qwen3‑8B‑Base 基座模型,使用 MidTool‑Mix 执行中间训练,之后统一使用相同的监督微调、可选强化学习流程。在 BFCL、τ²‑Bench、MCP‑Universe 三项评测上得到一致结论:相比只做后训练的基线,经过 MidTool‑Mix 中间训练的模型下游工具调用性能全面提升,强化学习会进一步放大增益;在难度更高的多轮交互场景提升尤为显著。
本文主要贡献有三点:
-
提出 MidTool,据我们所知是首个面向通用工具调用的开源流水线与中间训练数据集;构建 MidTool‑Mix(203 亿 token),融合网页、PDF、代码、工具素材,同时包含上下文锚定增强、原生智能体交互轨迹。 -
实验证明:对 4B、8B 规模模型,专门的工具调用中间训练,在监督微调、强化学习两种设置下,都稳定提升下游通用工具调用效果;中间训练能够为后续后训练提供更强、更稳定的模型基础。 -
揭示一条清晰的能力边界:MidTool‑Mix 对通用工具调用、跨域迁移提升效果最好,但高度探索类任务能力提升有限。说明深度搜索这类任务,还需要专门的中间训练数据,为后续智能体中间训练研究提供实证指导。
2 MidTool:面向智能体中间训练数据合成的可扩展流水线
本章介绍构建大规模中间训练语料的完整流水线:数据源采集、数据预处理、智能体轨迹合成。
2.1 阶段一:数据源采集

图 2 MidTool 流水线总览阶段 1 采集四类互补数据源:网页、PDF、代码仓库、结构化工具产物。 阶段 2 针对不同数据源做预处理、质量过滤、去重。 阶段 3 将处理后语料转为可执行监督样本,分为两条分支:从网页 / PDF / 代码生成上下文锚定轨迹增强样本;基于真实 API、MCP 技能生成原生智能体轨迹合成样本。
有效的工具调用能力不只依赖显式交互轨迹,还需要广泛的技术知识、工具文档、可执行代码范式、工具结构化模式。因此我们收集四类数据源:
网页数据:使用 FineWeb 处理后的 Common Crawl 网页转储,采样 2020‑2025 年多份快照,覆盖 API 参考、开发者文档、故障排查页面、教程、命令行说明。网页语料大规模提供工具相关概念、术语、工作流描述。
PDF 数据:大量高价值手册、产品说明、平台文档以 PDF 格式分发,而不是网页 HTML。使用 FinePDFs 数据集,只保留英文子集。PDF 提供长流程文档,但文本提取噪声更大,需要更严格过滤。
代码数据:工具调用与软件制品紧密相关。基于 Snowflake GH Archive 事件数据获取 GitHub 仓库,做任务定向过滤。分为两部分:①智能体、MCP 相关仓库,筛选活跃度、更新时间、许可证;②Python、Java、JS、Go 等主流编程语言高质量开源库,保留 SDK、框架、示例、教学技术内容;剔除个人项目、fork 副本、评测数据集仓库,维护黑名单排除评测相关仓库,避免数据泄露。
工具数据:单独收集 REST API、MCP 技能等结构化工具产物,用于原生智能体轨迹合成。这类素材直接提供可执行模式、参数结构、工具边界,是生成真实工具调用、多工具规划、故障恢复样本的最佳基底。
四类数据源实现广度与结构化的互补:网页、PDF 提供宽泛技术上下文;代码仓库提供可执行范式与开发者工作流;工具产物提供显式模式和可调用接口。后续预处理、合成环节把异构原始数据统一转化为智能体中间训练混合语料。
2.2 阶段二:数据预处理
代码数据:参考 StarCoder 的多阶段过滤,排除二进制文件、模型权重、日志;基于行数、行平均长度、字母占比做内容过滤;Jupyter Notebook 转换为 Python 文本。使用 SHA‑256 哈希精确去重,MinHash LSH 做近似去重。优先保留docs、examples、tutorials这类文档目录。
网页与 PDF 数据:四阶段流水线:高召回关键词 / URL 预筛选;基于大模型标注种子数据训练 fastText 轻量分类器;文档级质量过滤;MinHash LSH 近似去重。目的是保留开发者文档、技术参考,过滤普通网页噪声与 PDF 解析垃圾;PDF 使用更严苛阈值。详细见附录 A.2。
2.3 阶段三:智能体轨迹合成
有效的工具调用中间训练需要同时解决两大短板:
- 锚定问题
模型很难从文档、PDF、代码这类杂乱素材推断工具边界、必填参数、工作流结构。 - 执行问题
即便拿到工具模式,模型依旧难以做多轮规划、请求缺失信息、正确排序调用、处理不完整交互。
因此流水线设置两条合成分支,把非结构化文档、结构化工具素材转化为标准化智能体交互轨迹。
上下文锚定轨迹增强分支
网页、PDF、代码文档描述工具能力和工作流,但没有现成交互轨迹,作为锚定分支的输入。 先做轻量关键词预过滤;调用 Qwen3‑235B‑A22B‑Instruct‑2507 给文档打分,输出结构化能力画像:记录是否可以推断工具返回结果、API / 代码 / 命令行用法、工作流结构、工具拓扑、领域术语。质量不达标的文档直接保留原始文本,不做增强;高质量文档交由基于规则的规划器,提取能力信息生成合成方案。
规划器依据文档质量分配生成样本量,限制每份文档最多生成一条多轮交互链。普通问答将工具调用拆解为基础能力:工具选择、基于模式抽取参数、格式约束调用、工作流识别、并行多工具调用;轨迹样本覆盖顺序执行、参数澄清、工具切换、长上下文推理。由大模型合成样本,经过解析校验、语义质量质控后,并入最终训练集。
原生智能体轨迹合成分支
面向 API 集合、MCP 技能这类结构化工具源,专门训练执行与规划能力。 首先构建工具清单,对接口、技能分组,解析工具定义,轻量过滤低质量素材。使用 GPT‑5 做质量打分,评估可生成的轨迹类型:简单单工具调用、复杂并行多工具调用、信息缺失场景。
过滤通过的素材,提取开发者文档,标准化工具模式,对描述模糊的参数做模式补全。生成多样化用户角色,模型给出候选轨迹方案;由确定性、感知质量的预算控制器最终分配样本,优先生成多轮轨迹,避免大量简单样本。使用 GPT‑5 系列模型生成轨迹。生成结果严格校验轮次顺序、模式匹配、必填参数、工具返回一致性;不合格样本会带着质控反馈重试,仍失败则丢弃。
同时混入 Agent World Model (AWM) 合成环境产出的交互轨迹,以及过滤后的 Nemotron Agentic 数据集,进一步扩充原生轨迹部分。
2.4 MidTool‑Mix 数据集分析
最终混合数据集包含三部分:①过滤后的网页、PDF、代码原始语料;②从文档衍生的上下文锚定问答与交互轨迹;③原生智能体轨迹(合成轨迹、AWM 交互样本、过滤后的 Nemotron Agentic 数据)。所有轨迹统一转为普通聊天模板,不引入特殊控制 token。
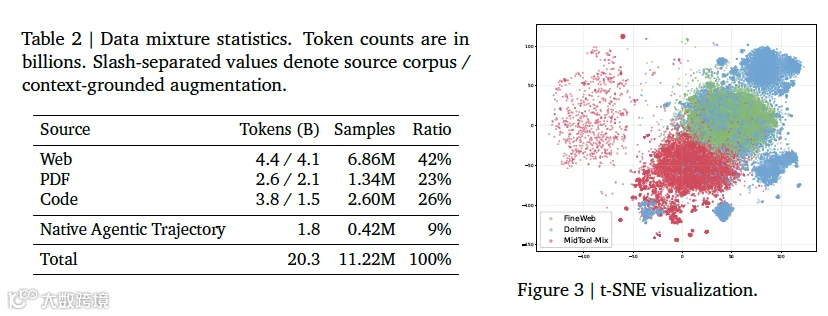
表 2 MidTool‑Mix 数据统计,token 单位为十亿。斜杠前后代表原始源语料 / 上下文锚定增强部分。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
整体 203 亿 token,1122 万样本。网页占 42%,代码 26%,PDF23%,原生轨迹占 9%。既保留大量文档用于上下文锚定,又保留可观比例的可执行智能体监督样本。附录 A.4 提供增强类型、轨迹形态、工具清单的细粒度统计。
图 3 t‑SNE 嵌入可视化,对比 FineWeb、Dolmino、MidTool‑Mix,每个数据集采样 2000 条,使用 Arctic‑Embed‑2.0‑L 得到向量。MidTool‑Mix 和两个基线存在部分重叠(因为同样使用网页技术文本);Dolmino 独特区域对应数学科学推理内容,而 MidTool‑Mix 占据独有的向量空间,分布偏向文档、工作流、智能体工具调用内容。同时校验确认数据集不存在评测集泄露,详见附录 A.3。
3 实验
3.1 实验设置
不同于以往把工具调用完全作为后训练任务,本文从基座模型出发,在中间训练阶段注入工具调用能力。选用 Qwen3‑4B‑Base、Qwen3‑8B‑Base 基座。对比四套训练流程:
-
原始基座模型 + SFT(可选 RL) -
基座模型经过 MidTool‑Mix 中间训练 + SFT(可选 RL)
监督微调 SFT 使用 TOUCAN 数据集采样的 10 万条工具调用样本。中间训练、SFT 使用 ArcticTraining,32 张 H200 GPU;智能体强化学习 RL 基于 AWM 框架,526 个合成工具环境,8 张 B200 GPU。详细超参见附录 B。同时对比官方发布的 Qwen3‑4B、Qwen3‑8B 模型,关闭思考模块对齐实验条件。
评测基准:三项互补评测集
- BFCLv3
评测单轮、多轮函数调用质量,重点考察工具选择、参数构造、幻觉问题。 - τ²‑Bench
航空、零售、电信等真实业务交互式任务,考验多步执行与故障恢复。 - MCP‑Universe
对接真实 MCP 服务,覆盖浏览器自动化、金融、位置、网页搜索,检验分布外工具泛化能力。
3.2 主要实验结果
表 3 BFCLv3 结果,Qwen3‑4B、8B 基座,对比有无 MidTool 中间训练,SFT / SFT+RL 设置;数值为百分比,越高越好。指标包含单轮(非在线 / 在线);多轮(缺失函数 MF、缺失参数 MP、长上下文 LC,多轮平均);幻觉;整体得分。
实验呈现一致规律:相比仅 SFT 基线,MidTool‑Mix 中间训练带来下游智能体工具调用性能提升;再叠加 RL 会进一步放大收益。提升集中在长交互、严格模式匹配、陌生工具适配这类高难度子集。附录 C 给出训练动态;附录 C.3 包含视觉工具调用初步探索。
中间训练带来单纯后训练无法充分获得的能力。在 BFCL 评测,中间训练后再做 SFT,4B、8B 模型整体得分显著上涨;多轮子集增益最大:4B 模型多轮平均分相比纯 SFT 基线提升超 10 个百分点;8B 模型 MidTool‑Mix+SFT+RL 取得最优多轮表现。增益集中在高难度多步场景,说明中间训练能够提供后训练难以充分习得的基础智能体能力:扎实的基础能力锚定、长交互下的规划执行。
能力可以迁移到真实智能体任务。τ²‑Bench、MCP‑Universe 比 BFCL 更贴近真实复杂场景。τ²‑Bench 中,4B 模型经过中间训练后整体 Pass@1 几乎翻倍;8B 同样取得明显 Pass@1/Pass@4 提升,航空、零售场景收益最大,电信任务依旧很难。MCP‑Universe 上,4B、8B 模型整体分数、通过率均上涨,RL 之后增益更加明显。证明 MidTool‑Mix 不只是提升函数调用,而是学到一套通用先验,能够对接真实环境、从未见过的工具生态。
通用工具调用中间训练揭示清晰能力边界:MCP‑Universe 的网页搜索子集分数始终为 0。浏览器自动化、金融、位置等其他 MCP 领域都有明显提升,说明不是 MCP 工具整体迁移失败;而是区分出一类特殊智能体行为:深度搜索任务,需要长周期证据搜集、迭代修正、强智能体控制流。 实证得到智能体能力结构规律:通用工具调用监督可以教会模型模式匹配、工具选择、陌生 API 交互的通用先验;但高度探索类任务还需要专门的轨迹与训练目标。MidTool‑Mix 帮助划分通用工具调用与专用智能体能力的边界,为搜索类专项中间训练提供启发。
3.3 消融实验
表 4 消融实验(Qwen3‑4B‑Base + SFT 固定,仅改变中间训练语料)配置:无中间训练;Dolmino‑20BT(同等 token 规模通用中间训练基线);MidTool 系列:仅处理后原始素材(无合成轨迹);原始素材 + 原生智能体轨迹;原始素材 + 上下文锚定轨迹;完整 MidTool‑Mix。
两条合成分支作用互补。只使用过滤后的原始数据源,不做任何轨迹合成,相比无中间训练也能带来正向收益,效果接近 Dolmino‑20BT,并且在 MCP‑Universe 迁移效果显著优于 Dolmino。单独任意一条分支都有提升,但各有短板:
-
仅加入原生智能体轨迹:BFCL 提升更大,擅长精确函数调用;但多轮、τ²‑Bench、MCP‑Universe 表现受损。 -
仅加入上下文锚定增强:在 τ²‑Bench、MCP‑Universe 迁移效果更强,擅长泛化。
只有合并两条分支的完整 MidTool‑Mix,才能在全部 8 项指标上超过无中间训练基线。Dolmino‑20BT 这类通用中间训练可以改善简单函数调用,但向复杂智能体任务迁移很差。说明收益不只是来自额外训练 token,而是数据集本身面向工具调用的特殊构造。同时消融也证明:MidTool‑Mix 的收益不完全来自闭源大模型合成的原生轨迹,原始文档素材、上下文锚定增强同样贡献关键增益。
4 相关工作
面向智能体能力的中间训练
前沿模型的智能体能力不只是后训练产物,还依赖基座模型之上大规模定向能力塑造。已有工作开展面向长上下文推理、深度研究、软件工程智能体的中间训练。Dolmino 侧重通用高质量数据,重点做数学科学推理。本文与之不同:构建一套专门面向通用工具调用的开源中间训练数据集与流水线。
工具调用后训练数据集
早期工具调用数据集基于工具定义、模型自标注生成样本,代表工作 Toolformer、ToolLLM、APIGen。后续数据集逐步从单轮调用拓展到多轮交互轨迹,AgentBank、ToolACE、APIGen‑MT、TOUCAN、Simia 等产出大量高质量后训练微调样本。 本工作与上述研究形成互补:我们聚焦中间训练阶段,产出开源流水线与数据集,给模型建立工具调用的底层先验,可以和下游后训练数据集、目标协同发挥作用。
5 结论
本文研究通用工具调用能力是否可以通过专门中间训练获得提升,而不是全部交给后训练。提出可扩展数据集构建流水线 MidTool,产出 203 亿 token 的 MidTool‑Mix,融合过滤后的原始数据源、上下文锚定增强、原生智能体交互轨迹。 在 4B、8B 基座模型上实验:使用 MidTool‑Mix 做中间训练,无论后续做 SFT 还是 RL,在 BFCL、τ²‑Bench、MCP‑Universe 评测上稳定提升,多轮交互场景收益尤为突出。中间训练不是替代后训练,而是和后训练互补;应当同时推进后训练监督样本扩充与工具调用中间训练。
消融证明两条合成分支缺一不可:锚定导向、执行导向的监督信号互为补充。同时发现能力边界:MidTool‑Mix 显著提升陌生工具、MCP 多域泛化,但对深度搜索这类强探索任务增益有限。说明通用工具调用中间训练提供模式匹配、工作流编排的可复用先验;高度探索类任务需要专门轨迹数据。未来方向:扩充原生轨迹规模、拓宽工具生态覆盖、为垂直领域智能体行为构建专用中间训练混合数据集。
附录 A MidTool 流水线补充细节
A.1 数据采集阶段的评测集排除
在 GitHub 代码数据采集环节维护黑名单,把 BFCL、τ²‑Bench、MCP‑Universe 等评测相关仓库直接跳过,黑名单在流水线执行阶段生效,不是事后过滤,并且持续更新黑名单,防止评测数据泄露进入训练集。
A.2 网页与 PDF 过滤流水线
四阶段:①高召回预筛选:开发术语关键词、文档类 URL 模式,优先保留 API 参考、SDK 文档、排错问答;②fastText 分类器:使用 Qwen2.5‑7B‑Instruct 标注种子样本训练分类器,PDF 使用更严格阈值;③文档质量过滤:语言置信度、长度、符号密度、代码占比,PDF 额外增加 OCR 质量过滤;④MinHash LSH 去重。
A.3 事后污染检测分析
黑名单只处理代码仓库,网页、PDF、模型合成样本仍可能引入泄露。使用 DeCon 工具扫描全部训练数据对照 BFCLv3、τ²‑Bench、MCP‑Universe。总共只出现不到 20 个疑似命中,全部来自网页切片,人工复核全部为假阳性,只是普通 API 文档文本 n‑gram 重合,不存在评测样例泄露。该检测只能检测字面重合,语义、模式层面的相似无法覆盖,留作未来工作。
A.4 MidTool‑Mix 构成分析
表 7 各数据源切片的增强类型占比(样本内占比)source‑only:仅原始文档;+QA:增加问答;+QA+traj:问答 + 完整交互轨迹
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
网页切片以 QA 增强为主;PDF 切片拥有最高比例完整交互轨迹;代码切片大部分保留原始源码,工具调用信号蕴含在原始代码内。
表 8 包含智能体轨迹的样本统计turn = 用户轮次;step = 助手消息;tool call = 单次工具调用
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
由文档生成的上下文锚定轨迹,每一轮用户提问下助手步骤、工具调用数量更多;而原生轨迹的用户交互轮次更长。
表 9 工具调用功能分类统计(关键词映射)37.2% 属于长尾领域特有工具,体现数据集工具多样性,区别于很多固定工具集的后训练数据集。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
附录 B 实验详细参数
表 10 中间训练超参,Qwen3‑4B‑Base / Qwen3‑8B‑Base 共用| 超参 | 取值 | |---|---| | 轮数 | 1| | 最大序列长度 | 8192| | 优化器 | AdamW| | 学习率 | 3 × 10⁻⁵| |Betas|(0.9, 0.999)| | 权重衰减 | 0.01| | 学习率调度 | WSD| | 预热步数 | 50| | 全局 token 批大小 | 4M token(开启数据打包)|
表 11 监督微调 SFT 超参| 超参 | 取值 | |---|---| | 最大序列长度 | 32768| | 优化器 | AdamW| | 学习率 | 2 × 10⁻⁵| |Betas|(0.9, 0.95)| | 权重衰减 | 0.01| | 学习率调度 | cosine 余弦衰减,预热比例 0.001| | 训练 batch size|128|
表 12 RL 强化学习超参| 超参 | 取值 | |---|---| |RL 算法 | GRPO| | 总训练步数 | 64| | 学习率 | 4B:1 × 10⁻⁶;8B:5 × 10⁻⁷| | 数据 batch size|32| |PPO 小批次大小 | 32| | 每个 prompt 生成 rollout 样本 | 16| |KL 系数 | 0.001| | 熵系数 | 0.0| | 截断上限 | 0.28| | 历史窗口限制 | 3| | 最大智能体交互轮次 | 20|
附录 C 更多实验分析
C.1 SFT 收敛性分析
图 4 SFT 损失曲线对比:Qwen3‑4B 三种初始化:原始基座;Dolmino 中间训练;MidTool‑Mix 中间训练。三者下游 SFT 数据集、优化器完全一致。MidTool‑Mix 初始化起点损失最低,前期下降速度最快,全程损失最优。
说明工具导向的中间训练,给下游 SFT 提供更好的初始化,优化收敛更高效。Dolmino 通用中间训练优于原始基座,但收敛弱于 MidTool‑Mix。这说明收益不只是来自额外训练 token,而是数据集带来的工具调用归纳偏置。注意 SFT 损失只是下一个 token 预测损失,不等于工具调用能力;最终能力结论以评测指标为准。
C.2 RL 奖励分析
图 5 RL 训练过程平均奖励曲线(4B、8B)MidTool‑Mix 初始化得到更高初始奖励,RL 前期适应速度远快于基线基座模型。训练后期环境内奖励差距缩小,但环境内奖励趋同不等于下游泛化能力等价。RL 后期在训练环境内的奖励可以追平,但在 BFCL、τ²‑Bench、MCP‑Universe 的跨评测集上,经过 MidTool 中间训练的模型依旧保持显著优势。中间训练的核心价值,不只是 RL 阶段更快拿到环境奖励,而是强化 RL 之后的通用泛化能力。
C.3 视觉工具调用先导实验
把 MidTool‑Mix 文本中间训练迁移到多模态基座 gemma‑3‑4b‑pt,中间训练和 SFT 都不包含任何视觉工具样本,后续在 FineVision 子集微调,再做文本工具 SFT。在 VisualToolBench 单轮子集评测: 工具调用成功率从 0.5863 提升至 0.7231;综合评分从 0.0567 提升至 0.0661。证明文本工具调用中间训练存在跨模态迁移信号。同时也观察到缺陷:模型可以调用视觉工具,但并不总是把工具返回结果融入最终回答,和 MCP‑Universe 网页搜索的现象一致。未来可以增加大量代码驱动的视觉工具调用中间训练样本,并且增加显式监督信号,教会模型基于工具返回结果生成最终答案。
表 13 VisualToolBench 单轮子集先导实验结果
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
附录 D 局限与未来工作
- 中间训练与后训练协同设计
本文固定下游后训练流程,只隔离中间训练效果。尚未系统研究 SFT 数据集构成、RL 环境、奖励函数如何和中间训练语料相互作用,这是最重要的后续方向。 - 固定 token 预算下的完整设计空间探索
本消融实验还有更多变量有待控制实验,例如去掉上下文的纯 QA 样本、同等算力通用技术文档基线、全原生轨迹数据集。但全规模原生轨迹数据集需要海量可执行环境,工程成本很高。 - 降低对强教师模型依赖
目前两条合成分支依赖教师大模型。随着开源智能体模型进步,可以逐步用更小开源模型甚至自生成做数据合成;能够自生成高质量中间训练数据本身,也是衡量智能体模型成熟度的指标。 - 超越通用工具调用
本文证明通用工具先验存在能力边界;深度搜索、垂直领域智能体工作流需要专门监督。把中间训练范式拓展到这类专项任务,是本文希望推动的研究方向。
文中图 6、图 7 为样本示例:图 6 为网页来源训练样本,包含原始文档、QA 问答、多轮工具调用轨迹;图 7 为原生智能体轨迹样例,浏览器调试复现网站下单按钮卡死 bug 的完整交互。
参考文献(略)