


Articuler.ai 扎根硅谷,致力于打造 AI 驱动的职业 Networking 平台。其核心逻辑是从用户当前聚焦的问题出发,精准匹配能推动事情向前发展的关键人物,将一次简单的匹配转化为真实的对话与机会。
其试图解决的具体痛点是:在线下活动中,如何快速找到你最应该认识的那个人?
创始人申哲先将传统线下社交状态形容为「一群原始人围着篝火跳舞」:一群拥有弱关系的人被聚集在同一时空,却缺乏一套高效的分发网络来告知彼此谁该认识谁。
目前,团队已与 OpenAI、YC、AASF、AGI Summit 等顶级机构及活动达成合作,协助参与者在线下场景中找到最具价值的建联对象。
用团队的话来说:「我们在帮全世界 18 亿白领,拿到职业生涯里的大结果。」
聚焦线下活动的社交痛点以切入职场 Networking,是 Articuler.ai 找到的可规模化场景。在本次融资宣布之际,我们对话了创始人申哲先,探讨其为何坚持职场社交赛道,以及在过去一年中踩过的坑与看到的新信号,深入理解 AI 驱动的职场 Networking 未来。
我们将通过「AI 产品市集」、内容报道、社群分发等方式,助力项目触达早期用户、获取真实反馈并建立关键连接。
如果您正在从事 AI 相关领域,欢迎与我们交流。
01
活动只把人聚在一起,需要解决的是谁该认识谁
活动并不缺人,缺的是有效分发。
从供给端看,活动几乎是完美的 networking 场景。主办方围绕特定主题,将投资人、创业者、潜在客户及行业从业者聚集于同一空间。参与者愿花费半天甚至数天时间到场,通常也带着明确目的:找项目、找客户、招人、求职或结识潜在合作伙伴。
然而进入会场后,交流仍高度依赖熟人、站位和偶然性。外向者主动搭话,拥有成熟网络者通过朋友引荐,而大多数人只能拿着咖啡闲逛,最终往往仍与原相识者交谈。这并非组织问题,也难以仅靠一份参会名单解决。数百个名字、公司和职位只能告知用户「都有谁」,却无法判断谁与自己的目标最相关。
两位创始人可能处于不同阶段,一人需融资,另一人找 CMO;投资人的兴趣方向也不会印在胸牌上。在仅有几分钟的判断窗口内,无人能逐一研究数百名参会者的背景。
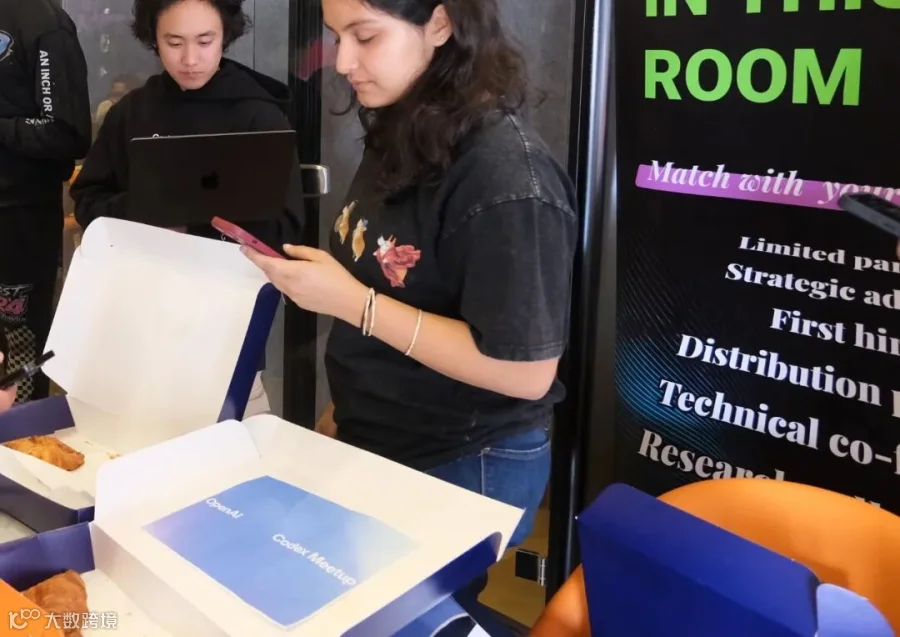
OpenAI 携手 Articuler.ai 打造 Codex Community Build Night
Articuler.ai 在活动场景中主要做了两件事:
第一,帮主办方寻找目标观众。主办方提出期望吸引的人群(如科学家、创业者、大厂从业者或某类投资人),Articuler.ai 则从公开职业信息中筛选并邀约,根据活动主题精准触达相应人群。
据申哲先透露,目前定向邀约成功率约 20%,即平均每发出 5 封邮件可带来 1 名观众。在部分合作活动中,30% 至 50% 的报名流量来自 Articuler.ai 的邀约。
第二,帮助已报名的观众彼此匹配。参会者报名时需填写职业背景和参会目标。系统结合活动主题、双方经历及当前需求,推荐更值得优先认识的人选。
活动开始前一日,参会者会收到一封邮件,列出现场与其目标高度匹配的人员及推荐理由。可能是对方正在寻找类似背景的人,也可能是两人存在多个契合点。
在现场,匹配还可被组织成更小范围的交流。例如安排特定时段让投资人与投资人、投资人与创始人分别交流;或在公共区域设置小桌,每桌安排五六名彼此相关的人。申哲先将此设计概括为用户提供「一个更小的时空」。
关系未必只发生在现场。参会者可提前查看匹配结果并预约见面;若现场未聊完,活动结束后亦可继续联系。对主办方而言,活动的价值也从单纯的报名量和到场人数,延伸至究竟促成了哪些实质性关系。
这套机制带来的直接变化是:用户有了更明确的到场理由。
在美国,许多免费活动的出席率通常不高,30% 已是可接受水平。而 Articuler.ai 合作的几场活动将出席率提升至 60%。有主办方反馈,接入匹配服务后,实际到场人数远超预期,甚至出现场地不够用的情况。与 Articuler.ai 合作过的主办方,后续活动大多会复用该项服务。
参会者也愿意为匹配结果付费。免费用户仅能看到排名前 3 的推荐且无法获取联系方式,解锁更多推荐需付费。由于参与此类活动本身带有重要而具体的目标,用户付费意愿明确。目前,Articuler.ai 面向活动场景的付费率已超过两位数。正如申哲先所言:「花一杯咖啡的钱,看到今晚所有值得认识的人,这是一个很容易做出的决定。」
活动负责把人聚在一起,Articuler.ai 则补全了人到场之后的有效分发环节。
02
Agent 能不能找对人,取决于系统如何理解一个人
活动将匹配范围缩小至几百人的会场,但底层问题未变:系统如何判断谁与谁真正相关?
上一代找人产品(无论是猎头工具还是 LinkedIn)的核心逻辑均为关键词检索,即将人压缩为 Job Title、公司、学校等标签,再通过 SQL 查询完成匹配。
如今不少 AI 找人工具仍沿用此数据结构,仅在数据库与用户间加入大模型层。用户用自然语言描述需求,大模型将其转化为 SQL 或搜索关键词,从原有数据库召回候选人,再交由 Agent 阅读、筛选和排序。
申哲先认为,该路径的瓶颈不完全在于模型,而在于更早的数据结构。
例如用户想找「投资人」,系统会搜索 Job Title 等于该词的人。召回结果可能包含桥水基金的 Hedge Fund 经理、KKR 的 PE 投资者,虽也有 VC 背景者,但具体基金方向仍需二次核实。满足最低条件的可能有数万人,却未必能匹配用户的阶段、方向和需求。
若初始召回已出现偏差,后续 Agent 再擅长推理,也无法找回从未进入候选池的人。
「上一代的数据结构用来表达人是有问题的。它把人压缩成一组标签,在此过程中损失了太多语义信息和模态信息。」申哲先指出。
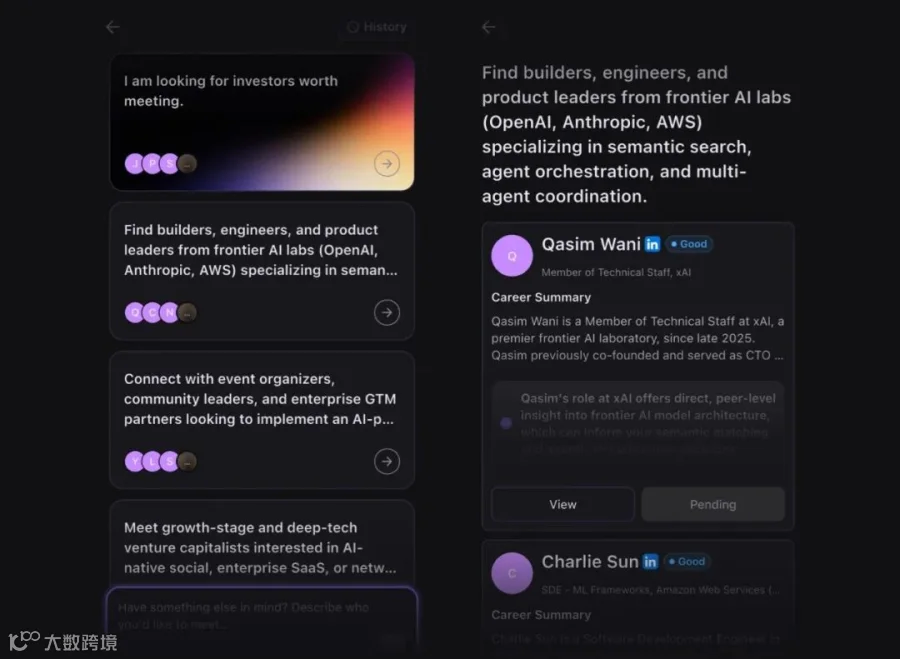
Articuler.ai 选择用 Embedding 模型将每个人表达为 8000 多维的向量。向量中既包含个人背景,也涵盖对其当下意图的判断。更重要的是,这些信息可被直接计算。
第一类信息源自公开职业资料,包括 LinkedIn、GitHub、Google Scholar、arXiv 及社交媒体。它们共同构成一个人的职业身份:过往工作经历、参与项目、研究方向及具备能力。依靠这些公开数据,Articuler.ai 从第一天起就能在近 10 亿人范围内寻找相关对象。
第二类信息来自个人的互联网足迹,包括其与所在公司、产品及行业的关系。理解一名潜在客户不能仅看职位,还需关注其公司近期动态、产品进入的市场及行业变化。这些动态信息共同构成了判断一个人当下意图的信号。
当用户提出具体目标,Articuler.ai 的 Agent 会动态制定匹配策略,在 8000 多个维度中提高与当前任务相关维度的权重,忽略不相关信息。
活动场景还提供了一类公开资料中没有的数据:用户会选择联系某些推荐对象,也会跳过另一些人;有些匹配促成了真实对话,有些则无回应。Articuler.ai 将这些难以用语言完整说明的选择称为 Implicit Preference(隐性偏好)。
一个人未必能准确解释为何对某类连接感兴趣,但选择本身已提供方向。随着反馈积累,Articuler.ai 获取的信息逐渐从「一个人过去是谁」延伸到「他此刻愿意和什么样的人建立联系」。这些隐性偏好将持续修正后续匹配,也是公开数据无法直接提供的信号。
据申哲先介绍,内部测算显示 Articuler.ai 的匹配准确率在 95% 以上(行业平均约 70%),其边际成本则是部分 Agent 找人方案的 1/20。原因在于系统无需反复将大量 Profile 输入大模型进行长文本判断,候选人在向量空间中的相关性本身即可被计算。
效果差距有多大?实测案例显示,团队曾将一家中国具身智能公司的同一份招聘需求分别放入 Articuler.ai 和一款传统找人工具,两边推荐的前 10 名候选人无一重合。
另一款产品推荐了 ABB 中国的 VP、某具身智能公司联合创始人等人选,这些人虽职位和关键词看似相关,现实中却难被挖走。而 Articuler.ai 推荐的则是其他具身智能公司中,职位比目标岗位高一级或低一级但经历极其适配的人。团队将两份未标记来源的报告交给 5 名猎头顾问,5 人均选择了 Articuler.ai 的结果。
这一对照虽非完整技术评测,但足以说明两条路线的差异:关键词能找到「看起来符合条件的人」,但真正的匹配需回答「谁在现实中更值得联系」。

某公司调用 Articuler.ai 的 CLI 进行 RSI 领域华人专家 Mapping
03
招聘研究员、卖家居用品,核心都是找到值得联系的人
除活动外,Articuler.ai 已将这套匹配能力延伸至企业招聘和销售场景。
猎头场景是最早跑通的 ToB 业务。目前,一家国内头部猎头公司已围绕 Articuler.ai 的 CLI 工具开发内部人才搜寻系统,300 多名顾问每日使用该能力,主要场景之一是协助中国公司在全球招聘人才。
招聘一名 Researcher,重要信息往往散落在简历之外。系统需理解候选人在 arXiv 上的研究方向、GitHub 上的项目贡献及过往经历,也要读懂 JD 未直写的要求:企业究竟想解决什么问题、候选人是否处于流动期、何种经历可迁移至当前岗位。
出海找商机是另一个增长场景。令申哲先意外的是,付费更积极的客户并非高科技企业,而是华东和华南地区从事 ToB 出口的传统企业(如销售钢材、建材和家居用品的公司)。这些公司过去常在 LinkedIn 上按职位寻找海外分销商并批量发送相似信息。
Articuler.ai 希望将寻找和判断商机的过程转化为一项可被 Agent 调用的能力。
以一家希望进入海外酒店和公寓市场的家居用品公司为例,系统不会直接搜索「采购负责人」名单,而是先寻找更接近购买意图的信号:哪家酒店即将竣工、哪个公寓项目准备交付、哪些企业近期可能产生采购需求。这些信号源自行业新闻、公司动态和社交媒体。锁定相关企业后,Articuler.ai 再反向定位其中负责采购或合作的人,并向客户解释对方为何可能在此时点需要该产品。
「一个人和他所在的公司、行业之间存在耦合关系,这些信息在我们的体系里都可以被计算。」申哲先表示。系统有时需从人找到公司,有时要从公司和行业动态反向找到人。在 Articuler.ai 的高维向量数据库中,两类信息被置于同一体系处理。
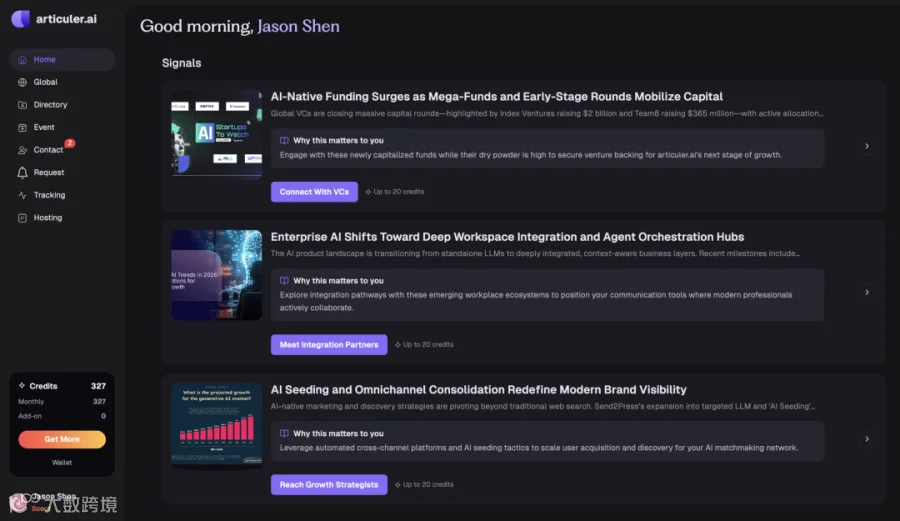
除了通用模型的推理能力,Articuler.ai 还会为不同场景补充相应的专家知识:销售场景需判断何为 High Intent 客户,招聘场景需读懂岗位描述背后的言外之意。真正影响结果的行业知识,仍由产品补齐。
匹配工具亦有边界。申哲先表示,Articuler.ai 目前能向客户保证的是邮件可触达目标对象,至于对方是否回复,仍有太多因素不在系统控制范围内。
一家智能硬件公司曾希望寻找美国零售商作为线下渠道,Articuler.ai 为其匹配了一批潜在相关负责人。但这家公司无官网,产品手册仅有文字且看不出外观。即使找对了人,对方也难建立信任。准确的匹配可以创造机会,却无法替客户补齐产品和交付能力。
在服务企业的过程中,Articuler.ai 形成一个判断:未来一部分 ToB 软件可能不再需要独立前端。
一家猎头客户已将内部工具 AI 化并集成到企业内部使用的 Agentic 平台上。顾问不会为了一个找人功能离开现有平台去学习新软件。因此,Articuler.ai 开始重视 CLI 和工具调用:客户原有的 Agent 负责对话、收集信息和组织工作流,Articuler.ai 在后台完成职业身份理解和匹配,再将结果返回客户熟悉的工作环境。
如此一来,Articuler.ai 更接近一项可被其他 Agent 调用的底层能力。它无需重复设计完整的交互和 User Flow,也不必要求客户迁移到新软件。
收费方式也沿此逻辑展开:用户无需预付年费,可按实际使用量购买点数,付费解锁联系方式和结果。申哲先并不排斥订阅,但他认为订阅应建立在用户天然存在持续需求的基础上,而非成为产品成立的前提。
AI 带来了一批规模更小的 B 端用户。过去难以负担企业软件的 Prosumer、Solo Creator 和 OPC,可借助 Agent 和按量付费,以更低的门槛获得找人、招聘和销售能力。
活动、招聘和销售看似相距甚远,但 Articuler.ai 处理的始终是同一个问题:理解一个人,读懂一项需求,再判断双方为何值得在此刻建立联系。
04
AI 社交热闹了三年,Articuler.ai 为什么坚持职业场景?
相比技术和商业化,Articuler.ai 过去一年更难解决的问题是如何向外界介绍自己。
一年前接受 Founder Park 采访时,申哲先将 Articuler.ai 概括为「Tinder 版 LinkedIn」,希望用 AI 打造新的职业社交平台。但「AI 职业社交」概念宏大,用户为何来到新平台、进去做什么、为何不继续使用 LinkedIn?这些问题很难用一句话回答。
去年融资时,这种表达困难被进一步放大。Articuler.ai 在全球接触了 157 家投资机构,一度拿到一家海外机构的 TS,最终却未能完成交割。待申哲先回国继续融资,市场热度已过。国内投资人亦难理解职业社交,有人甚至质疑:「美国人都很外向,为什么还需要这个?」
申哲先后来复盘认为,投资人听不懂只是表象。团队当时缺少一个足够具体的场景,无法让人立刻看见产品正在解决什么问题,也没有数据证明此事能够成立。
活动给 Articuler.ai 提供了一个更易被理解的入口。团队无需先解释职业社交的重要性,也无需展开 AI 如何重构关系网络。用户走进会场,收到一封邮件,知道今天最应该见谁、为何值得见,这已构成一幅足够具体的产品画面。
原本抽象的「AI 匹配」变成了可直接感知的结果:原本可能错过的两个人因 Articuler.ai 见了面。主办方能看到产品带来的报名和到场,参会者也能判断推荐是否有用。团队过去难以说清的价值,终于在一个完整场景里显现出来。
活动是 Articuler.ai 找到的「最小原子化社交网络」。它不需要先聚集几百万用户再等待关系慢慢形成。观众报名的瞬间就自然成为网络中的用户,每一次匹配、选择和真实联系又继续增加其中的关系与数据。
这也让团队更加确定,Articuler.ai 应坚持职业社交方向,而非从泛社交开始。
过去两三年,市场上已出现大量 AI 社交产品:有的用 AI 生成帖子,有的提供 AI 角色陪伴,也有产品尝试让 Agent 代表用户与另一个 Agent 交流。其中不少产品只在发布初期获得关注,一个月后便鲜有用户使用。申哲先的质疑很直接:「我想发一条帖子,为什么要去一个新平台?」
抖音、小红书、LinkedIn 已拥有流量、用户和成熟的关系网络。新的社交产品若只是增加一些 AI 功能,很难提供足够强的迁移动机。用户也许会因新鲜感体验一次,却没有长期留下的理由。
几千、几万甚至几十万用户进入同一个平台,不意味着社交网络已经形成。决定网络价值的还有关系密度。若彼此关系太弱,用户就没有互动必要,真正想找的人也未必存在于其中。
职业场景更容易建立这样的密度。找客户、找投资人、招聘或求职都对应一个正在发生的需求。双方需要什么、能够提供什么可以被相对清楚地表达,也更容易成为 AI 匹配的依据。
约会、相亲等泛社交场景则更加主观。很多偏好连人自己都难以说明,AI 也就缺少足够的信号作出判断。申哲先和团队曾尝试过 Agent 社交,最后发现一个人是谁、想做什么以及此刻有什么需求经常没有被完整记录。Agent 即使足够聪明,面对缺失的信息也无从理解。
基于这些判断,Articuler.ai 将社交网络的生长拆成三步:一是先做工具,解决一个具体问题,让用户有理由来到这里;第二步进入需求明确、关系密集的社区,让相关的人持续产生连接;最后才形成更大的网络。
申哲先认为,社交产品可拆分为内容和分发网络两层。过去两年,大多数 AI 社交产品都落在第一层。但真正决定平台能否长出来的,是第二层的分发。
Articuler.ai 关注的正是分发层。「人就是内容,匹配就是分发。」每一个人的背景、能力、经验和需求都可以成为另一个人需要的信息。这些信息被真正相关的人理解后,就可能形成一次有价值的连接。匹配就是根据每个人当下的目标,让这些信息被真正需要它们的人看见。
Articuler.ai 的终极愿景是在个人能力与真实需求之间建立一套分发网络。每个人的时间、技能、经验、知识和服务都能在平台上直接找到需要它们的人。当用户提出一项意图,系统能够帮助他找到与这个目标相关的人。
AI 正在让每个人具备完成更多工作的能力。Articuler.ai 想继续解决的问题是:当这些能力需要通过另一个人才能转化为结果,怎样让供需双方更早找到彼此。
在对的时间,把对的人推到你面前。剩下的事情,交给人来完成。

带着 idea 来,让一屋子人帮你「想清楚」
Meshy 胡渊鸣:GPT-6 Astra 能做 3D 之后,3D 生成产品的价值在哪里?
对话 xLean 薛轲翰:扫地机产品远没有到头,清洁机器人可以是 Family Agent 的起点