


智驾系统可通过 OTA 持续迭代,但车载芯片在出厂那一刻便已定格。这是智能汽车行业面临的共性难题:车辆生命周期长,而技术迭代快。新芯片虽能支撑更复杂的算法,但对于存量车而言,硬件规格已成定数。
若新能力仅绑定新硬件,新老车型的体验鸿沟将日益扩大,导致旧车面临“技术贬值”。
对抗“技术贬值”,意味着车企需在销售完成后继续为老用户投入研发。能否将新能力下沉至老车型,不仅关乎“持续升级”承诺的含金量,更直接影响用户对品牌的信任基石。
9 月 10 日,理想汽车开启 OTA 8.6 及 OTA 9.1.1 版本推送。其中,OTA 8.6 成功将理想马赫 VLA 2.0 大模型部署至搭载 Orin-X 及 Thor-U 平台的已交付 AD Max 车型,覆盖 2022 至 2025 款多款车型,惠及近百万用户。
此举兑现了理想在 6 月 Livis Day 上作出的三季度升级承诺。据李想透露,团队历经数月的模型蒸馏、平台适配与多轮验证,才攻克了这一工程难关。
旧芯片的硬件约束与适配挑战
将理想马赫 VLA 2.0 的能力带回老车型,其复杂度远超单纯的芯片参数差异。此次 OTA 8.6 面向 2022 至 2025 款搭载 AD Max 的车型,而 OTA 9.1.1 则面向 2026 年发布的新车型。
模型运行涉及矩阵乘法、归一化等大量“算子”运算。计算主体、执行顺序及中间结果存储方式均直接影响速度。这意味着,相同的数学任务在不同硬件平台上,底层执行方案需重新设计。
本次获得更新的已交付 AD Max 车型,分别搭载英伟达 Orin-X 和 Thor-U 芯片。两者 GPU 架构分别为 Ampere 和 Blackwell,即便同源,计算条件也存在显著差异。
差异首先体现在低精度计算支持上。Thor-U 支持 FP4、FP8,而 Orin-X 的高效部署主要依赖 INT8。数值表示格式的不同,直接影响权重存储、中间特征处理及计算单元的数据吞吐。
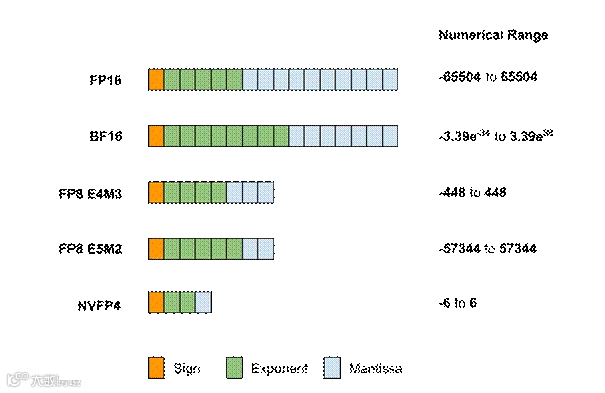
(英伟达官方浮点格式位结构图,图源:NVIDIA Developer)
以 FP8 和 INT8 为例,虽同占 8 位,但 INT8 为均匀量化,FP8 为浮点格式,其数值间距随量级变化。因此,围绕 FP8 设计的量化方案迁移至 INT8 时,需重新处理数值范围与误差分配。
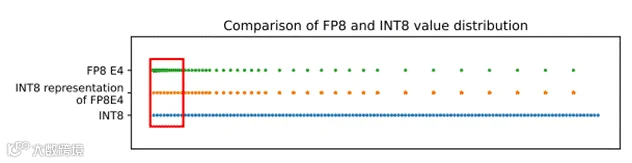
(FP8 与 INT8 数值分布对比图,图源:Qualcomm AI Research)
这要求团队利用代表性数据进行量化校准,评估各层精度需求,在节省算力存储与保障模型输出之间寻找平衡。此外,还需考量算子在硬件上的落地情况,包括低精度指令支持、推理框架匹配度及数据布局优化等。
除数值格式外,计算内核的选择、数据布局及任务分块方式均需针对新平台重新评估。
理想自研的马赫 M100 芯片采用完全不同的计算与数据流组织方式。其 NPU 基于数据流架构,减少多级缓存依赖,通过本地存储和片上 SRAM 承接数据,并由编译器显式安排流水执行,以最大化硬件利用率。

(马赫 M100 NPU 的存储系统与数据搬运结构,图源:理想官方论文)
相比之下,英伟达 GPU 典型执行基于 CUDA 线程模型。在 M100 上高效的执行策略,迁移至 Orin-X 或 Thor-U 时,必须重构以适应目标平台的资源与编程约束。
这些调整环环相扣。任何为满足时延功耗而进行的模型结构调整,都会引发计算量、特征规模及数值分布的连锁变化,需对量化与内存方案进行复查与再验证。
模型压缩下的能力留存策略
解决硬件适配只是第一步,如何在参数缩减的同时保留核心能力更为关键。理想采取“教师 - 学生”模型策略:云端训练大参数教师模型,再针对车端芯片约束设计学生模型。
针对 Orin-X 和 Thor-U,理想从输入与网络结构两端控制计算负担:通过 Token 压缩减少冗余信息,结合神经网络架构搜索(NAS)调整层数与通道,在能力与资源间寻找最优解。
小模型获得入场券后,需通过蒸馏技术回答“原有能力保留多少”的问题。
在经典输出蒸馏中,教师模型的概率分布作为“软目标”指导学生模型学习。但在驾驶任务中,仅保留最终动作远远不够。理想汽车基座模型负责人詹锟指出,模型需保留表征能力、决策逻辑及输出特征,包括对道路结构、交通参与者动态及安全边界的综合判断。
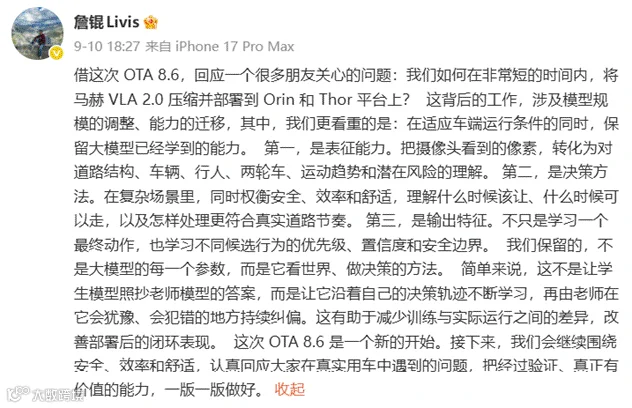
(图源:詹锟微博)
压缩后的模型需学会在不同路况下维持合理的判断逻辑。场景变化时的自适应调整能力,是衡量模型是否真正掌握驾驶技能的关键。
连续驾驶场景引入了“协变量偏移”难题,进一步增加了蒸馏难度。

(错误动作通过反馈造成后续决策偏离,图源:学术论文《Feedback in Imitation Learning》)
在模仿学习中,若仅依赖教师轨迹训练,学生模型部署后一旦产生微小偏差,可能导致后续观察条件偏离训练分布,误差随之累积。单帧预测准确无法保证连续驾驶的稳定性。
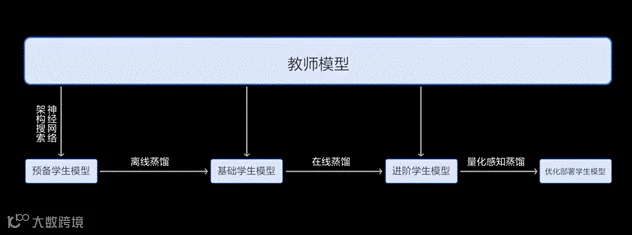
(理想 OPD 模型蒸馏流程,图源:理想官方抖音)
理想采用的 OPD(On-Policy Distillation,在线策略蒸馏)将学生自身的决策轨迹纳入训练循环。学生依据当前策略生成轨迹,教师在相应上下文中提供监督,使指导能够动态跟随学生策略的变化。
OPD 补全了模型压缩中最易遗漏的一环:不仅教会学生“怎么做”,更让其知道在走偏后“如何修正”。
从实验室验证到日常道路实战
模型适配完成后,仍需经过严苛的实测验证。理想依托自研模型、Harness 体系、星环 OS、编译器团队及自研芯片五大能力,构建了完整的闭环验证流程。
从算法评测、仿真测试到多城市泛化实车测试,真实传感器输入、端到端时延及车辆执行响应均被纳入考核。不同城市的道路结构与驾驶习惯,是对模型泛化能力的终极考场。
复杂的后台工程,最终转化为车主可感知的体验升级。
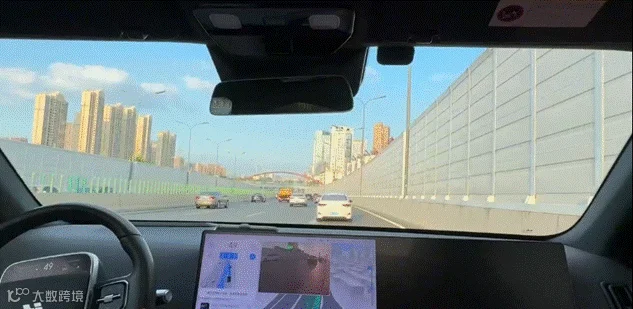
(左后方加塞博弈更加丝滑,图源:网络)
理想马赫 VLA 2.0 重点优化了绕行、变道、跟车及道路博弈能力。面对施工占道、临停车辆,系统能更早识别可通行空间;变道时综合考量侧后方车辆动态;跟车响应更及时,汇流穿插时减少不必要的加减速。
这些高频场景的改善,让用户无需理解 Token、蒸馏或 OPD 等技术术语,即可直观感受升级价值。实验室证明模型可迁移,日常道路则验证能力真落地。
此次 OTA 不仅限于智驾。OTA 8.6 还延伸至停车、补能与座舱领域:支持通过理想同学 App 及 AI 眼镜 Livis 指挥泊车,优化电池预冷与预约充电体验,并新增艺术相框功能。同期 OTA 9.1.1 更是将主动悬架接入游戏互动,盘活闲置底盘硬件。
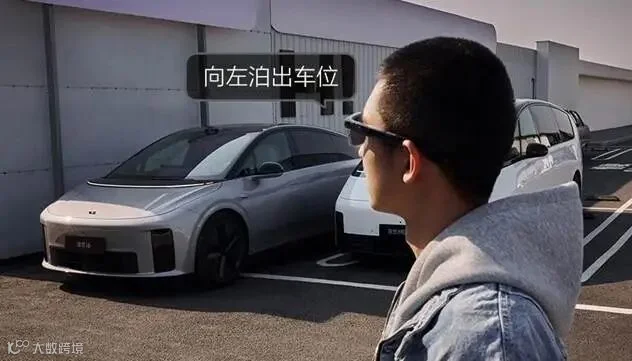
(理想 AI 眼镜 Livis 指挥泊车,图源:理想)
这些细节印证了一个核心理念:汽车交付后,既有的芯片、传感器与执行机构仍可被新软件重新定义与调用。
“持续进化”因此具备双重含义:将新技术装进新车是产品迭代,而耗时数月将新技术注入老车,则是对老用户的责任坚守。前者决定未来销量,后者决定品牌温度。
把未来卖给新用户不难,难的是在技术前行时,依然愿意回头带上老用户同行。