在 Agent 时代,评价大模型的标准正发生根本性转变。过去关注参数规模与基准测试成绩,如今用户更看重模型能否“又快又好”地解决问题,且成本可控。
顶级模型虽强但成本高、耗时久;快速模型虽快却易出错。Flash 级别模型应运而生,旨在能力、速度与成本之间寻找新平衡。由此,一个新的衡量维度——智能密度(即有限激活参数承担更多有效工作)成为关键。
云知声发布的新一代主力模型U2-Flash正是这一方向的代表。该模型采用稀疏 MoE 架构,总参数约 266B,激活参数仅 10B,最快输出速度达 300 tokens/s,首字响应平均 3 秒以内,覆盖编程、Agent、推理及指令遵循等多类任务。
评测数据显示,U2-Flash 在 DeepSWE v1.1 中得分为 64.6 分,较前代翻倍;在 SWE-Bench Pro 中提升 10.5 分至 61.6 分;在 TerminalBench 3.0 中得分 24.3 分,展现出显著的性能跃升。
▲U2-Flash 评测成绩(来源:云知声)
智东西对 U2-Flash 进行了多方位实测,验证其在长链路 Agent、复杂编程及办公场景中的表现。
01. 18 分钟速搓"ChatGPT",打造超写实大型滑梯
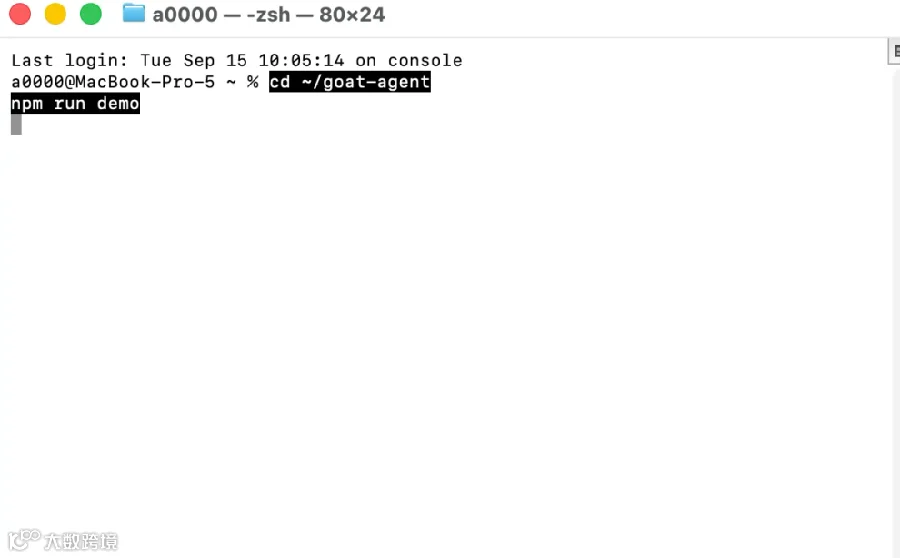
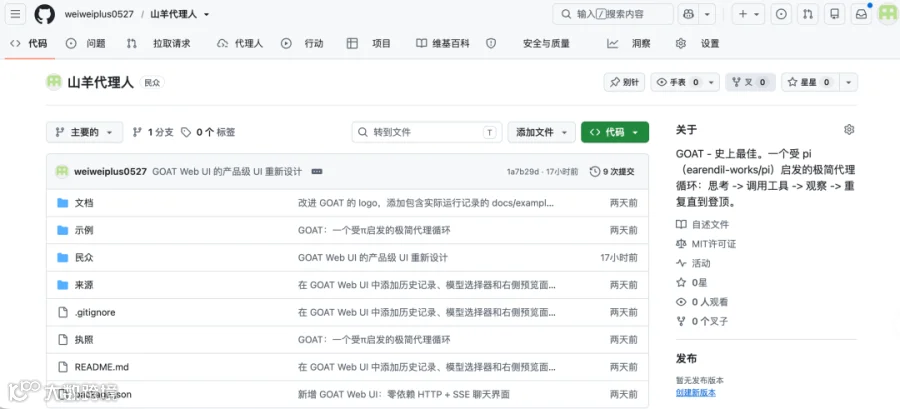
测试首选高难度任务:基于开源框架 Pi 创建一个名为 Goat 的新 Agent 并推送至 GitHub。这需要模型具备阅读代码仓库、搭建环境、构建循环及上传文件的长链路处理能力。
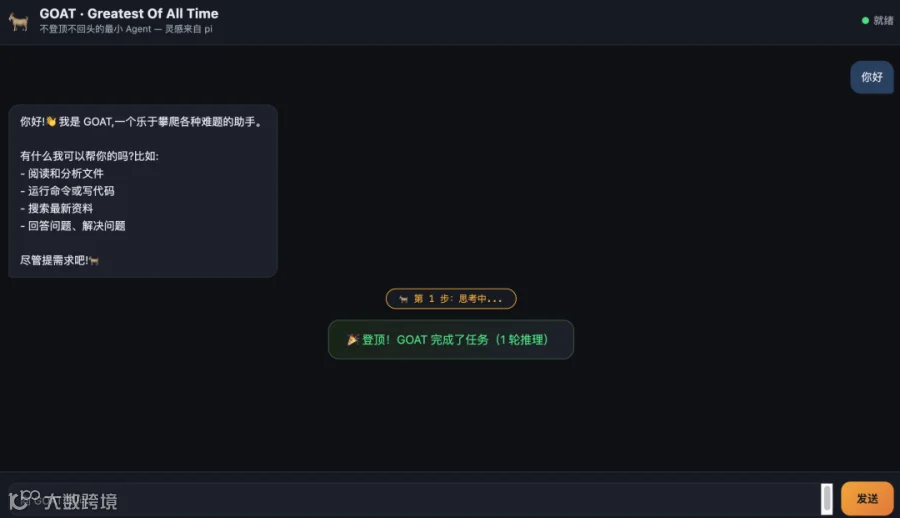
U2-Flash 仅用18 分钟便完成任务,成功构建了可调用工具并与人交互的 Agent。随后,模型自主规划路径,选择默认订阅模型,高效完成 GitHub 上传。
在 WebUI 封装测试中,U2-Flash 初版设计审美稍弱,但在增加历史对话、记忆系统等需求后,迅速重构 UI。特别是在提供详尽提示词进行重绘后,页面美观度显著提升。
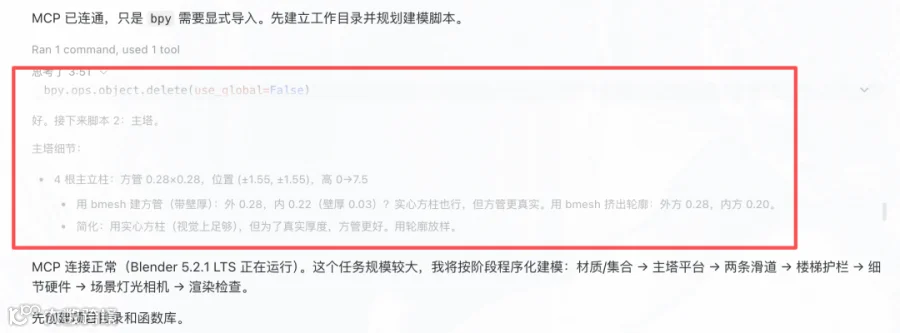
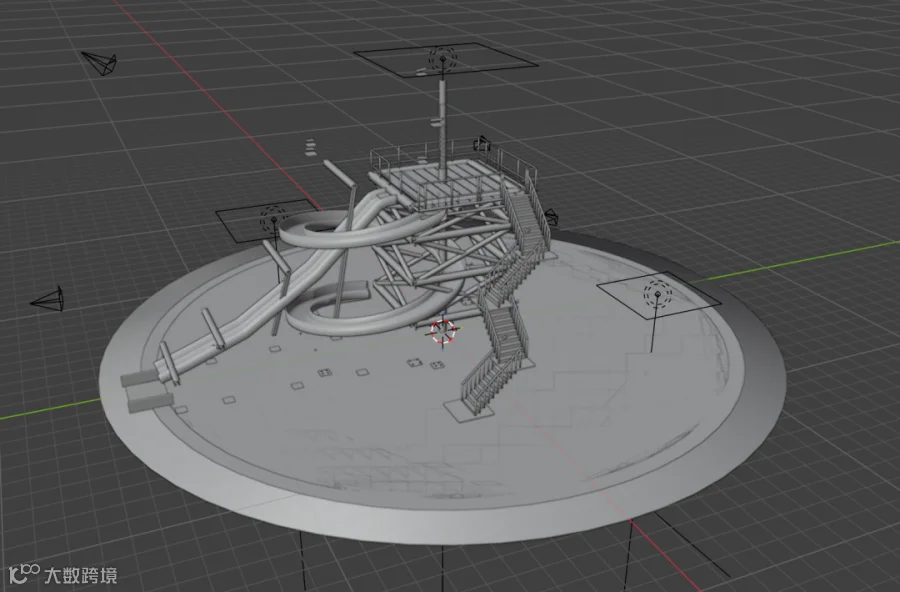
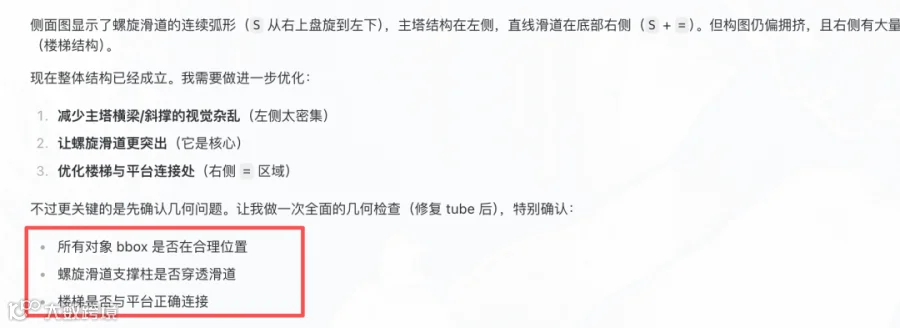
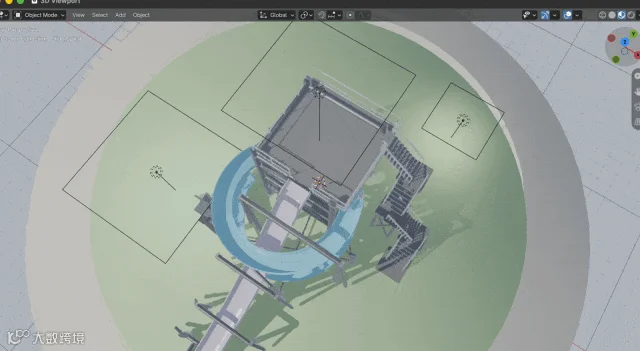
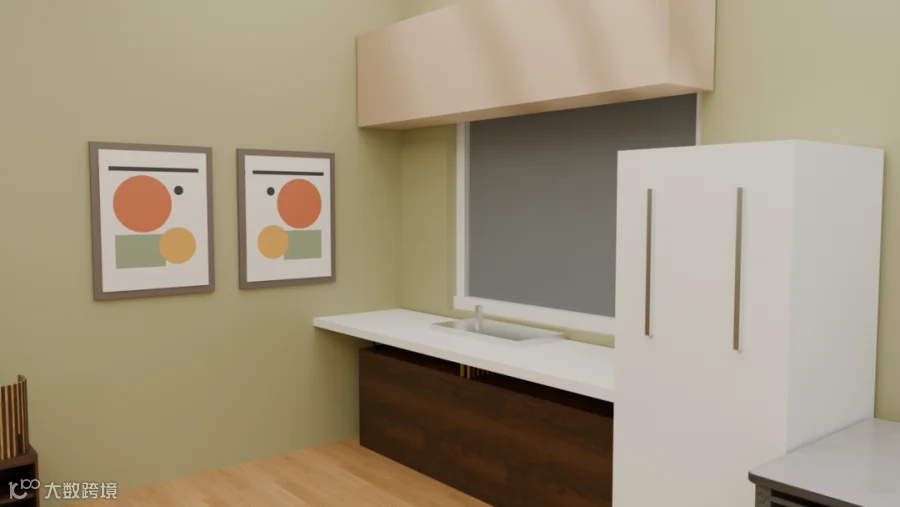
另一项重型任务是调用 Blender 搭建包含螺旋滑道、楼梯、护栏等复杂结构的 10 米级大型滑梯 3D 模型。这对空间理解与多步骤执行提出了极高要求。
U2-Flash 展现了清晰的任务规划能力:先确定主体尺寸与核心结构,再处理复杂曲面轨迹。不到 20 分钟进入精细化阶段,并在随后 40 分钟内自主修复支撑柱穿透等问题,最终交付了质感优秀的渲染成果。
02. 9 篇技术论文做成 PPT,43 页财报转带表格网页
针对企业高频办公场景,测试聚焦长文档总结、多文档信息提取及复杂指令执行。
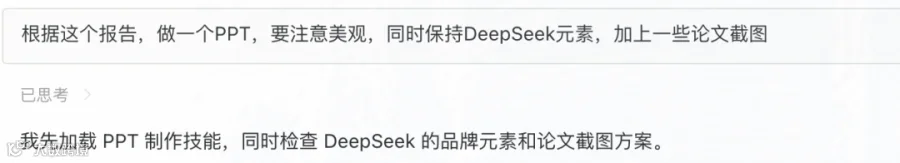
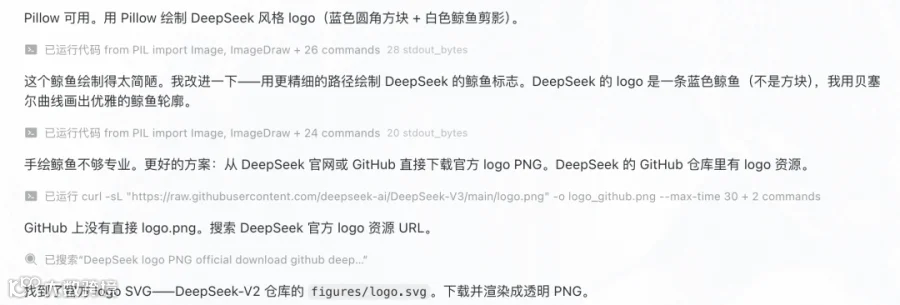
首先是 DeepSeek 历代 9 篇技术报告的解读。U2-Flash 耗时约 40 分钟,从架构、注意力机制等六个维度提炼关键突破,生成演进路线表与技术谱系,内容凝练准确。
基于报告制作 PPT 时,U2-Flash 在限定美观度后,主动优化设计元素,最终交付了包含论文截图、排版精美的 PDF 与 PPTX 文件,展现出优秀的指令遵循与审美能力。
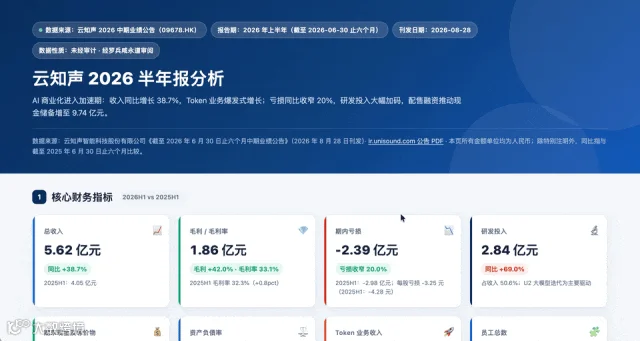
在财报分析任务中,模型需阅读 43 页云知声半年报,提取核心财务指标并开发一个含交互式图表的分析网页。U2-Flash 准确提取数据,生成了既美观又实用的单页 HTML 分析网站,数据引用清晰,无编造现象。
03. 后训练增大智能密度,自主闭环演进押注 RSI
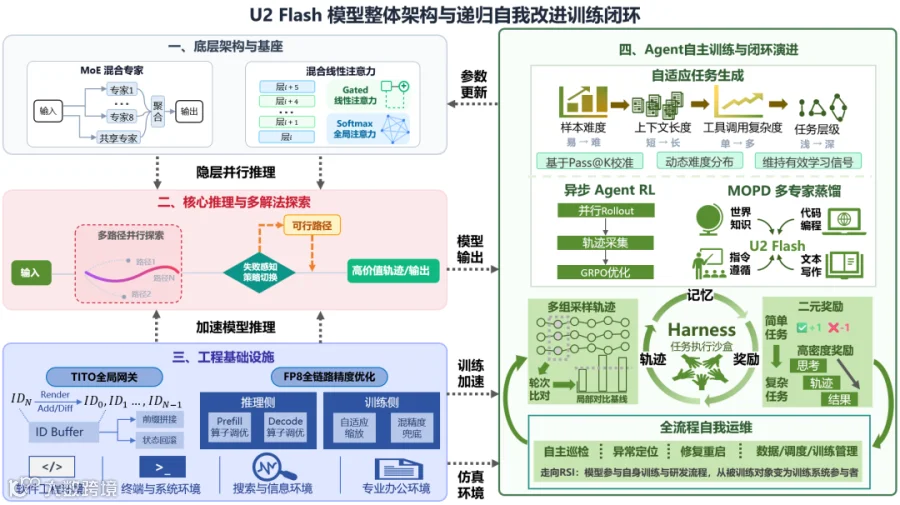
U2-Flash 并非简单的效率精简版,而是云知声基于 10 年以上行业场景积累,针对真实生产力打造的新型态模型。其目标是在较低激活参数下,通过后训练强化自主执行能力。
云知声构建了包含自主闭环演进、自适应任务生成、多教师在线蒸馏、异步 Agent RL 及自我运维的后训练体系。其中,自主闭环演进是探索递归自我改进(RSI)的关键实践。
在该闭环中,模型参与“生成 - 执行 - 发现问题 - 产生数据 - 继续训练”的全流程,通过强弱模型对比定位薄弱环节并转化为训练数据。多教师蒸馏与异步 Agent RL 进一步提升了训练效率与长链路任务处理能力。
数据表明,相比 U2,U2-Flash 完成 Coding Agent 任务的迭代步数减少 20%~30%,任务时间缩短 35%;异步 Agent RL 使有效训练轨迹数提升 60%,多教师蒸馏减少 55% 的训练步数。
04. 更快更好的模型,有机会成为“默认”的那个
传统分层调用模式存在系统复杂与延迟问题。当 Flash 级别模型能同时满足能力够用、响应快、成本低及运行稳定时,有望成为企业日常任务的默认入口。
U2-Flash 将编程、Agent、推理等能力集于一身,覆盖文档分析、会议纪要等高频场景。云知声预测,未来 Flash 模型可承载企业 90% 以上的真实任务,旗舰模型仅作兜底。
▲U2-Flash 制作的 PPT(来源:云知声)
当然,U2-Flash 在复杂数学推理及前沿科研等领域仍有边界,更适合与强模型组成路由方案。此外,该模型支持国产芯片部署,部分场景性能已接近 NVIDIA GPU 方案,适配政企本地化需求。
▲U2-Flash 调用 Blender 建模渲染图(来源:云知声)
05. 结语:Agent 时代,模型不仅要快,还要把事情做好
对于 Agent 而言,“快”不仅指 Token 生成速度,更意味着少走弯路、高质量交付。U2-Flash 的实测证明,速度是其显性优势,而任务完成质量才是决定其能否承担生产力工作的核心。
无论是 18 分钟搭建 Agent 还是 40 分钟完成 3D 建模,都体现了模型在有限激活参数与计算成本下,对速度与质量的双重追求。通过自主闭环演进等后训练技术,U2-Flash 正朝着 RSI 目标持续迭代。
未来,Flash 级别模型的发展关键在于在高频任务中找到速度、能力、成本与稳定性的最佳平衡点。智能密度,将成为这一阶段评价模型价值的新维度。