


控制流的高级抽象与底层实现存在显著差异。即使源代码逻辑相同(如均使用 if 语句),编译器针对不同场景也可能生成截然不同的底层实现。
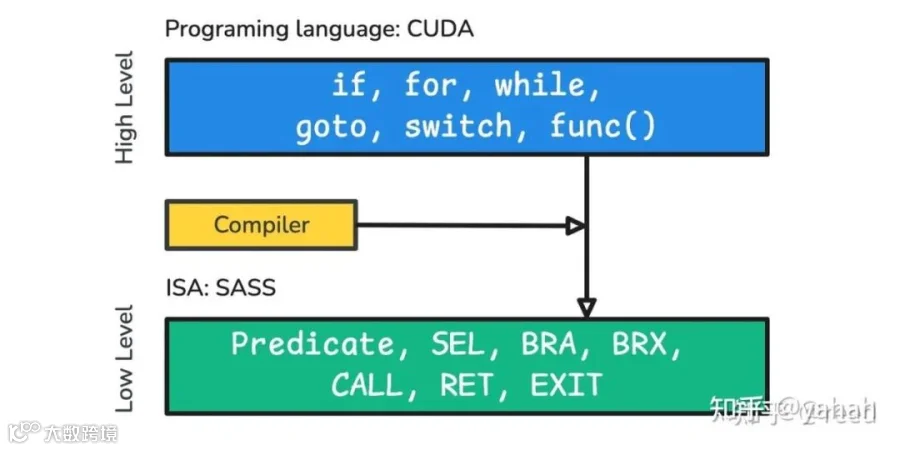
旧版本 NV 控制流机制
Volta 架构之前的设计遵循串行执行策略:当 Warp 内的线程遇到分支且路径不同时,硬件会串行执行各分支,直至在支配点(IPDom)重新汇合。
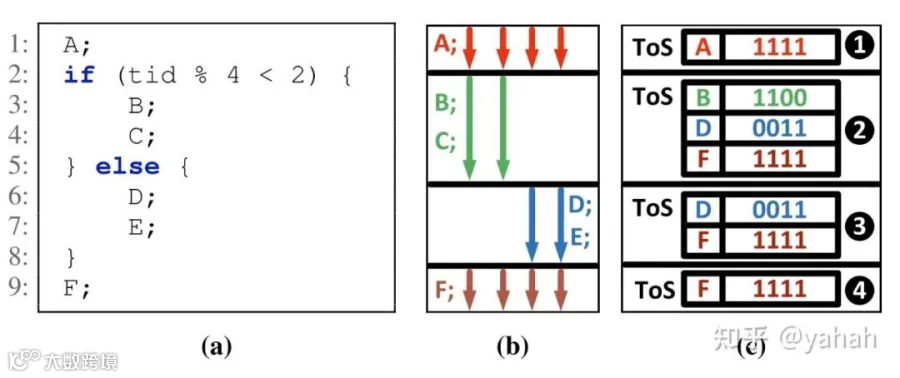
该机制依赖 SIMT-Stack 硬件设计,栈顶保存下一个执行 PC 和 Active Mask。执行流程如下:初始化后遇到分支,按“汇合点 -> 未选取路径 -> 选取路径”的顺序压栈。本质上,这是一种状态机回溯设计。
然而,该设计存在潜在死锁风险,尤其是涉及软硬件协同及路径选择策略时。
SIMT-Stack 死锁问题
Pre-Volta 的 SIMT-Stack 隐含三个硬性约束:
- 分支路径必须串行执行;
- 每个路径内部严格 Lockstep 执行;
- 必须在 IPDom 处强制重汇合(Reconvergence)。
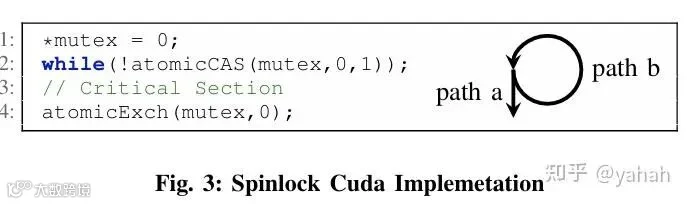
以自旋锁(Spinlock)为例,若线程分为两条路径:Path A 获取锁并跳出循环,Path B 未获取锁继续等待。根据 SIMT 规则,所有线程必须在 IPDom 处重新汇合才能继续执行。
// 循环开始
while (!atomicCAS(mutex, 0, 1)); // 尝试拿锁
// ---- 此时发生了分歧 ----
// Path B (失败): 继续留在 while 循环里
// Path A (成功): 跳出循环

// <--- 这里是 IPDom (重聚点) !!!
// SIMT 规则:所有跳出循环的线程必须在这里等还没跳出的线程,大家要重新 Lockstep。

atomicExch(mutex, 0); // 释放锁
若硬件先调度 Path B,其因等待锁而停滞,但锁只能由 Path A 释放;若先调度 Path A,其在 IPDom 等待 Path B 汇合,却未释放锁导致 Path B 永远无法到达汇合点。两种情况均导致死锁。
NV 在 Post-Volta 架构中移除了上述约束以解决此问题,具体设计虽未完全公开,但可通过逆向推导推测。
新版控制流设计
在新设计中,Thread 可在 Warp 内拥有不同的 PC。调度单位仍为 Warp,但执行语义下沉至 Thread 级别,PC 相同的线程可组合执行。
原有三大约束相应调整:
- 允许不同路径交错执行,不再强制串行完成;
- 取消强制所有线程在 IPDom 集合的限制;
- 引入显式同步指令(如 WARPSYNC、BSYNC)由软件手动控制同步点。
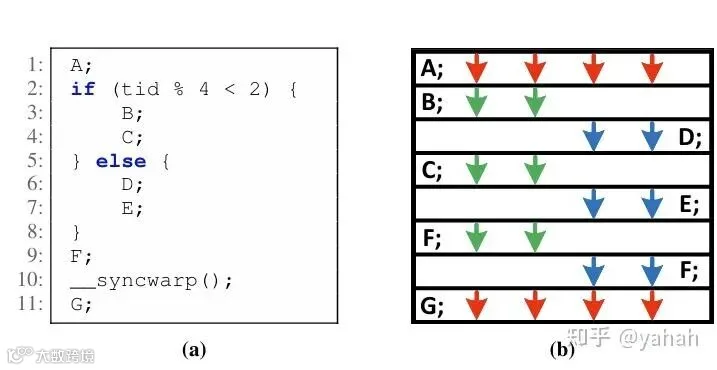
在此模型下,路径可交错执行,汇合点不再局限于 IPDom,而是通过__syncwarp 等指令在指定位置同步。
NV Turing 控制流指令解析
基于逆向工程推导的 Turing 控制流指令模型与真实硬件表现高度吻合:控制流指令序列差异仅 1.03%,IPC 预测差异仅 0.19%。
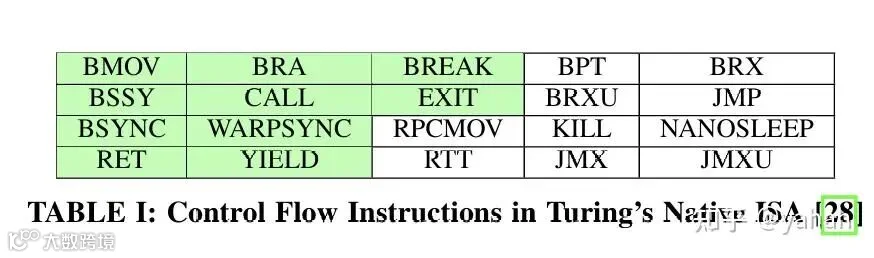
核心指令功能如下:
- BSSY:分支前插入,将当前 Active Mask 存入专用 Bx 寄存器,标记未来汇合点。
- BSYNC:置于分支结束后的汇合位置,仅当 Bx 掩码内所有线程到达时,Warp 才解除停顿。
- BREAK:将当前 Thread ID 从 Bx 掩码中移除,使其在后续 BSYNC 处无需等待。
- BMOV:在 Bx 寄存器与通用寄存器 Rx 间搬运掩码,解决 Bx 资源不足时的溢出问题。
- YIELD:强制当前路径让出执行权,切换至另一路径,常用于解决死锁。
- WARPSYNC:类似 BSYNC,但掩码由程序员或编译器直接提供。
- BRA:条件或无条件跳转指令。
- EXIT:线程执行完毕,从相关 Bx 寄存器中移除。
- CALL/RET:子程序调用与返回,管理返回地址寄存器。
编译器会自动插入 BSSY/BSYNC/BREAK/BMOV 辅助重汇合,这对 CUDA/PTX 程序员透明。以下通过实例分析其应用:
嵌套分支与寄存器溢出处理
多层嵌套分支需多个重汇合掩码。针对硬件 Bx 寄存器有限的情况,NV 采用“少量 Bx + Spill"策略,利用 BMOV 在 Bx 与 Rx 间交换掩码。
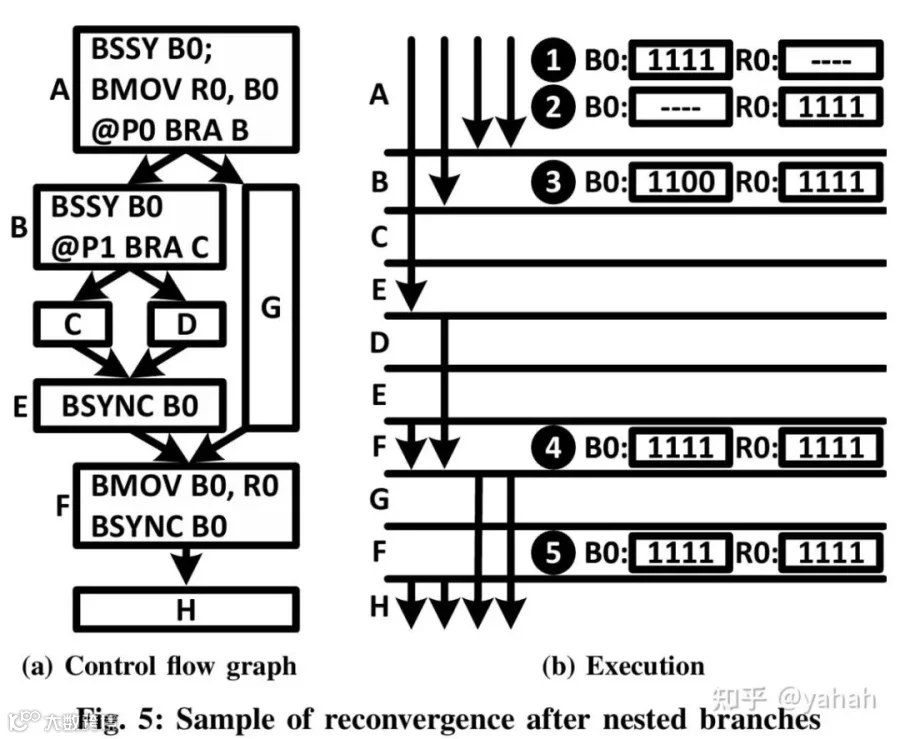
示例中,BSSY 初始化 B0,随后用 BMOV 备份至 R0。分支执行完毕后,恢复 R0 至 B0 再进行最终同步,确保汇合逻辑正确。
非 IPDom 汇合点与 BREAK 指令
Post-Volta/Turing 允许将汇合点提前至非 IPDom 位置以优化性能或避免死锁。若某些线程永远不会经过该提前汇合点,直接使用 BSYNC 会导致死锁。此时需使用 BREAK 将这些线程从等待掩码中移除。
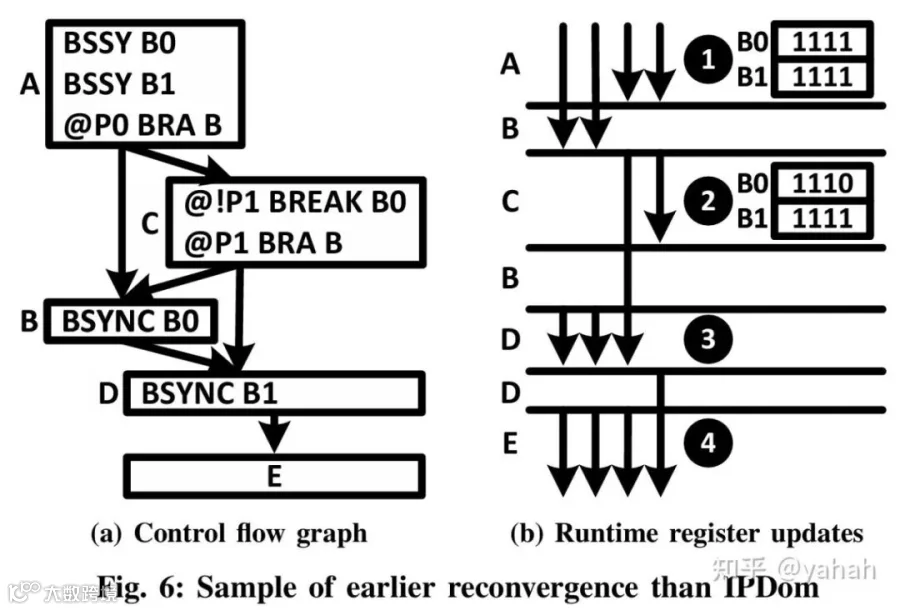
死锁规避策略
在自旋锁示例中,关键在于 BSYNC 的位置及 YIELD 的使用。BSYNC 必须置于释放锁之后,否则所有路径均在锁释放前等待,导致死锁。此外,YIELD 指令强制未获取锁的路径让出执行权,使获取锁的线程能优先执行临界区并释放锁,从而打破僵局。
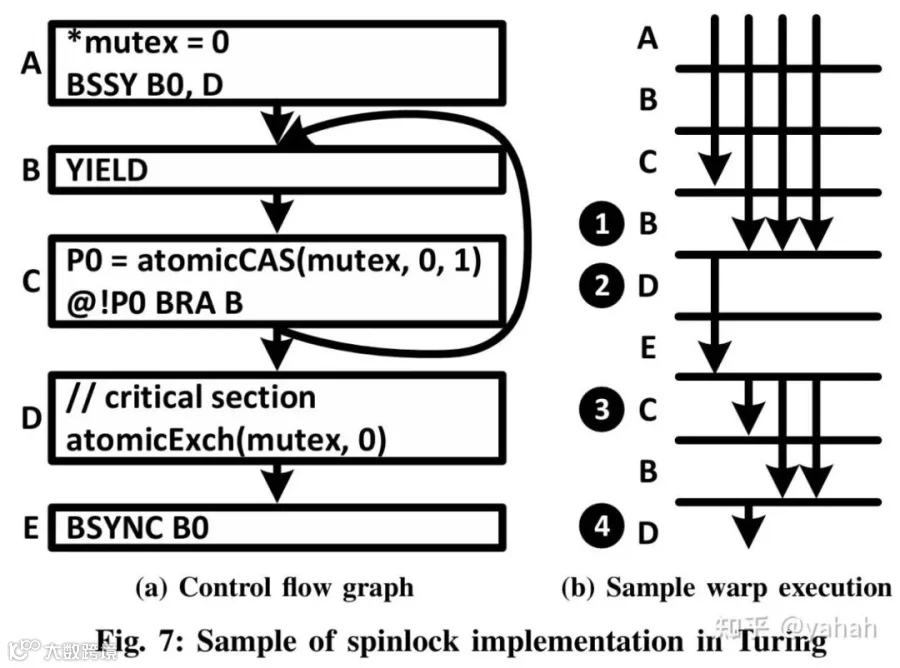
综上,解决 SIMT 死锁的核心策略为:改变重汇合位置、允许路径交错执行。
Hanoi 微架构设计
论文提出的 Hanoi 微架构旨在以低成本实现 Turing 的控制流语义。其核心组件包括:
- Warp Split Stack:存储各路径的 PC 和 Mask;
- Reconvergence Stack:存储汇合点 PC 及对应的 Bx 寄存器 ID;
- Bx Registers:存储重汇合掩码(REC Mask)及有效性标识;
- Waiting Mask:标记已到达汇合点并等待的线程;
- Finished Mask:记录已执行 EXIT 的线程,需从所有 REC Mask 中移除。

该架构通过模拟器验证,能有效复现真实硬件的控制流轨迹。
Predicate 机制
Predicate 可简化简单条件分支,将复杂度转移至编译器。除作为执行掩码外,Predicate 还可用于保存加法进位等状态。
AMD 控制流设计对比
AMD CDNA4 ISA 采用"Exec Mask + 显式保存恢复”机制。核心寄存器 Execute Mask 指示 Wavefront 中活跃的 Lane。分支时使用 FORK/JOIN 指令,硬件优先执行活跃线程较少的分支以减少等待时间。
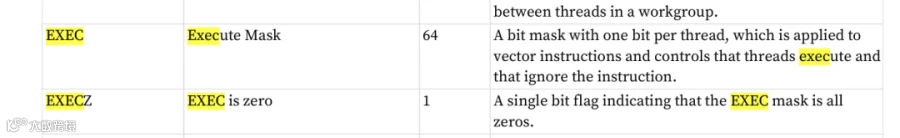
与 NV 不同,AMD 不维护隐式的 SIMT Stack,也不自动管理汇合点。Exec Mask 的保存、修改与恢复完全依赖编译器显式指令。若遗漏恢复指令,程序逻辑将出错。
对比而言,NV 方案自由度更高,降低了编译器复杂度,但引入了额外指令开销;AMD 方案无需每条指令带 Predicate,解码更简洁,适用于推理等控制流简单的场景。
参考文献
- CDNA4 ISA Documentation
- Control Flow Management in Modern GPUs
- SIMD re-convergence at thread frontiers
鸣谢:感谢作者的授权转载,欢迎大家投稿,一起分享交流游戏开发技术。
作者:yahah