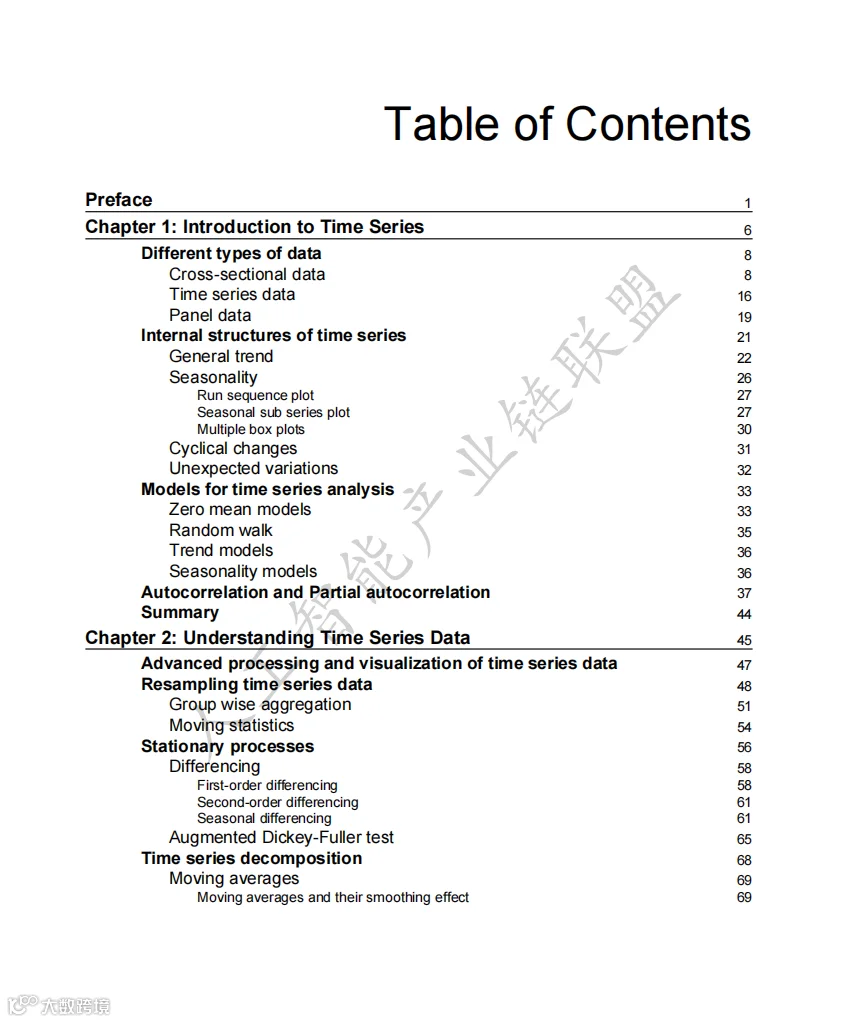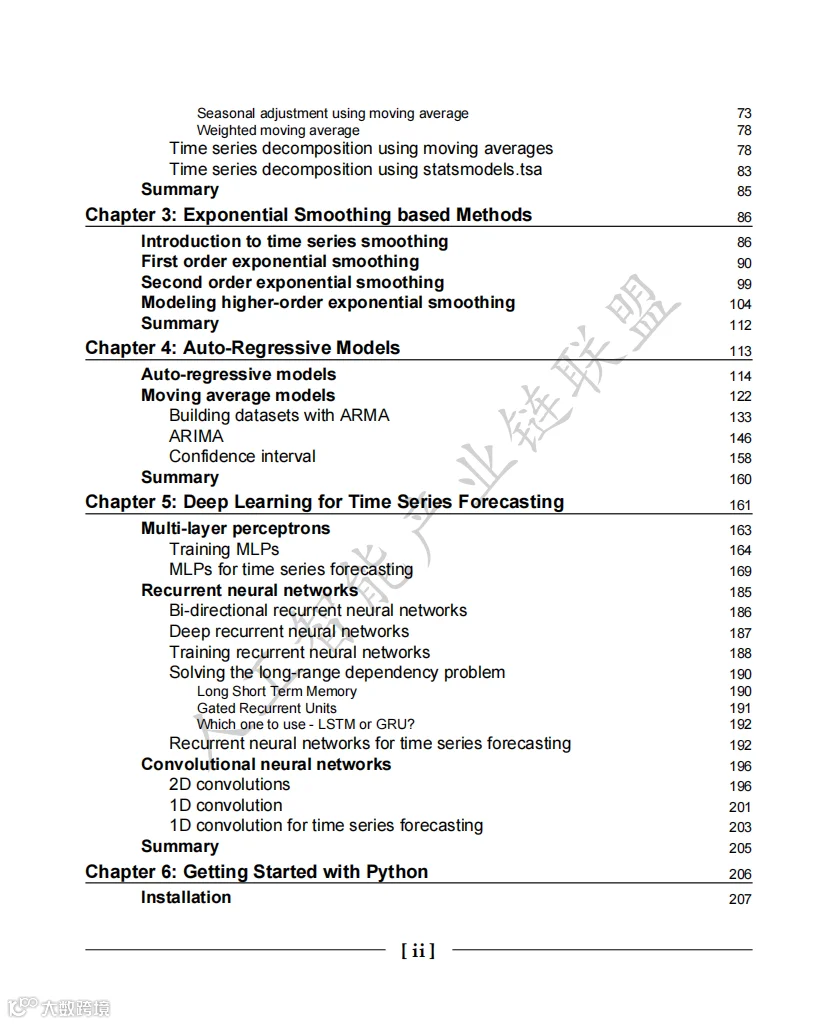

时间序列分析是数据科学中极具挑战性与价值的领域。本文深度解读《Practical Time Series Analysis》,系统梳理从传统统计方法到深度学习的前沿知识图谱,助您掌握从数据洞察到未来预测的核心技能。
一、时间序列分析的核心价值
在商业决策中,预测未来销售额、库存需求或市场趋势是数据科学家的核心任务。时间序列数据的本质特征在于观测值按时间顺序排列,且相邻观测之间存在相关性。与普通数据分析不同,时间序列分析必须严格关注数据的时间结构,这是构建有效预测模型的基础。
二、三类数据类型的辨析
准确区分数据类型是选择分析方法的前提:
- 截面数据(Cross-sectional Data):同一时间点多个个体的数据(如 2024 年各省份 GDP),时间非关键变量。
- 时间序列数据(Time Series Data):一个个体在多个时间点的观测值(如某公司月度销售额),顺序至关重要。
- 面板数据(Panel Data):多个个体在多个时间点的观测值(如各省份十年 GDP),兼具截面与时间序列特征。
专业提示:混淆数据类型是初学者常见错误,直接决定后续模型的适用性。
三、时间序列的四大构成要素
任何时间序列均可分解为四个核心部分:
- 长期趋势(Trend):序列在长时间内的上升或下降方向。
- 季节性(Seasonality):固定周期内的规律性波动。
- 周期性(Cyclical):非固定周期的涨落(如经济周期)。
- 不规则变动(Irregular):无法被上述三部分解释的随机噪声。
经典分解公式:时间序列 = 趋势 + 季节 + 周期 + 噪声。理解这些成分是模型选择的关键,例如强季节性数据不宜直接使用线性回归。
四、自相关与偏自相关:识别序列“指纹”
自相关(ACF)和偏自相关(PACF)是诊断时间序列内在结构的核心工具:
- ACF:衡量序列与其滞后值的相关性,揭示“记忆长度”。
- PACF:排除中间滞后项影响后的净相关性,用于确定 AR 模型阶数。
专业提示:ACF 与 PACF 如同序列的“心电图”,可判断平稳性、模型类型(AR/MA)及阶数。
五、数据预处理关键步骤
高质量的数据预处理往往比复杂模型更有效:
- 重采样:改变时间频率(如小时转日),减少噪音。
- 分组聚合:按时间维度计算统计量(如月均值)。
- 滚动统计:利用滑动窗口平滑数据,突出趋势。
- 平稳性处理:确保均值、方差不随时间变化,满足模型假设。
- 差分处理:一阶差分消除趋势,季节差分消除季节性。
- 序列分解:采用加法(Y=T+S+E)或乘法(Y=T×S×E)模型分离成分。
六、指数平滑法的演进
基于“近重远轻”思想,指数平滑法适用于不同场景:
- 一阶平滑:适用于无趋势、无季节性数据,核心参数为平滑系数α。
- 二阶平滑(Holt 模型):增加趋势项,引入参数β控制趋势平滑度。
- 三阶平滑(Holt-Winters 模型):同时处理水平、趋势和季节性,是最完整的版本。
七、从 AR 到 ARIMA 的模型谱系
经典统计模型家族及其适用场景:
- MA(q):利用过去误差项预测,捕捉“冲击效应”。
- AR(p):利用过去观测值预测,捕捉“趋势延续”。
- ARMA(p,q):AR 与 MA 的结合,适用于平稳序列。
- ARIMA(p,d,q):增加差分阶数 d,处理非平稳数据,应用最广泛。
- SARIMA:加入季节性成分,适用于有明显季节模式的数据。
建模策略:ACF 快速衰减选 MA,PACF 快速衰减选 AR,均慢衰减需差分;结合 AIC/BIC 优选参数。
八、深度学习新范式
面对大数据与复杂模式,深度学习展现显著优势:
- MLP:基础神经网络,擅长捕捉非线性关系。
- RNN:专为序列设计,具有内部记忆,但存在梯度消失问题。
- LSTM:通过门控机制解决长期依赖,包含输入、遗忘、输出三个门。
- GRU:LSTM 的简化版,参数量少,训练更快。
- 1D-CNN:自动提取局部特征,计算效率高于 RNN。
优势与局限:深度学习能自动特征提取并整合多源数据,但依赖大量数据与调参经验。
九、实战建议与避坑指南
1. 建模路径:先进行描述性统计与可视化,检查平稳性必要时差分,从简单模型(指数平滑、ARIMA)起步,逐步尝试复杂模型。
2. 评估指标:MSE 对异常值敏感,MAE 更易解释,MAPE 适合业务汇报。
3. 常见陷阱:忽视预处理、过度依赖复杂模型、忽略假设检验、将预测结果视为确定结论。
十、结语
掌握时间序列分析即掌握从数据中洞察未来的能力。成功公式:理解业务 + 正确预处理 + 合适模型 + 持续迭代。建议结合原书《Practical Time Series Analysis》及代码实践深入学习。