大数跨境

AI算力撞上I/O墙,台积电把光引擎做成3D堆叠

AI算力撞上I/O墙,台积电把光引擎做成3D堆叠 半导体产业报告
2026-09-16
4
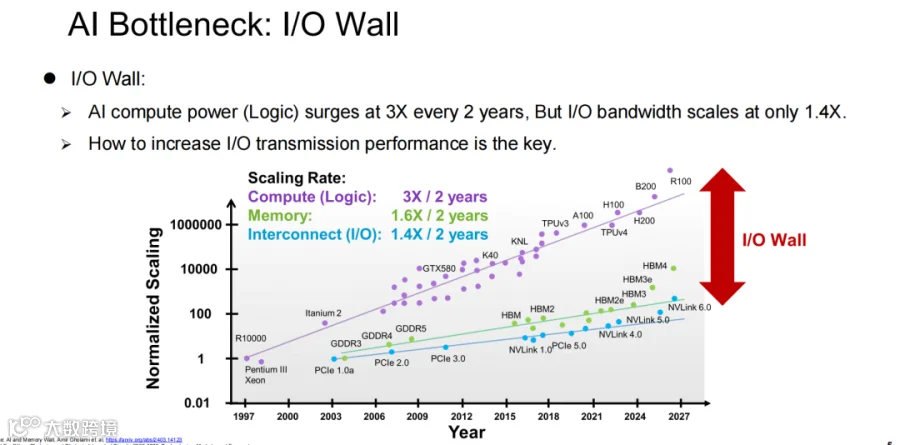
导读:逻辑算力每两年增长3倍,I/O带宽同期只增长1.4倍:芯片算得越快,数据越容易堵在进出口。
逻辑算力每两年增长 3 倍,而 I/O 带宽同期仅增长 1.4 倍:芯片运算速度越快,数据在进出口的拥堵越严重。
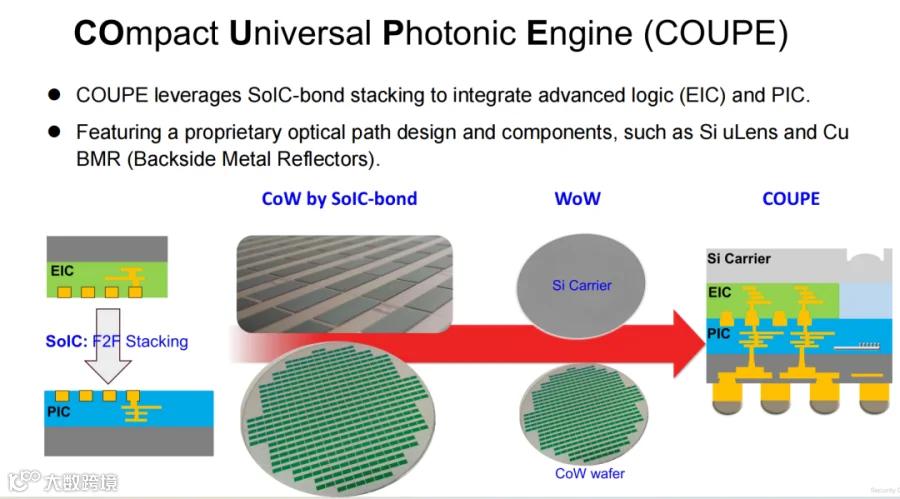
随着 AI 服务器持续扩张,除计算单元外,芯片间的数据传输速度与功耗已成为硬性约束。台积电在 SEMICON Taiwan 上提出的 COUPE 方案,旨在通过 SoIC 键合技术将电芯片与光子芯片垂直叠合,并接入 CoWoS 封装体系。其核心目标在于缩短电信号转光信号的路径,并为带宽扩展预留空间。

01| 算力激增,瓶颈移至芯片出口

以两年为周期,逻辑算力增长约 3 倍,内存增长约 1.6 倍,而互连 I/O 仅为 1.4 倍。三条发展曲线差距日益拉大。尽管封装内的 XPU 和 HBM 性能强劲,但数据进出芯片的速度未能同步跟进,导致互连压力剧增。
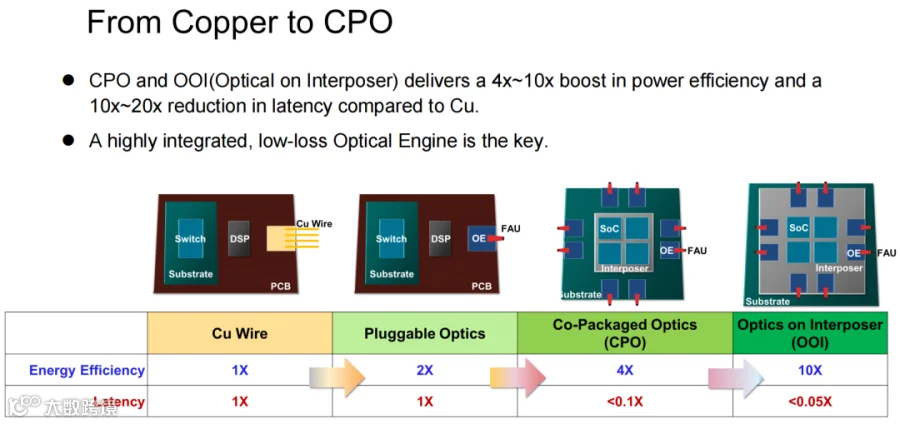
铜互连在高频下受传输距离限制,光互连正从机架间的横向扩展(Scale-out)向机架内、封装内的纵向扩展(Scale-up)演进。数据显示,CPO(共封装光学)的能效约为铜互连的 4 倍,延迟低于其 0.1 倍;OOI(光学 I/O 接口)的能效提升至 10 倍,延迟低于 0.05 倍。对于 AI 封装而言,光技术的价值体现在距离、功耗和延迟的全面优化。

02| 光引擎逼近 XPU,电连接极致缩短

共封装光学(CPO)存在不同形态。CPO-MCM 将光引擎置于封装基板上,适用于交换芯片;而 CPO-OOI 方案则将光引擎直接集成至计算芯片(XPU)的中介层,使其与 XPU 及 HBM 处于同一高密度互连结构中。光引擎位置每向计算芯片靠近一步,电信号在光电转换前的传输路径便缩短一分。
COUPE 方案进一步将光引擎压缩为上下两层:EIC(电子集成电路)承载高速电路,PIC(光子集成电路)承载波导、调制器和探测器,两者通过 SoIC 键合连接。光信号可通过光栅耦合器垂直进出或从芯片边缘进出,配合硅微透镜和铜背面反射器整理光路。至此,电光转换、光路设计与先进封装被纳入同一制造体系。

03| 3.2Tb/s 之后,带宽依赖三重乘数

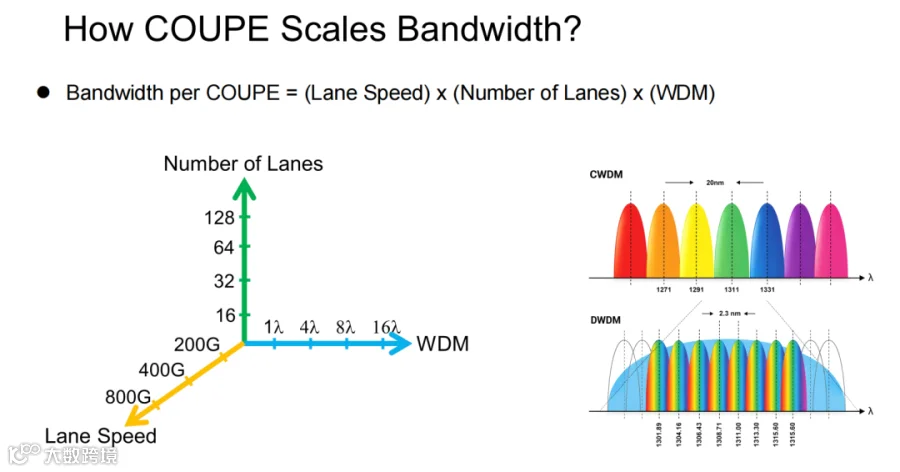
单颗 COUPE 的总带宽由三个关键参数决定:
单通道速率 × 通道数量 × WDM(波分复用)波长数 = 单颗 COUPE 带宽。
从 3.2Tb/s 演进至 51.2Tb/s 的路线图将压力分摊至三个维度,避免了单一器件需提升 16 倍的困境。评估光互连带宽时,需关注单通道速率、通道数量及波长复用数。
带宽扩展主要遵循两条路线:
  • “快而窄”:提高单通道速率,从 200G 迈向 400G 及以上,同时将通道数从 16 条扩展至 32、64 甚至 128 条。路线图规划从 2026 年的 3.2Tb/s 起步,预计 2027 年达 6.4Tb/s,随后逐步实现 12.8、25.6 及 51.2Tb/s。
  • “慢而宽”:保持温和的单通道速率节奏,增加并行通道数量,并利用 WDM 技术将波长数从 1 个扩展至 4、8、16 个以上。在总带宽目标一致的前提下,该路线将压力更多集中于波分复用和光路规模。
基于此乘法关系,实际设计中可多维同步调整。51.2Tb/s 代表器件、通道和波长共同推进的系统目标,目前尚未作为单一量产产品参数落地。

04| 器件带宽与光损耗决定演进速度

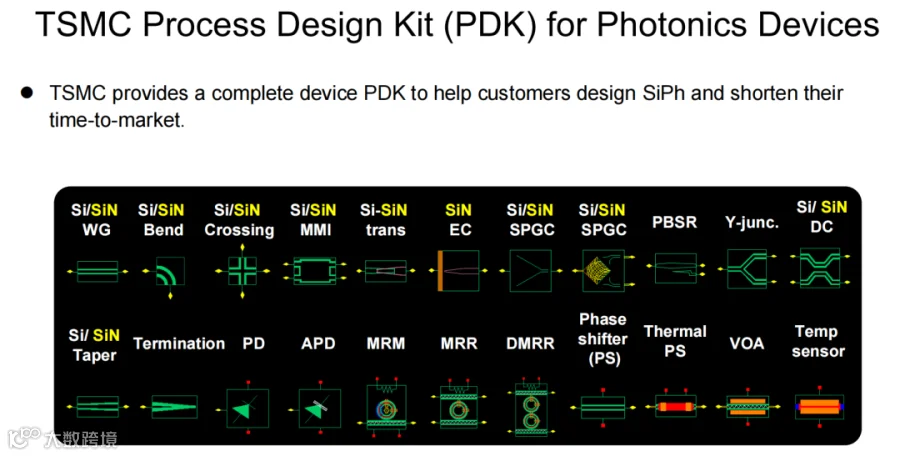
COUPE 配套了完整的硅光工艺设计套件(PDK),涵盖波导、耦合器、调制器、探测器等模块。客户可复用标准化器件组合光路,简化设计流程,加速硅光芯片的产品化进程。
“快而窄”路线首先要求调制器性能突破。COUPE 采用微环调制器,仿真显示,经电感峰化、调制器及 EIC 驱动器优化后,带宽可提升约1.8 倍。该数据源于仿真,量产性能仍需实测验证。
光耦合效率决定信号进出的稳定性。2025 至 2026 年间,COUPE 一维和二维光栅耦合器的插入损耗分别改善5.3% 和 11.03%;边缘耦合采用的氮化硅(SiN)尖端使偏振相关损耗改善 4.6%,晶圆内耦合损耗控制在 9.84% 以内。带宽公式设定理论上限,而损耗控制与晶圆一致性决定了通道的可靠复制能力。

05| COUPE 向光中介层延伸

未来,调制器、半导体光放大器及光源将进一步集成至 COUPE 背面,使其具备光学中介层功能。其边界将从独立光引擎扩展至整个封装平台,实现器件、光源、放大、键合及光纤接口的协同设计。
台积电将此路线纳入 CoWoS 体系,要求各方共同完成系统与技术协同优化。硅光器件、先进逻辑、3D 键合、封装及光纤连接能否在同一设计规则下高效协作,将直接决定光 I/O 的产品化速度。

结语 | 光 I/O 正在演变为先进封装核心议题

当光引擎从基板迁移至中介层,并通过 SoIC 实现 EIC 与 PIC 的垂直叠合,光互连已深入先进封装的核心版图。51.2Tb/s 指明了方向,而调制器带宽、耦合损耗、WDM 规模及 CoWoS 协同能力将决定演进速度。消除 AI 时代的 I/O 墙,不仅需要光更靠近算力,更需要整套封装架构围绕光技术进行重构。
【声明】内容源于网络
0
0
半导体产业报告
1234
内容 608
粉丝 1
半导体产业报告 1234
总阅读34.3k
粉丝1
内容608