

处理复杂文档时,常遇 AI 工具解析乱码、排版错乱的困境。即便更换多款 Agent 工具,面对 PDF 中的标题层级、表格逻辑及图文关联时,往往仍束手无策。
根本原因在于:主流 Agent 内置的多为传统 OCR 工具,仅能逐行提取文字,无法还原文档的结构化信息。
针对这一痛点,在 WorkBuddy 连接器中接入 TextIn xParse 智能文档解析工具,可提供一套完整的文档智能处理方案,有效解决复杂文档的解析难题。

01 WorkBuddy 接入 TextIn xParse:百页 PDF 精准解析
Agent 的核心能力不仅取决于原生模型,更在于其连接的外部工具。在 WorkBuddy 中集成 TextIn xParse 后,无论是加密 PDF、扫描件,还是跨页表格与复杂排版,均可通过自然语言指令一键完成高精度解析。
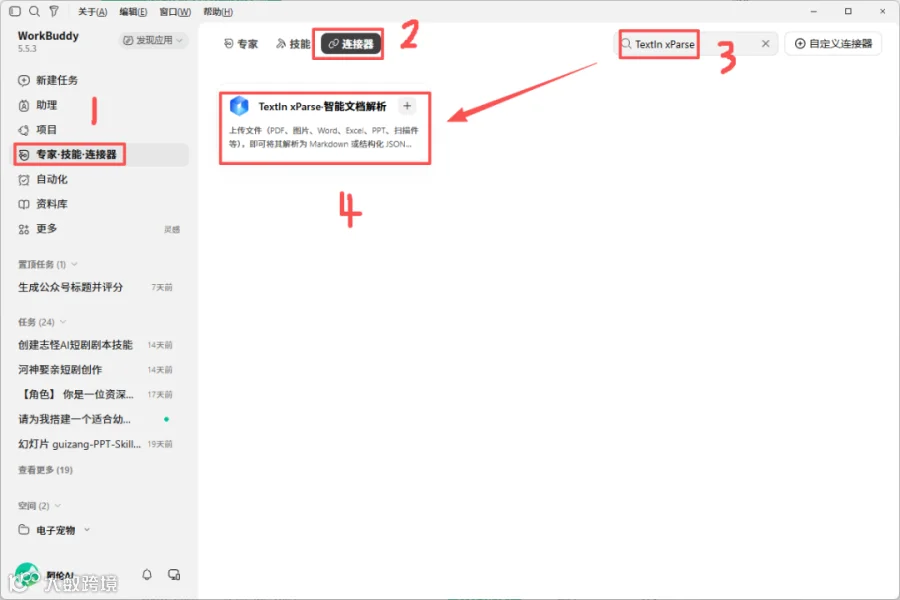
接入步骤:
- 登录 WorkBuddy,在连接器管理页面找到并下载 TextIn xParse 连接器。
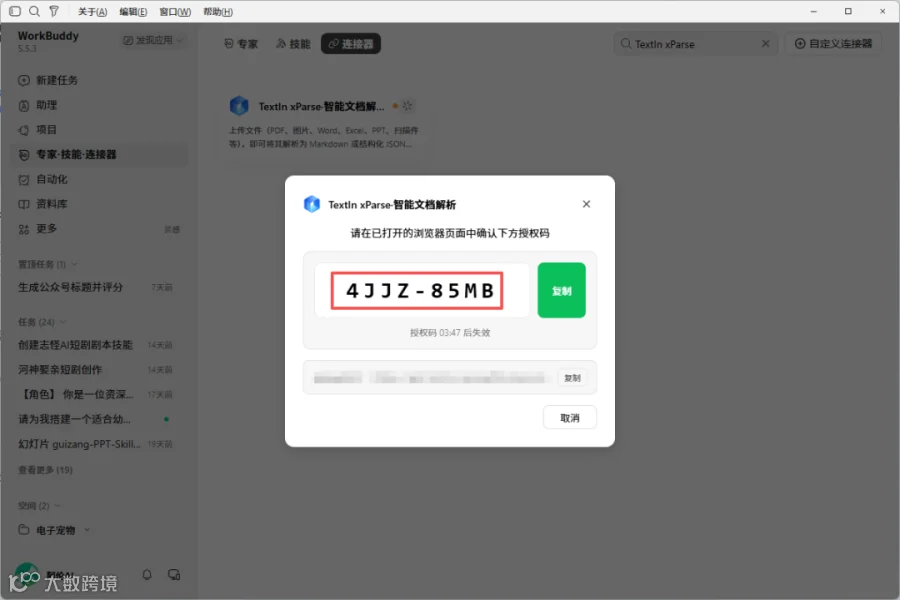
- 获取专属授权码,系统将跳转至 TextIn 登录界面,完成一键授权。

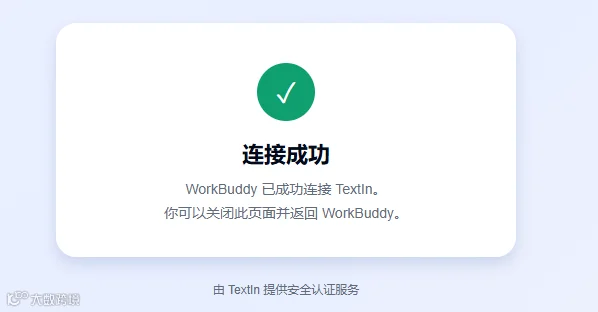
- 授权成功后,在任务界面的连接器选项中直接调用即可。

实测效果:
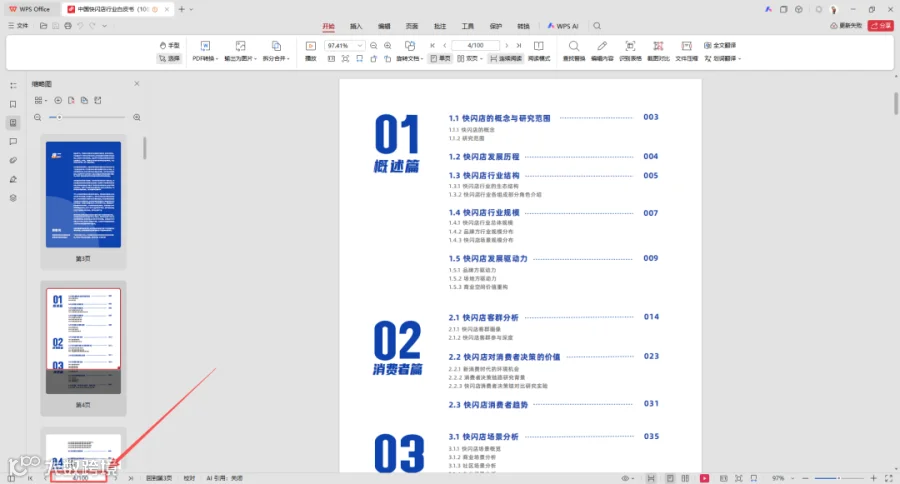
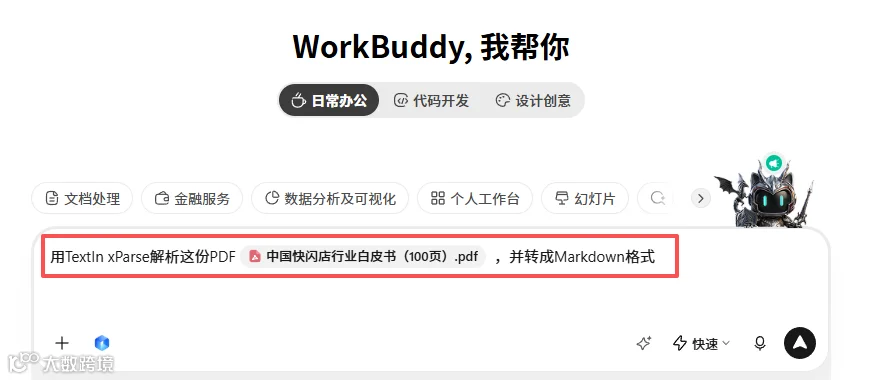
上传一份 100 页的 PDF 文件,输入指令“用 TextIn xParse 解析这份 PDF,并转成 Markdown 格式”,系统仅在数秒内即可完成结构化输出,内容清晰可用。
02 多语种与多格式兼容实测
TextIn xParse 不仅支持 PDF,还全面兼容 PPT、Excel、图片等多种格式,并具备强大的多语言识别能力。
场景一:PPT 翻译与格式转换
指令:将 PPT 文档翻译为全英文,并保持原有排版转换为 PDF。
结果显示,TextIn xParse 在保留原格式的基础上,准确完成了全文翻译与格式重构。
场景二:文档转 Excel 表格
指令:将文档每页内容保存为图片,提取图片信息并整理为 Excel 表格。
系统成功识别图像内容,并将非结构化数据转化为规范的表格数据,极大提升了数据处理效率。
此外,该工具支持超过 50 种主流语言识别,涵盖繁简中文、英法德日韩等语种,能够轻松应对全球化业务场景。
接入 TextIn xParse 后的 WorkBuddy,不仅能“读懂”文档内容,更能精准理解用户意图,实现从文档解析到业务落地的闭环。