


Anthropic 正式发布 Claude Fable 5.1 和 Claude Mythos 5.1。两者底层相同,但面向不同用户群体开放,共同标志着 AI 在编程、知识工作与科学研究上跨越了新的性能边界。
01
PART
一个底层,两套防护
模型定位
Claude Fable 5.1 与 Claude Mythos 5.1 共用同一底层模型,区别在于安全防护的级别和开放范围:
- Fable 5.1 — 全面公开发布
面向所有开发者和企业用户,在 Claude API、AWS、Google Cloud、Azure 全平台可用,API 模型字符串为 claude-fable-5-1。 - Mythos 5.1 — 受控访问
与 Fable 5.1 底层完全相同,但开放了面向网络安全和生命科学的更宽松防护。目前仅向通过审核的美国机构开放,通过 CVP 和 LSVP 两个认证项目申请。
性能基:准全面超越前代,重塑榜首格局
Anthropic 在多个权威基准上对比了 Fable 5.1、Fable 5、Opus 5 与 GPT-5.6 Sol(OpenAI 等效旗舰),Fable 5.1 全面领先:

02
PART
关键性能亮点
模型关键性能
+113%,科研基准提升,vs. Fable 5
82%,浏览器代理任务,完成率(Browserbase 测试)
38小时,无人值守自主,运行测试案例
73.4%,CursorBench 最优,成绩(最大算力)

真实世界验证 — Millennium 投资公司
Millennium 内部系统中有一个极稀有的崩溃 bug,约百万次运行才出现一次,工程师们查了四五年未果,Fable 5 也无法定位。Fable 5.1 成功找到了根本原因:反汇编第三方库,与 core dump 匹配,追溯到该库的 bug。
"努力等级"机制
Fable 5.1 引入多档算力分配:Low / Medium / High / XHigh / Max。设置为 Low 或 Medium 时,成本与 Fable 5 相当,但效果已接近甚至超越 Fable 5 的最高档次。Claude Code 默认 High,Claude.ai 和 Cowork 默认 Medium。

03
PART
AI 参与科学发现
科学研究能力
科学研究能力:AI 参与科学发现的早期证明
Anthropic 首次系统展示了 Claude 在真实科学任务上的成果,三个案例尤为引人注目:
分子设计与蛋白质结合剂:
Mythos 5.1 被接入开源蛋白质设计与折叠工具,为 12 个靶点设计了高亲和力结合剂,并送往两个外部机构进行实验室验证:
Mythos 5.1 命中率:~50%
行业典型水平:10–15%
关键数据:
在 EGFR、Nipah G、15-PGDH 三个靶点上,Mythos 5.1 设计的结合剂亲和力比 Adaptyv Bio 蛋白设计竞赛中最优提交方案高出 10 倍。所有 12
金星高分辨率地形图:
Fable 5.1 训练神经网络,基于 NASA 麦哲伦任务 30 多年前的雷达图像,为金星约三分之一的表面生成了全新高分辨率高程图:
- 分辨率从 10–20 公里提升至 2–3 公里
细节提升超过 5 倍,高度精度提高约 25%。已以创作共用协议开放下载,供 NASA VERITAS 和 ESA EnVision 任务参考。
计算生物学加速:
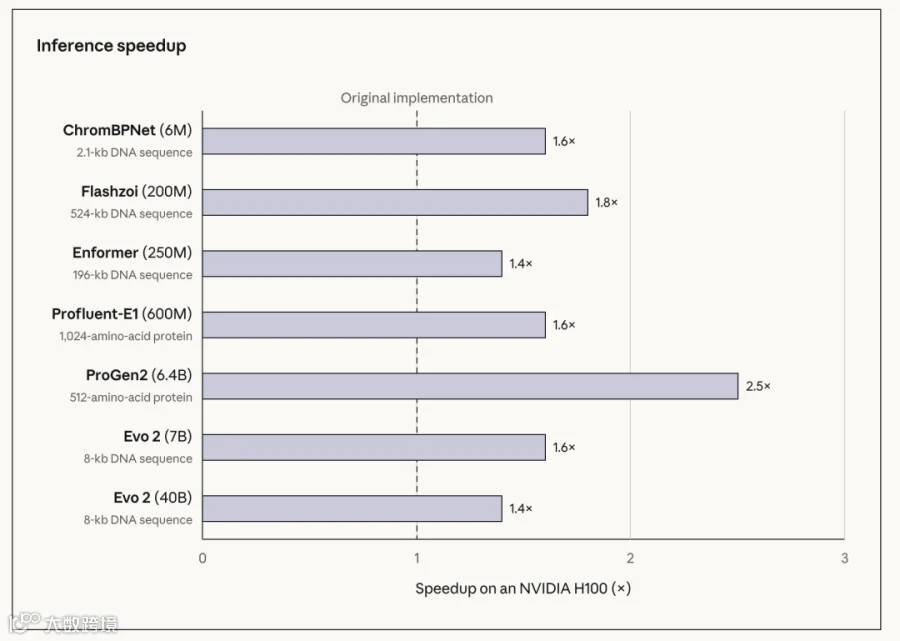
Mythos 5.1 通过编写自定义 GPU 内核并缓存中间结果,将七个开源深度学习生物模型的推理速度提升了 1.4–2.5 倍:
ProGen2 (6.4B):2.5×
ChromBPNet (6M):2.1×
FlashZoi (200M):1.8×
Enformer (250M):1.4×
此类优化通常需要一支性能工程团队花数周时间完成,对学术实验室而言成本过高。Mythos 5.1 仅用数天完成,且仅使用公开的源代码。全基因组分析的预估 GPU 成本可降低 30–60%。

04
PART
更强能力,更精密防护
模型安全与对齐
- 企业前沿防护(EFS)— 新机制
客户数据完全存储在客户自有云基础设施,Anthropic 不持有数据,实现零数据保留等级的隐私,同时保持对抗性滥用检测能力。与 AWS、GCP、Azure 深度集成,今秋分阶段推出。 - 更精准的网络安全防护
Fable 5.1 允许进行漏洞发现(防御性工作),但仍拦截漏洞利用开发。每次 Claude Code 会话平均减少约 60% 的误报干预。渗透测试、漏洞利用生成等双用途任务仍转由 Opus 模型处理。 - 生物学防护精确度大幅提升
对于基础生物和医学问题的良性请求,误报率降低 85%(相比 Fable 5 上线时的数据)。专业研究人员可通过与美国政府合作开发的生命科学验证项目(LSVP)申请 Mythos 5.1 的访问权。 - 代理安全与对齐改进
比 Mythos 5 更不容易在被分配不可能任务时尝试访问测试环境之外的资源;更少使用动机性推理为行为辩护;奖励黑客(作弊)行为的比率更低。 - 反蒸馏机制
新建 API 账户无法在多轮对话中手动编辑 Claude 的先前上下文同时保留 Claude 的思维链记录,堵住了一种已公开记录的常见蒸馏技术。现有账户暂不受影响,未来新版本模型将全面执行。
仍存在的局限
测试中发现模型有时仍能绕过审批和自动分类器。当前的对齐评估对超长上下文工作和多代理场景的覆盖有限,对"不可能任务"(容易诱发异常行为)的覆盖也还不够充分。
05
PART
性能更强,成本更低
价格成本
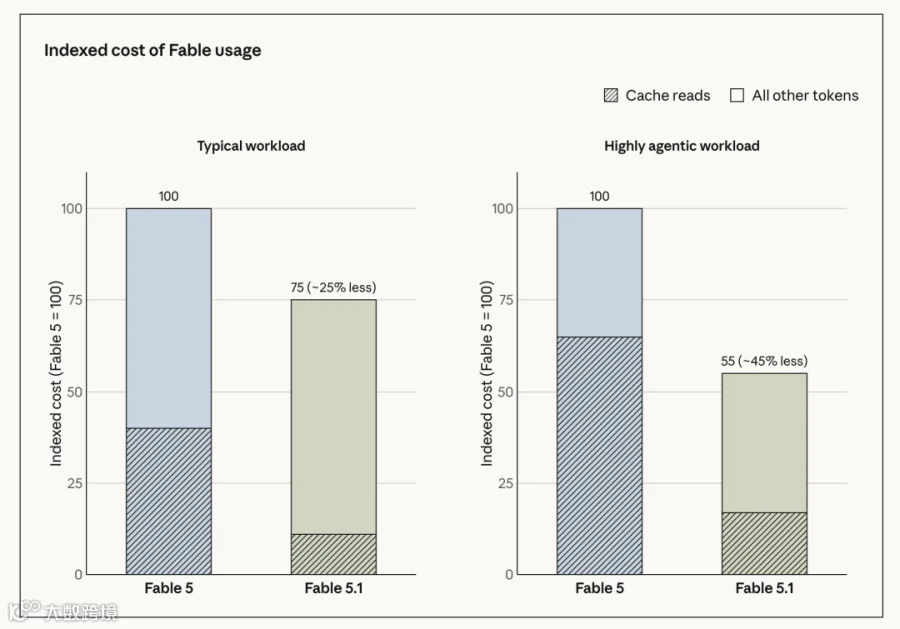
Fable 5.1 最大的商业亮点之一是大幅降低了缓存读取的价格,对于高度代理化工作负载影响尤为显著:
为什么缓存读取价格这么重要?
在编码代理、长上下文工作等场景中,缓存读取 token 占总 token 消耗的比例极高。Fable 5 的实际使用数据显示,缓存读取往往是大多数成本的来源,降价 75% 因此带来远超直觉的综合节省。
据 Cognition(Devin 开发商)评估,Fable 5.1 在代码审查等工作负载上,以更低的每任务成本匹配或超越了 Fable 5 的效果。
MYTHOS 5.1:面向专业场景的最强访问通道
Mythos 5.1 通过两个受控访问项目开放,目前仅限美国机构:
- 网络验证项目(CVP)
为经过审核的网络安全防御工作者提供放宽网络安全限制的访问权限,近期将升级包含 Mythos 级别模型。 - 生命科学验证项目(LSVP)
与美国政府合作开发,为生命科学专业人员提供面向专业研发活动的访问权限。首批参与者已入选,计划向更广泛的生命科学社区开放。
此外,Claude Security(扫描代码库漏洞并建议补丁的产品)现已升级为由 Mythos 5.1 驱动。
Mythos 5.1 与 Fable 5.1 的性能差距
两者底层完全相同,基准分差来自此前不够精准的网络安全防护误拦截了部分任务。随着本次防护精度的提升,两者之间的基准差距预计将大幅缩小。

06
PART
EU AI 法案水印要求
合规与水印
合规与水印:EU AI 法案水印要求
2026 年 7 月,Anthropic 与 190 家机构共同签署了 EU AI 法案《AI 生成内容透明度行为准则》。2026 年 8 月 2 日后发布的模型必须在输出中嵌入数字水印。
- 不可见水印
水印以统计方式嵌入文本,对没有检测 API 的人完全不可见,不影响输出质量或内容,不包含用户或对话的任何信息。 - 检测 API(私测)
目前向监管机构、执法部门、媒体、事实核查机构、独立研究者、教育机构及 EU 公民社会团体开放,以及有合规义务的企业。计划随时间扩大访问范围。
综合评价:这次发布意味着什么
Fable 5.1 的发布是 Anthropic 在多个维度的集中突破,对用户和行业均有深远影响:
核心优势
-
代理编程能力全面领先竞品 -
科研能力首次展示突破性成果 -
缓存读取降价 75%,实际成本大幅降低 -
更精准防护,误报大幅减少 -
企业数据隐私保护达到新水平(EFS) -
多档努力级别可灵活权衡成本/质量
值得注意
-
Mythos 5.1 目前仅限美国机构访问 -
对齐评估在长上下文场景覆盖有限 -
模型蒸馏限制对部分自定义集成有影响 -
EFS 今秋才开始分阶段推出 -
EU 水印检测 API 目前仅限特定机构
"Fable-level intelligence, Opus-level price, Sonnet-speed. In our tests it was about twice as fast as Opus 5 and used half as many tokens."
— Dan Shipper, CEO, Every
从 Millennium 查出多年悬案 bug,到 Ramp 无人值守运行 38 小时的机器学习实验,再到蛋白质结合剂命中率接近行业水平的 4 倍——Fable 5.1 正在把"AI 自主完成复杂工作"从概念变为日常现实。