


数据浪潮奔涌,版权赋能未来。2026年9月9日,在第十五届中国知识产权年会上,“数智时代版权新生态”论坛在北京国家会议中心二期成功举办。本届论坛由知识产权出版社主办,汇聚版权法治建设、行业监管、出版产业、法学研究与互联网科技领域的权威专家与领军代表,紧扣“数智时代驱动下版权生态重构”的核心趋势展开深度研讨。

知识产权出版社党委书记、董事长刘超主持致辞环节,他指出:当前国家文化数字化战略、知识产权强国建设、“人工智能+”行动等一系列顶层部署,与产业变革、技术革新深度交汇、同向发力。本届论坛坚持“技术向善、版权为核、创新为要、产业为本”的核心理念,旨在通过跨界对话助力各类市场主体规范用好版权制度、激活版权资产价值,推动技术创新、版权保护与产业发展良性互动、协同共进。
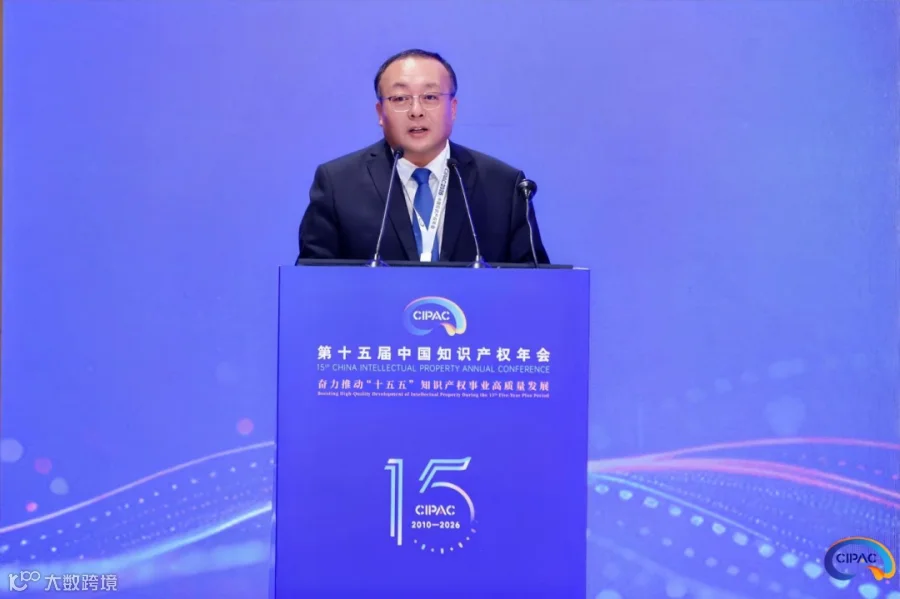
知识产权出版社党委书记、董事长刘超主持致辞环节
一、致辞:在数智时代重塑版权制度的新坐标
甘藏春:在对数智时代挑战的积极回应中,逐步实现中国版权制度的根本性变革
国务院法制办原副主任、第八届中国法学会副会长甘藏春在致辞中,以宏阔的历史视野和系统化的理论剖析,勾勒出数智时代中国版权制度变革的路径图。他指出,人类正身处碳基生命与硅基智能共生共存的时代,硅基智能一经诞生便不可逆转,而版权作为最先感知时代脉动的制度,正面临权属认定与归属纷争复杂多样、传统授权机制难以应对海量数据使用、维权成本高与责任划分难三大系统挑战。
在深刻把握数智时代“以人机关系为基础”的社会形态后,甘藏春提出版权制度的变革趋势:从人类独立创作走向人机协同共创,作品价值从内容阅读转向数据训练,版权资产从静态作品转向可拆分、可流转、可溯源的动态数字资产。他强调,当前版权制度正处于新旧规则“相持阶段”,既要保持战略耐心,更要在矛盾冲突中主动探索平衡点。针对版权制度改革,他提出三点构想:其一,版权基点要扩容,以保护原创性思想为基点构建新的版权体系,守护人类独立思考这一最宝贵的特质;其二,要立足现实,积极探索,加快推进训练使用数据授权机制与收费机制的建立;其三,实行“小步快跑”立法策略,灵活运用多种立法机制,在变革中不断完善中国自主知识体系下的版权制度。
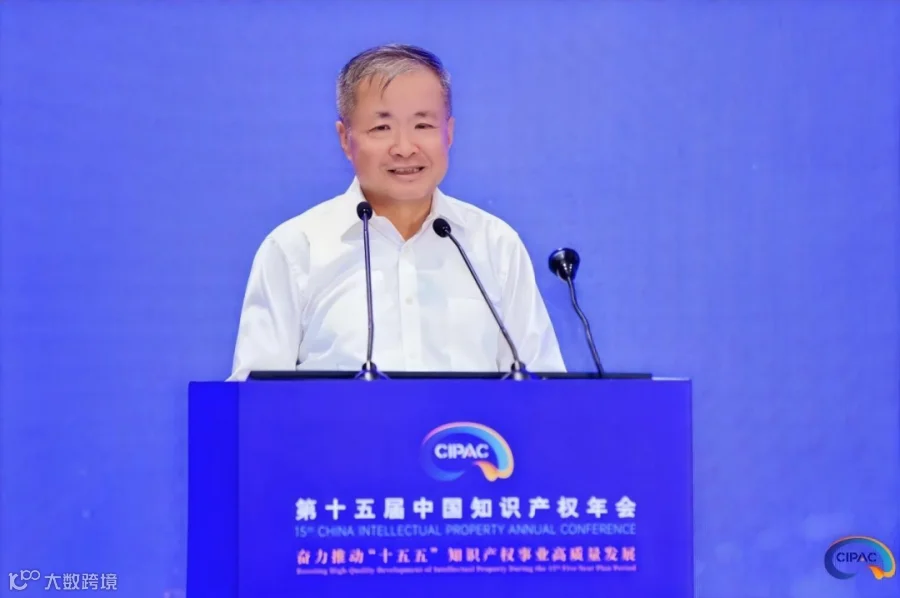
国务院法制办原副主任、第八届中国法学会副会长甘藏春致辞
阎晓宏:以创作与使用的平衡原则,构建版权新生态新秩序
国家版权局原副局长、中国版权协会原理事长阎晓宏在致辞中强调,版权新生态、新秩序的建立,最核心的问题是能否平衡好生成式人工智能服务提供者与版权作品权利人的关系,并系统厘清了四个关键问题:其一,人工智能训练使用了享有版权的作品,结论是肯定的;其二,虽受版权保护的作品在训练数据中数量并非最多,但恰恰是这部分优质数据决定了大模型的质量;其三,训练使用作品海量且隐蔽,权利人无从举证,应由服务提供商本着透明原则公布使用了哪些数据、哪些作品;其四,训练使用作品的价值评估应与商业价值相关联,授权模式须审慎选择。
针对授权模式,阎晓宏认为,"合理使用"将把利益倾斜于服务提供商、全面剥夺权利人人格权与获酬权,对版权新生态具有破坏性,绝对不可取;强调事先授权虽具现行法律合规性,但必将扼杀大模型发展,亦不可行;将训练使用纳入法定许可、投入使用后支付合理报酬,则是可以讨论的方向。他强调,新生态新秩序建立的最高原则是"创作与使用的平衡",国际经验、立法与诉讼案例均只是参考,衡量标准始终是能否惠及公众、推动社会进步。在立法层面,他认为,应基于法理与平衡原则加快立法;在立法解决之前也不能坐等,应协调权利人组织与服务提供商本着透明原则坦诚交换意见、达成协议,为立法打下良好基础。
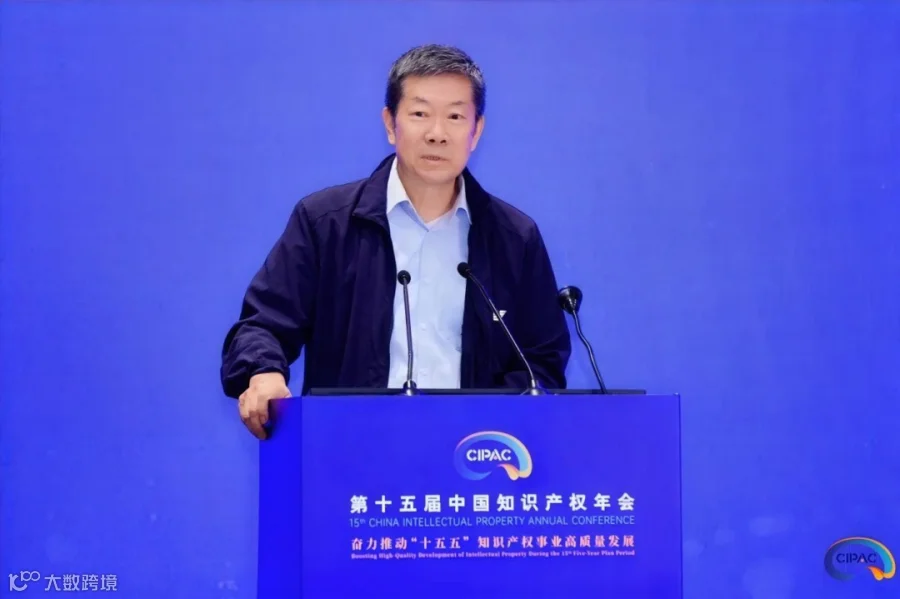
国家版权局原副局长、中国版权协会原理事长阎晓宏致辞
二、主题演讲:从监管、产业到法理的多维深度碰撞
主题演讲环节由知识产权出版社总编辑刘洋主持。六位专家围绕AI生成内容合规应用、数字内容创新创作、版权确权与跨主体授权、内容业态模式创新、版权产业价值转化等前沿议题展开深度研讨,为构建规范、透明、互利共赢的数智版权新生态贡献智慧与方案。

知识产权出版社总编辑刘洋主持主题演讲环节
段玉萍:规范AI训练数据使用,为出版业发声求解
中宣部版权管理局原副局长段玉萍以《AI训练使用作品的版权问题》为题,直面人工智能时代版权治理的核心争议。她认为,AI训练涵盖抓取、存储、拆解、学习、输出等阶段,对作品的复制是其基础,构成著作权法意义上的使用;同时强调,数据来源合法仅是物权意义上的合法获取,并非著作权层面的"授权许可"。她分析认为,我国《著作权法》规定的十二项合理使用情形均不适用于AI训练,鉴于当前各方对AI训练使用作品的争议很大,立法应保持审慎理性,不建议增加AI训练的合理使用制度。同时,由于目前《著作权法》法定许可的规定缺乏权利人获酬的制度保障、补偿金制度亦属空白,同样不建议增设相应权利限制。结合当前我国政策动态,她为出版业提出“积极发声、抱团取暖、做好自己、寻求合作”的应对路径,呼吁AI产业为高质量版权作品支付合理费用,实现产业平衡与良性发展。

中宣部版权管理局原副局长段玉萍演讲
高世屹:从图书编纂者到生态构建者,以权威语料夯实AI基石
中国大百科全书出版社党委书记、社长高世屹以《从图书编纂者到生态构建者——人工智能时代百科权威知识语料库建设与版权价值》为题,回应了“万物皆可生成”时代出版业的价值之问。他指出,AI缺的不是信息,而是合规、权威、可授权、可溯源的高质量语料库;高质量语料库建设对中国话语体系具有基础性支撑作用,版权产业作为GDP占比约7%的支柱产业,其健康发展关乎整个产业生态。作为国家级可信数据集的代表,《中国大百科全书》以近半个世纪、六万余名专家持续编撰形成的知识体系,成为自主知识体系建设的标杆。高世屹介绍,百科社已牵头组建人工智能高质量语料库建设联盟,坚持“先授权、后使用”的版权底线,通过标准API知识输出、授权模型训练、开发专属智能体等方式与AI企业开放合作,坚决反对免费、低价、未经授权“杀鸡取卵”式的扒取,守护版权保护与知识创新的良性循环。
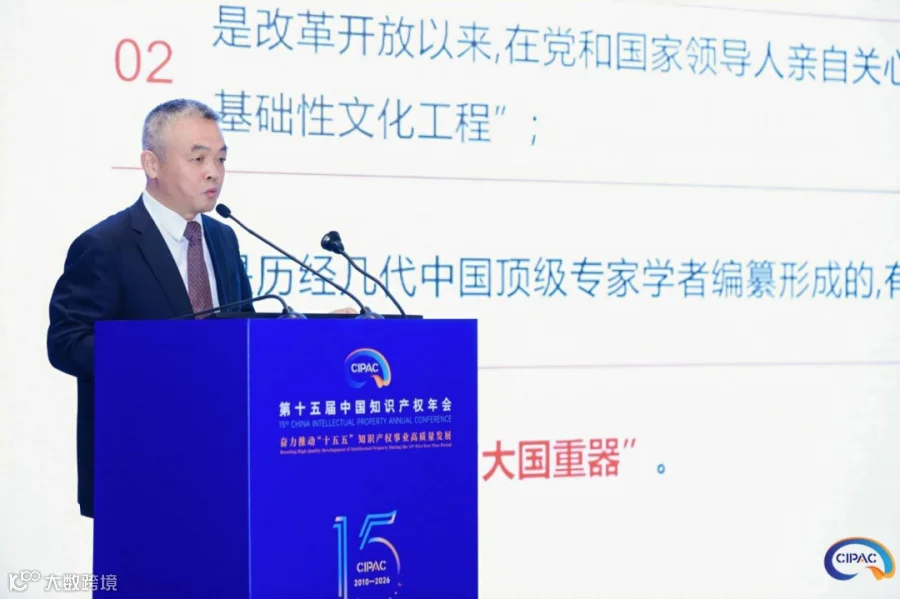
中国大百科全书出版社党委书记、社长高世屹演讲
王迁:厘清AIGC可版权性,坚守人类创作的法律基石
华东政法大学学术委员会副主任委员王迁以《人工智能生成内容与著作权保护》为题,从"AI生成内容是否为作品"与"人工智能作为辅助工具"两个层面展开法理辨析。王迁指出,著作权法上的"创作"是人基于自由意志直接决定构成作品表达性要素的智力活动,创作工具只能是人的意志得以付诸实施的"消极手段"。他通过对照实验证明,AI生成内容由算法与数据训练决定,而非由人的自由意志直接决定,故不构成受著作权保护的作品,提示词相对于人工智能生成的内容仅属于思想而非表达。在此基础上,王迁认为人工智能完全可以作为辅助工具纳入现行法律框架:一是借鉴人工智能生成内容的创意进行再创作;二是对生成内容进行达到独创性要求的实质性修改,比照演绎作品进行保护;三是对大量生成片段进行独创性选择编排,构成汇编作品。厘清这些边界,有助于在保护人类独创智力成果的同时,为人工智能的合理辅助应用提供清晰的著作权指引。

华东政法大学学术委员会副主任委员王迁演讲
管育鹰:探求AI训练侵权例外规则,以竞争结果划定边界
中国社会科学院知识产权中心主任、研究员管育鹰围绕《AI训练著作权侵权例外规则设立探讨》分享洞见。她将AI与版权交叉的议题归纳为“进料—生成—责任”三大核心环节,指出前端投喂是一个权利义务关系不清的“黑箱”,数据安全法、网络安全法等公法手段只能罚款、关停,无法对著作权人的财产损害作出赔偿判断,相关救济仍须回归著作权法。她分析,我国《著作权法》的合理使用与法定许可重在非商业的公共文化事业场景,而竞争性商业使用必然引发利益纠葛,因此她赞同"非竞争性使用"的判断思路。她认为欧盟以“使用主体限制”界定例外的思路更契合我国国情,主张对文化事业等非竞争性使用开放合理使用空间,但控制前端、进入文化产业竞争领域则必须“一概授权”。她特别解读了最高人民法院司法解释中的“不侵权抗辩”举证责任转换安排,认为其展现了司法智慧,主张通过个案裁判逐步磨合、积累共识,实现AI与版权产业的平衡发展。
中国社会科学院知识产权中心主任、研究员管育鹰演讲
朱开鑫:观察全球版权治理规则,凝练三点治理共识
腾讯研究院法律研究负责人朱开鑫以《模型训练版权治理的全球规则观察》为题,系统梳理了两大立法路径:以美国、韩国、以色列为代表的“四要素分析路径”呈现立法克制、两端清晰、中间留白的谦抑态势;以欧盟、日本、英国为代表的“列举式例外路径”则呈现“旧瓶装新酒”的适配张力,强调对既有版权例外规则的适用限制,明确"例外的例外",实现版权行业与模型产业的利益平衡。结合国内立法留白、司法个案探索与产业自我保护的现状,他提出全球层面的三点基础共识:一是保障版权人享有"拒绝模型训练"的权利;二是模型厂商获取训练数据应坚持"来源合法",不得规避技术保护措施或违背行业共识性的数据获取规则;三是经训练后输出被训练作品本质上已非模型训练而是直接复制传播,应依法规制。他建议在争议尚未达成共识时保持适度制度留白,以科学翔实的数据论证支撑政策走向。

腾讯研究院法律研究负责人朱开鑫演讲
傅宏宇:破解零和博弈,迈向AI版权长远合作的生态共赢
阿里研究院人工智能治理中心主任傅宏宇在题为《AIGC时代的版权困境:破解零和博弈,走向长远合作》的演讲中,从"走进模型黑箱""走出模型黑箱""面向未来"三个维度系统剖析了人工智能时代的版权治理路径。他以《纽约时报》诉OpenAI案为切入点指出,大模型训练并非对原始语料的记忆背诵,而是对其中隐含规律的学习与抽象提取,具有高度转换性,可构成合理使用;但输出端的"反流"等技术风险仍可能构成复制传播与市场替代。他认为,破解之道在于主动管控风险、回归版权初衷:一方面通过拦截、提示词重写、RAG外部知识补强等技术手段与"通知—删除"等平台机制,实现版权作品的可溯源与正当导流;另一方面超越零和博弈,以授权、溯源、正版导流和收益分享实现利益最大化与合理分配。他以OpenAI Sora2与好莱坞、Suno与华纳音乐、《纽约时报》与亚马逊等"以打促和"的合作案例证明,模型需要高质量语料、创作者需要合理回报,二者能够互相成就,共享AI发展红利,最终走向互利共赢的长远合作。
阿里研究院人工智能治理中心主任傅宏宇演讲
三、倡议与展望:共建规范透明、互利共赢的数智版权新生态
论坛尾声,知识产权出版社总编辑刘洋代表主办方向全行业发出三点倡议:一是坚持合规为先、技术向善,主动适应人工智能发展趋势,规范AI训练的数据使用、内容生成与传播运营行为,推动技术创新在法治与版权框架下有序开展;二是坚持价值为本、盘活资产,完善版权确权、授权、流转与价值转化机制,让静态内容资源转化为可运营、可增值的数字资产;三是坚持开放协同、共建生态,打破产业壁垒与零和博弈思维,推动内容机构、科技企业、研究机构、行业协会多方联动,共建规范透明、互利共赢的跨平台版权合作体系。
从制度变革的顶层思考到语料库建设的产业实践,从可版权性的法理辨析到全球治理规则的比较观察,再到零和博弈破解的合作蓝图,本届论坛汇聚多方智慧,为“数智时代版权新生态”勾勒出清晰而富有远见的轮廓。与会嘉宾普遍认为,面对人工智能浪潮带来的系统性变革,唯有坚守“创作与使用平衡”的根本原则,秉持技术向善、开放协同的理念,以更具前瞻性的制度供给与更具建设性的产业协作,方能筑牢版权保护与知识创新的坚固基石,让版权事业在数智时代焕发新的生机与活力。
