

最近不少细心的用户在 iOS 上的 Gemini App 中发现了一个体验极佳的微小变化:
如果你的 iPhone 系统语言设置为纯英文(en-US),你直接点击输入框旁的麦克风,用中文提问,甚至用中英夹杂的方式说话,Gemini 都能毫不费力地精准识别并转写为对应的文字,然后给出流利的回答。
而在过去相当长一段时间里,这几乎是一场“灾难”——在英文系统环境下,只要你对着麦克风说中文,屏幕上往往会强行蹦出一连串发音相似、但语义完全荒诞不经的冷僻英文单词;想要让它听懂中文,你必须老老实实去系统设置或 Google 账号偏好里将语言手动切换为中文。
这个看似只是“修了个多语言 Bug”的交互改进,究竟是什么时候上线的?底层究竟发生了怎样的技术重构?
更进一步追问:早在 2023 年 5 月,OpenAI 的 ChatGPT iOS App 就已经实现了全语种无缝混说;而发明了 Transformer 架构、坐拥 WaveNet、Tacotron、USM 以及全球顶尖机器翻译团队的 Google,为什么在这个看似并不复杂的基础产品体验上,足足晚了三年?
一、 变化发生在何时:2026 年 6 月的分水岭
在探讨技术之前,我们先理清这项能力在产品端的上线时间线。
在 Gemini 的产品形态中,语音交互其实分为两个截然不同的场景通道:
右下角的 Gemini Live 实时双向流式通话:早在 2024 年底,Google 便开始将 Gemini Live 向 40 多种语言逐步推开,并在 2024 年 11 月独立 iOS App 上架后逐步完善了双向实时多语言支持。
输入框旁的麦克风听写(Voice Input / Dictation):这正是大多数用户日常高频触发的普通文字输入按钮。这个按钮支持全语种免切换识别的关键节点,发生在 2026 年 6 月中旬。
2026 年 6 月 15 至 17 日,Google Gemini 团队副总裁 Josh Woodward 正式对外宣布了移动端语音输入的重大升级:
支持 70+ 种语言自动检测:用户无需在设置中反复手动切换语言偏好,即便手机操作系统是纯英文,直接输入中文、日文、印地文或西班牙文,系统均会自动识别;
支持混合语言输入(Code-Switching):允许用户在同一个句子中自由混用多种语言,例如“帮我把这个 report 总结成一段中文 summary”;
全面覆盖 Android 与 iOS:同时在双端原生 App 上线,并随后向 Web 端铺开。
看似只是一个普通的版本迭代,但它标志着 Google 移动端语音输入底层彻底完成了从“旧时代传统级联架构”向“新一代原生音频多模态大模型”的脱胎换骨。
二、 致命死穴:为什么旧架构在英文系统说中文必崩?
要理解现在的“无缝理解”,首先必须拆解为什么过去在英文 iOS 系统下说中文会彻底崩溃。
在过去的十余年里,包括 Google Assistant、Gboard 乃至各主流操作系统的默认听写引擎,采用的都是极其经典的级联分立式语音识别(Cascaded ASR Pipeline)。

语音识别链路代差:级联 ASR vs 原生多模态
这套传统级联链路在工程上通常高度解耦为四个独立步骤:
1. 静态语种绑定(Locale Binding)
传统 ASR 引擎由于模型体积与词表限制,无法在单次会话中同时加载全球数百种语言的全部字典。因此,客户端在开启麦克风录音的瞬间,必须先通过外部参数指定当前会话的目标语种(Target Locale)。
当你的 iPhone 系统语言为英文时,旧版 SDK 会直接读取宿主系统的环境参数 Locale = en-US,并由此向下游管道发出死命令:“接下来传入的音频,一律按美式英语进行解码。”
2. 音素词典强制对齐(Acoustic & Lexicon Mismatch)
紧接着,音频频谱被送入特定的英语声学模型(Acoustic Model)与发音词典(Pronunciation Lexicon)。
英语的发音词典完全由英语的音素(Phonemes,如 /k/, /æ/, /t/)组成,其中根本不存在中文的声调(四声)以及汉语拼音特定的声母与韵母表征空间。
当用户说出“你好”时:
它的声学波形特征([ni] [xɑʊ])进入了解码器;
解码器只能在英文音素空间里疯狂寻找“声学距离最近”的组合;
最终被强行投射成了英文单词 “Knee how” 或者 “Neo”。
3. 语言模型(LM)的语义断裂
在传统级联 ASR 的最后一步,是一个纯粹的 N-gram 或小型语言模型。由于它只具备英文语法和词频统计先验,面对“Knee how”这种荒唐拼写,它不仅毫无跨语言纠偏能力,反而会依据英文统计概率将其进一步“修正”为发音相近的某种合理英文搭配。
这就导致了过去常见的一幕:只要系统语言不匹配,无论你的中文发音多么清晰字正腔圆,屏幕上打出的永远是荒腔走板的英文火星文。
三、 破局本质:从“拼图级联”到“原生音频多模态”
2026 年中旬 Gemini 展现出的“免切换与混说能力”,并非简单地在麦克风前面加了一个“语言选择下拉框”,而是彻底推翻了上述分立链路,换上了原生端到端音频多模态架构(Native Multimodal Audio Architecture)。
其技术突破主要体现在以下四个核心环节:
1. 抛弃发音词典,使用原生音频切片(Streaming Audio Tokens)
新架构不再试图将声音切碎并强行翻译为某种语言的孤立音素(Phonemes)。
麦克风采集到的连续音频频谱波形,通过音频编码器(Audio Tokenizer)直接离散化为一系列高维连续音频切片(Audio Tokens)。这些 Tokens 与文本字符(Text Tokens)在底层拥有相同的地位,直接输入到大语言模型的统一隐空间(Unified Latent Space)中。
这意味着模型接收到的直接是“声音的本质”,不存在任何硬编码的单一语言词表屏障。
2. 全语种动态即时检测(LID on-the-fly)
模型不再依赖客户端传递的外部环境变量(如系统 Locale),而是具备了毫秒级的动态语种检测(Language Identification)能力。
当用户开口说话时,音频流最初的数十毫秒频谱特征就足以在多模态注意力矩阵中激活特定语种的表征通路。模型可以在完全不清楚用户母语的情况下,实时“感知”到当前输入正在从英语跃迁至汉语。
3. 跨模态上下文联合消歧(Cross-Modal Disambiguation)
这是大语言模型赋能语音识别最不可思议的质变点。
在传统 ASR 中,声学模型与大语言模型是割裂的;而在 Gemini 原生多模态架构下,音频特征与海量的世界知识、多语言语法处于同一注意力计算机制中。
举个典型例子:当你带着浓重的非母语口音说出中英夹杂的句子:
“帮我把这个 report 总结成一段中文 summary。”
传统模型会在“report”切回“总结”时产生剧烈冲突,甚至因为中英文混杂导致切词边界彻底崩溃。而原生多模态模型同时结合了前后文的语义逻辑:在预测到“帮我把这个”之后,“report”的声学特征与语义需求高度共现,模型几乎是以 100% 的概率锁定了该词,并在毫秒级完成语种边界的平滑过渡。
4. 双层端云协同语音活动检测(Dual-tier VAD)
很多语音系统在处理多语言混说时,常常因为语种切换时的微小停顿、或者“呃”、“那个”等语气词而过早截断。
Gemini 升级了端云协同的 VAD(Voice Activity Detection)网络:轻量级端侧网络负责滤除背景杂音,云端大模型则结合语义完备度动态判断用户是否真正讲完了整句话,有效消除了意外抢断和多余吞字。
四、 巨头的困境:手握全套王牌,Google 为何晚了三年?
理解了技术原理,我们来到本文最具戏剧性的核心问题:
OpenAI 在 2022 年底开源了多语言语音模型 Whisper,并在 2023 年 5 月上线 iOS ChatGPT App 时,其输入框麦克风就已经原生支持了零配置多语言与混说。
反观 Google:
2017 年,Google 发明了奠定整个大模型盛世的 Transformer;
Google 拥有数十亿人每天都在使用的 Google Translate;
拥有工业级语音霸主 WaveNet、Tacotron,以及 2023 年就发布的涵盖 1000+ 种语言的超级通用语音大模型 USM(Universal Speech Model)。
坐拥全天下最奢华的语音与自然语言处理资产,为什么在这个基础交互体验上,Google 反而被 OpenAI 压制了整整三年?
这并不是一个单纯的技术能力问题,而是技术史与商业史上屡见不鲜的“创新者的窘境”与超大型组织演化摩擦。
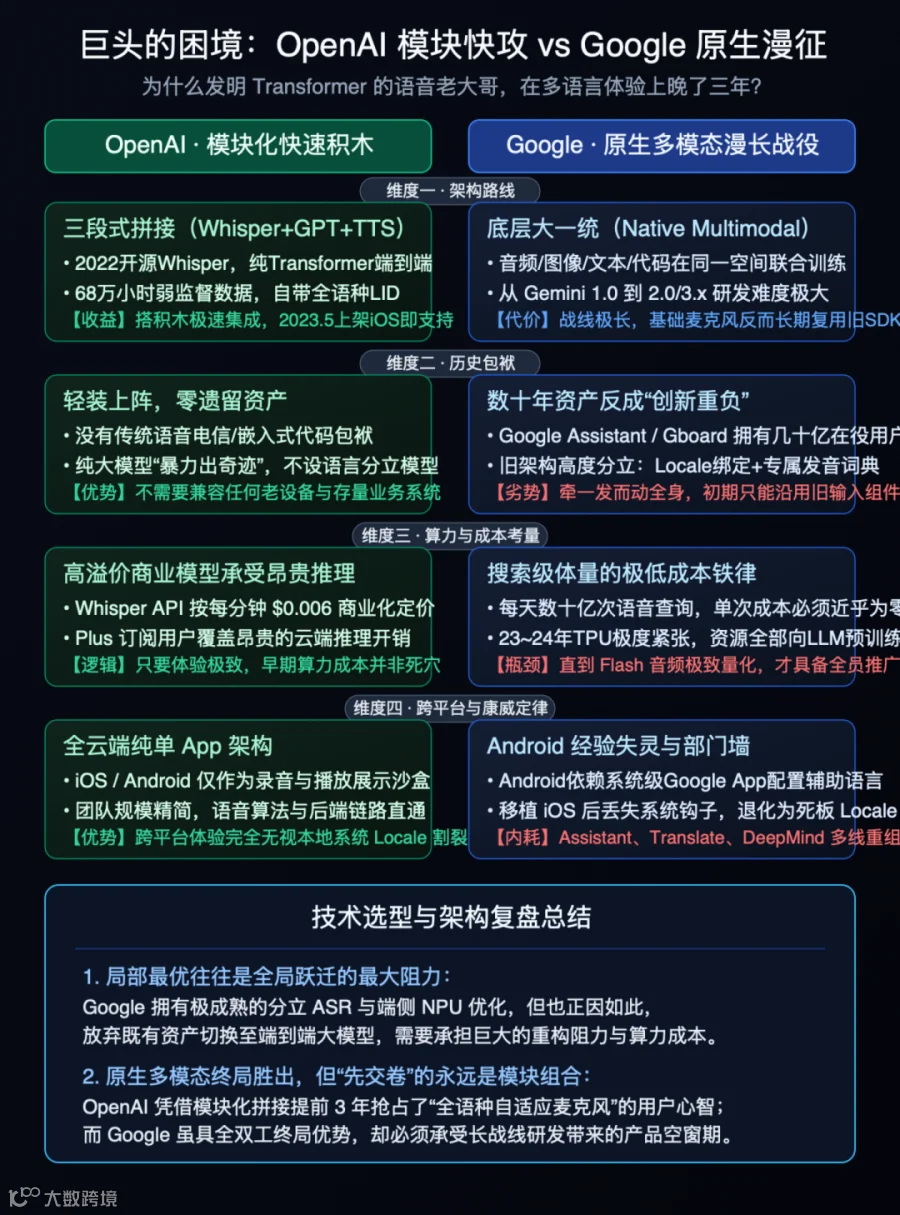
OpenAI 模块化搭积木 vs Google 原生多模态大一统
1. 历史资产成了“沉重包袱”:传统工程架构的路径依赖
Google 拥有全球规模最庞大、运转最精密的语音基础设施:Android 系统底层语音框架、Gboard 输入法、Google Assistant。
这套基础设施经过十余年的极限打磨,已经达到了在特定单语言下的极致最优:
它能在 Pixel 等手机的端侧 NPU/DSP 芯片上完全离线高速运行;
它的识别延迟低至几十毫秒,功耗极低;
它支持极其精细的发音矫正与本地联系人匹配。
但这种高度工程化、模块化分立的旧架构,天然与“系统语言参数”死死绑定在一起。当 Gemini 急需在移动端上线抢夺市场时,最快速的工程选择不是另起炉灶重新写一套服务端自适应识别,而是直接复用既有的成熟语音 SDK。
这一复用,直接继承了旧 SDK 的所有遗传病:只要系统是英文,底层通道就顽固地走英文解码。
而 OpenAI 是一家没有任何电信工程包袱的初创公司。它没有在役的十亿台 Android 手机需要兼容,直接用海量多语言弱监督数据训练出了纯 Transformer 架构的 Whisper,端到端“暴力出奇迹”,天生具备零配置多语言能力。
2. 规模化算力经济学:搜索级请求下的推理成本红线
这是巨头与初创公司在商业现实上的巨大鸿沟。
传统级联 ASR 的单次推理成本微乎其微(甚至完全由端侧芯片消化,云端成本为零)。对于 Google 这样每天承载数十亿次语音请求的搜索引擎巨头,每一次点击麦克风的计算成本必须压到极致。
而 Whisper 或原生音频 Transformer 这种大模型,其参数量和计算复杂度相比传统 ASR 呈数量级暴增。
在 2023 到 2024 年大模型算力极度吃紧的周期中,OpenAI 能够通过每分钟 $0.006 的 Whisper API 收费,或者让每月 20 美元的 ChatGPT Plus 订阅用户去分摊昂贵的云端 GPU 开销;
但 Google 内部的 TPU 算力集群被严令优先保障 Gemini 核心基础语言模型的预训练与商业大客户推理。在语音输入这种高频基础功能上,如果盲目接入高昂的端到端音频大模型,服务器开销将是天文数字。
直到 Google 彻底完成了音频模型的极致蒸馏与轻量化量化(如 Gemini Flash 音频流式架构的成熟),单次请求成本被压缩到可接受的安全线以下,这项能力才终于获准全面覆盖全球亿级普通用户。
3. 跨平台生态摩擦:Android 的舒适区与 iOS 的沙盒折戟
在 Android 生态中,Google 拥有一整套系统级后门与管理组件。用户可以在 Google App 中独立配置“主语言”与“备用语言(Secondary Language)”,甚至可以通过系统级框架由后台服务协助语种仲裁。
然而,当 Gemini 登陆苹果的 iOS 生态时,它只是一款被严格限制在沙盒(Sandbox)内的普通第三方 App。
在缺乏 Android 系统级组件支持的情况下,既有的语音 SDK 直接失去了原有的环境钩子,退化为只能傻瓜式读取 iOS 系统的语言区域(Locale)。这一长期被忽视的跨平台适配盲区,在多语种用户社区中被诟病了数年之久。
4. 研发战略路线的根本分歧:模块拼装 vs 原生大一统
如果回顾两家公司的研发轨迹,会发现这是一场战术速度与战略终局的博弈:
OpenAI 的战术是“极速乐高拼装”:2023 年的 ChatGPT 语音模式,本质上是典型的“Whisper(ASR)+ GPT-4(LLM)+ 专用 TTS 模型”三段拼接。这种搭积木的方式工程周期极短、体验立竿见影,帮助 OpenAI 在极短时间内抢占了全球用户的语音心智。
Google 的战略是“原生多模态大一统(Native Multimodal)”:Google 从立项之初就笃信,模块级联只是过渡形态,真正的未来是原生全模态端到端模型。一个模型必须同时听懂音频频谱、看懂视频帧、理解代码并直接流式生成语音。
但构建真正的原生多模态大模型是一场漫长而艰难的苦旅。从 Gemini 1.0、1.5、2.0 到 3.x 体系,Google 经历了长达数年的端到端联合训练、长上下文扩展与全双工流式对齐攻坚。
直到这套宏大的原生音频体系彻底在服务端打通并成熟沉淀后,它所蕴含的技术红利才终于“自上而下”降维反哺到了 App 界面最不起眼的那颗麦克风按钮上。
5. 康威定律:多业务帝国的组织墙
任何系统的架构,往往是其组织沟通结构的映射。
在生成式 AI 爆发初期,Google 内部的语音与语言能力分散在数个彼此割裂的庞大帝国中:
语音交互归属于 Google Assistant 团队;
跨语言机器翻译归属于 Google Translate 团队;
手机操作系统输入法归属于 Android & Gboard 团队;
底层前沿多模态大模型归属于 Google DeepMind 团队。
部门之间的技术栈、代码库、部署标准与 KPI 考量各不相同。让一个既有的 Android 语音输入模块全面重构并接入 DeepMind 的最新音频大模型,在一家拥有数万名工程师的跨国巨头内部,需要跨越漫长的组织重组、利益协调与基础设施统一流程。
这场组织层面的“大兵团整合”,耗费的时间往往远超纯粹的技术算法研发。
五、 架构复盘与启示
当我们今天在 iOS 上自然地用中文对着纯英文界面的 Gemini 说话并得到流畅响应时,这颗麦克风背后所折射出的,是一段极具代表性的软件工程进化史:
局部最优往往是全局跃迁的最大阻力:Google 过去在传统 ASR 领域建立的技术壁垒与端侧工程优化太成功了,以至于这套极其坚固的旧体系反向推迟了新一代端到端大模型的落地进程。
产品竞争中,“先交卷”的往往是模块组合:OpenAI 凭借 Whisper 与 GPT-4 的敏捷拼装,在 2023 年赢得了整整三年的先发心智;而巨头在追求“底层大一统终局”的道路上,不得不忍受战线漫长带来的产品空窗期。
原生多模态终将抹平缝合怪的优势:尽管晚了三年,但当原生音频模型全面接管输入与输出后,它所展现出的上下文深度共现、中英混说消歧、甚至在 Gemini Live 中展现出的情绪与语调无损感知能力,正在证明端到端大一统路线在终局体验上的巨大潜力。
技术演进的魅力莫过于此:用户感受到的往往只是界面上少点了一次设置,而在屏幕下方,整座代码与算力构筑的数字冰山,已经悄然完成了一场历时数年的地壳隆升。