


先说一个行业里真实存在的岗位,叫前线部署工程师,Palantir 带火、后来被各家大模型公司抄过去的头衔。这活儿干的是,把一个很能打的通用模型,搬到某个具体客户那儿,现场改数据格式、接它的内部工作流、补一堆合规校验,最后让这套东西真的跑起来、还一直跑得动。这个岗位的存在本身说明了一件事,模型能力再强,离一个能用的系统中间还隔着厚厚一层工程,而这层工程今天基本靠人填。
字节 Seed 前几天挂出一份工作叫 HarnessDev,41 页。它想问的就是,这层工程,模型能不能自己动手搭,搭完还能不能持续改好。评测的日期是 9 月 1 日,跟之前那篇测自我改进的 S3Gym 是同一个系列的姊妹篇。
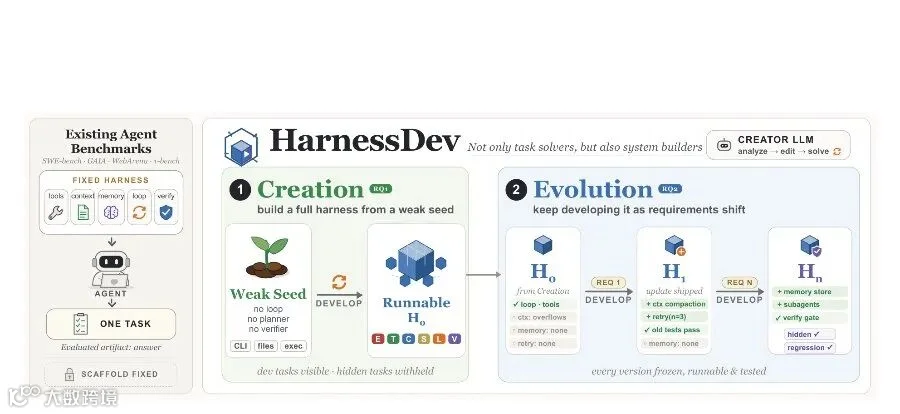
它把评测的对象换掉了
主流的 agent 评测,SWE-bench、GAIA、WebArena、τ-bench 这一串,套路都差不多,题目给死,奖励或者裁判给死,外面那套执行系统也提前搭好固定不动,然后让模型在里面解题,报一个任务成功率。这套设置做横向对比很干净,代价是把脚手架当成了实验配置的一部分,没人去量模型搭脚手架的能力。
HarnessDev 把要评的东西从「一次任务的答案」换成了「一套能跑的基础设施」。这里说的基础设施,就是套在大模型外面那一圈,怎么组织多轮循环、允许调哪些工具、上下文长了怎么压、任务状态存哪、什么时候该停、跑完的结果怎么验证。论文里还专门论证了一件事,改脚手架跟改一段普通代码根本是两回事。你改一个独立小程序,目标行为是外部定好的,改对改错当场能验。你改自己的脚手架,改的是自己观察、规划、出错后怎么恢复的那层底座,这一改动会渗进以后每一个任务。要改得好,模型得能从执行轨迹里认出自己的短板,得能诊断出这套系统结构上的瓶颈,还得敢下针对性的手,让改动攒成能复用的能力,而不是东补一块西凑一块。
两个阶段,和一个故意做弱的种子
Creation 阶段从零搭。每个模型拿到的起点是一个叫 Hseed 的东西,能跑,但刻意做得很空,它只负责解析任务、暴露几个被动工具、把日志和结果写到指定地方。执行循环、任务分解、工具策略这些它一概没有,上下文管理、持久状态、验证器、停止规则也全都空缺。原封不动用它去跑,任何基准上都是零分。
这个设计是整篇的地基,我觉得也最见功力。空仓库会把脚手架设计和命令行、文件格式那些杂事混在一起,一个成熟的现成 agent 又会把要考的规划和验证结构直接送分。Hseed 把搭环境的负担拿掉,同时不给任何解题策略。于是只要最后分数不是零,那一分就一定是模型自己加进去的执行逻辑挣来的,抄不了模板。

Evolution 阶段接着改。模型拿自己 Creation 搭出来的那套当起点,靠下游真实跑出来的反馈,一轮一轮往下迭代,目标是把成绩往上推,同时别把原来管用的改坏。
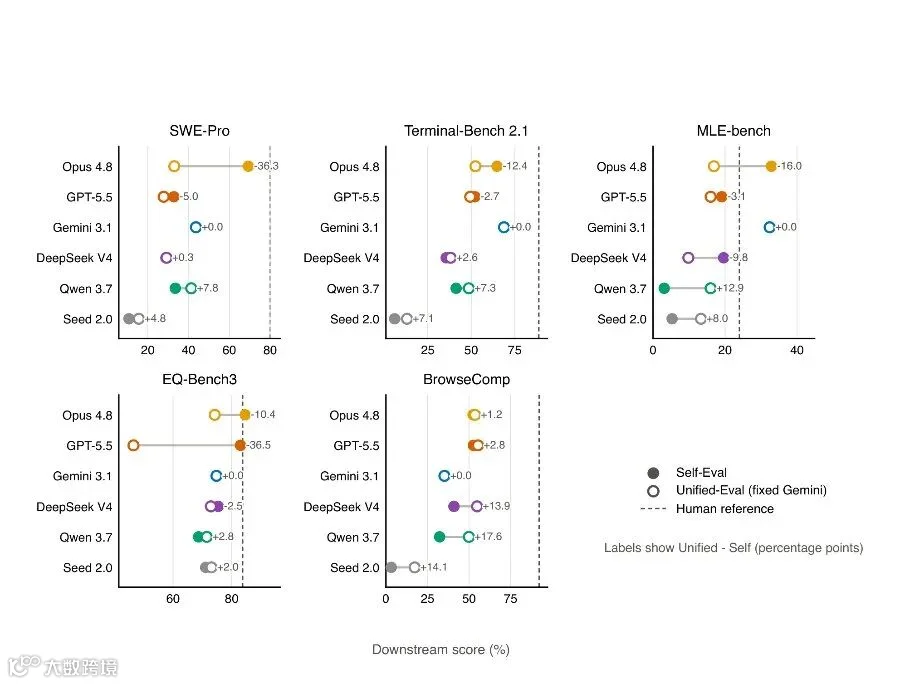
评测还有一条容易被忽略但很关键的分隔,搭脚手架的模型和跑任务的模型,是分开算的。一种模式让模型自己搭自己跑,另一种把所有搭出来的脚手架统一交给同一个执行模型跑。前一种能反映设计和执行者合不合拍,后一种才是脚手架本身的公平比较。
一套合格的脚手架要凑齐六个部件
论文把模型必须补出来的控制层拆成六块,执行循环、工具策略、上下文管理、状态与记忆、生命周期与恢复、结果验证。一个搭完的脚手架,得通过统一的审计格式吐出结果、轨迹、响应和运行日志,再按领域映射成裁判能读的最终产物,代码领域是仓库状态加补丁,数据领域是提交加指标,写作是给人看的正文,搜索是带引用的答案。

结果分领域看,差得离谱
六个当前主流模型当构建者,Opus 4.8、GPT-5.5、Gemini 3.1 Pro、DeepSeek V4 Pro、Qwen 3.7 Max,还有字节自己的 Seed 2.0 Pro。开发环境统一用 Claude Code,只有 GPT-5.5 用 Codex。任务铺了四个领域五个基准,两千两百多个实例。
自己搭自己跑的模式下,Opus 4.8 综合分最高,67.8,可人类精心做的参考系统是 86.2,还差着一截。分领域看差别极大,写作上 Opus 的 84.6 已经贴着人类那套 83.7,机器学习实验上它甚至做到 32.9,反超了 24.0 的人类参考。可搜索研究和写代码这两块差距最大,Opus 在 BrowseComp 上只有 52.4,人类参考是 92.2。
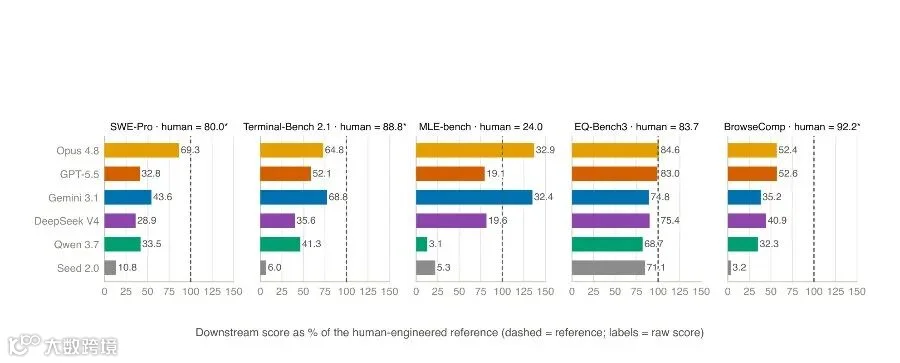
这里有个反常识,搭得复杂不等于搭得好。看代码量,Gemini 三个代码脚手架净加了一千行出头,是全场最少,可它的 Terminal-Bench 拿了 68.8,比谁都高。Opus 加了 2470 行,GPT-5.5 和 Qwen 都堆到三千五百多行,成绩反而没更好。论文的判断是,改动小而准、加上频繁验证,比堆代码量重要得多。
还有个数据值得记住,失败的 Data 任务里有 77.8% 被归因到脚手架本身的缺陷。也就是说卡脖子的往往不全是执行模型不够聪明,是那套外面搭的东西有洞。
通病,储物间造了却从没打开
把搭出来的脚手架拆开看,最一致的短板在状态和记忆。十八个代码脚手架里,十一个定义了 State 类,可真正带存盘接口的只有一个,做了定期检查点的也只有一个。翻遍两万六千多条执行轨迹,一次检查点事件都没触发。这就像装修时留了个储物间,结果谁也没进去过。
死代码也成片。一百零八个组件实例里,十八个在真实运行中从没被调用过,全集中在状态和记忆这块。验证大多停留在语法层面,两千三百多个数据任务的提交里,有 441 个是废的,没有一个脚手架把它检出来。论文还测了个直觉,自测写得多的脚手架是不是成绩更好,答案基本没有相关性,相关系数只有 0.13 到 0.26 还不显著;真正和分数挂钩的是修订次数,相关能到 0.57。有用的是那种读了失败、下了针对性改动、再端到端验证一遍的循环,光堆测试数量是自我安慰。
换个执行模型,很多脚手架立刻露馅。Opus 自己搭自己跑,代码任务 69.3,统一换成 Gemini 执行,一下掉到 33.0。查下去是它在脚手架里写死了一个一百二十步的上限,那是照着自己当执行者时的习惯调的,换个模型就水土不服。它搜索脚手架里重复查询的比例,换执行者后从 10.1% 飙到 88.2%。反过来 Qwen 换到 Gemini 执行,BrowseComp 涨 17.6,MLE 涨 12.9,说明它的脚手架本身不差,拖后腿的是自家执行模型。成本这边也挺野,机器学习任务的 token 消耗能差十九倍,但贵从来不保证好。
让它自己迭代改,改得动,但稳不住
Evolution 的结果我觉得比 Creation 更值得琢磨。五个模型在自己执行下,看得见的反馈分数都涨了,可一到从没给它们看过的留出任务,涨幅明显缩水。Opus 留出最好,也就 +4.44。一旦把执行者固定换成 Gemini,只剩 Opus 还在涨,另外三个反而退步,GPT-5.5 留出直接掉了 10.32。
它统计了六十四次版本切换,八次两个基准一起退,十六次单边退,同一个 commit 反复跑还能有正负 4.75 分的噪声。反馈分和留出分只有 53.1% 的时候同向变好,九个模型自己申报的最终版本里,恰好是留出最优的只有两个。这话翻译过来,可见反馈适合用来做局部搜索,拿来做最终选择不可靠,反复去优化一个带噪声的分数,很容易挑中一次运气好的运行,反而把过拟合放大。
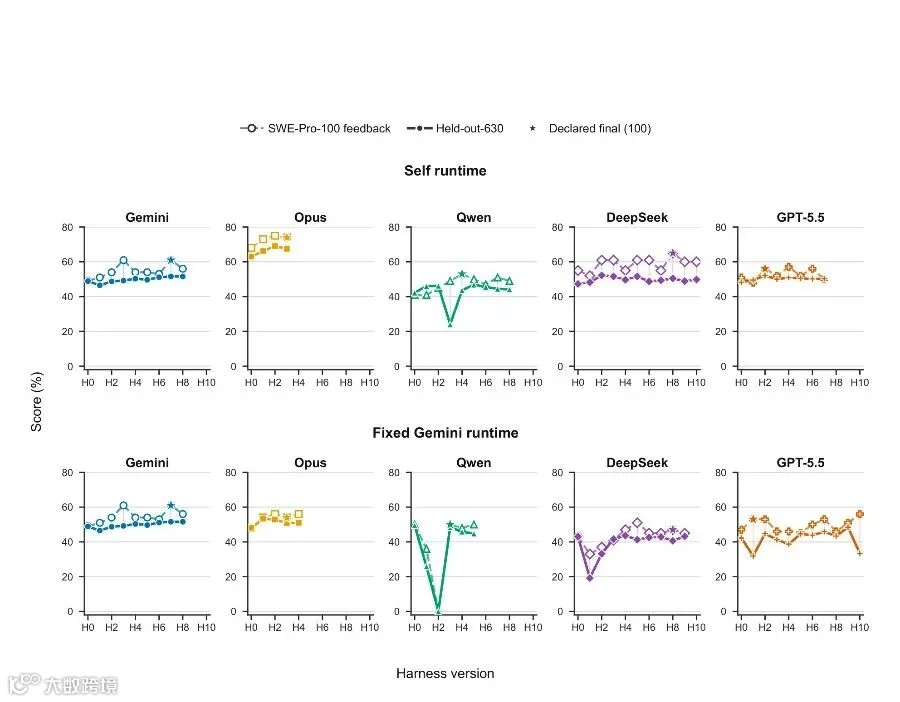
正面例子还是有的,而且很漂亮。Opus 发现一百次运行里有九十九次报告成功,可实际只有四十八次真通过,顺着这个差去查,定位到是任务还没做完就过早收工了,于是补了一道完成度检查。反馈只有在暴露出一个具体的失败模式、然后改动被端到端验证时,才真的起作用。
这篇最实在的贡献,是把「模型能不能当自己的部署工程师」这件挺虚的事,变成了一个能一项项量出来的对象。它没有停在喊口号,而是把构建者和执行者分开、把可见反馈和留出成绩分开、把能力和 token 成本分开,每一刀都切在容易作弊的地方。弱种子那个零分基线尤其干净,逼着分数只能来自模型自己加的执行力。
我给两个判断。第一,脚手架确实是智能积累的一个新地方。过去大家默认能力都存在模型权重里,这篇的结论提得很清楚,那套显式的、能审查、能测试、能复用的执行系统,是另一个可以靠失败和反馈不断变强的载体。第二,现在的瓶颈大概率在诊断,不在动手。模型能改文件、能加模块,可它读不懂自己为什么失败,六十四次切换里状态改动只有四次,没有一个去碰独立验证器,说明它更愿意在表层加东西,不太会往结构里下刀。
局限论文自己也摆得诚实。四个领域覆盖不了所有真实部署,人类基线参差也不保证最优,固定执行者能减少但消不掉模型和脚手架的耦合,进化每个格子只有一条轨迹,留出只测了 SWE-Pro,撑不起统计置信。最要紧的一句分寸,这篇测的是模型外部的学习,它没说自己搭脚手架这套能替代参数训练。
顺带交代下坐标,方便你判断它的分量。跟 Creation 最近的是 Meta-Agent Challenge,一个元智能体在沙箱里迭代编程,按受保护的留出测试打分;跟 Evolution 最贴的是 HarnessOpt-Bench 和 Evo-Bench,一个给 LLM 优化器配预算评候选,一个让模型改进共享的 CodeAct 种子;ADAS、AFlow 那条线更早,是在提示词、工作流、拓扑上做自动搜索。HarnessDev 的独特点在于把从零搭建和持续进化接成一条,还同时看自己跑和换人跑两种视角,外加执行成本。
如果哪天模型真能把这层脚手架的活儿接过去,最该被重新想一遍的,是我们到底愿不愿意,把系统怎么跑、怎么改、怎么验证这件事,交给一个还会犯 120 步写死这种错误的东西。模型有多强反倒得往后排。你觉得这层工程,多久之后会开始被模型自己接管?