

导读8 月 27 日,arXiv 上出现了两篇都来自 Google、主题都是 Agent Skill 的论文:WikiSkill 在执行经验和可执行技能之间插入一个持久 Wiki 层,让技能越进化越好;SKILL.state 把执行时的聊天记录换成显式状态机,让长任务的 token 开销从 O(T²) 降到 O(T)。它们出自两个零重叠的作者团队,并非配套发布,却恰好分别回答了 Skill 的"生产"与"消费"问题。本文按论文原文逐一核对机制与实验数字,并给出两篇共同的适用边界。
同一天两篇论文,但不是一套论文
先说清楚一件事:8 月 27 日挂上 arXiv 的这两篇论文,并不是一个团队协同发布的上下篇。
WikiSkill(arXiv:2608.27454)的六位作者是 Liyan Tang、Cyrus Rashtchian、Chun-Sung Ferng、Andrew Tomkins、Da-Cheng Juan 和 Tu Vu,前五位隶属 Google Research,第六位同时挂 Virginia Tech,目前还是 v1 预印本。SKILL.state(arXiv:2608.26263)的作者是 Sanket Badhe、Priyanka Tiwari 和 Jonghyun Chung,第一、三位在 Google,第二位在普渡大学,论文已经更新到 v3(9 月 2 日),arXiv 的 Comments 字段已标注 accepted at EMNLP,即被 EMNLP 收录。
两篇的分工确实可以拼成一个完整故事:WikiSkill 关心技能怎么生产——Agent 踩过的坑怎样沉淀成下次能用的能力;SKILL.state 关心技能怎么消费——一份技能在执行几百步的长任务时,怎样不被自己的对话历史拖垮。一个管学习,一个管执行。
别把反思当进化:Agent 真正“越用越强”,要补齐哪四个环节?
WikiSkill:在经验和技能之间插一层 Wiki
过去让 Agent"自我进化"的做法,大多是直接改技能本身:跑一批任务,看看哪里失败,让模型改写技能说明,下一轮接着跑。问题在于,指导改写的那些洞察——为什么失败、哪种策略有效——散落在每一轮的优化轨迹里,下一轮进化基本用不上,同一个坑会反复踩。
WikiSkill 的灵感来自 Karpathy 提出的 LLM Wiki 概念:把经验编译成持久的、可复利的知识。具体做法,是在原始经验和可执行技能之间,插进一个结构化的知识层 Wiki。工作区因此分成三层:原始执行轨迹、沉淀模式的 Wiki、以及真正被调用的技能。
每一轮迭代由四个角色完成。Inference Agent 带着当前技能在训练任务上实际执行一遍(rollout),注意它不能看 Wiki,保证被考核的是技能本身而不是答案库;Wiki Maintainer 对轨迹做根因分析,把失败模式和成功策略固化成 Wiki 里的 pattern 页面;Skill Proposer 读 Wiki 索引和技能影响追踪器,按需翻阅具体轨迹,提出原子化的技能更新;最后 Gating 机制在验证集上给候选技能打分,好了才收,差了回滚。
整套设计里最精妙的是一处不对称:技能可以回滚,Wiki 永不回滚。失败的提案连同拒绝理由也会留在 Wiki 里,下次 Proposer 能看到"这个方向试过、为什么不行"。道理很直白——技能是易错的假设,知识是沉淀的资产,资产不该因为一次假设失败而清零。
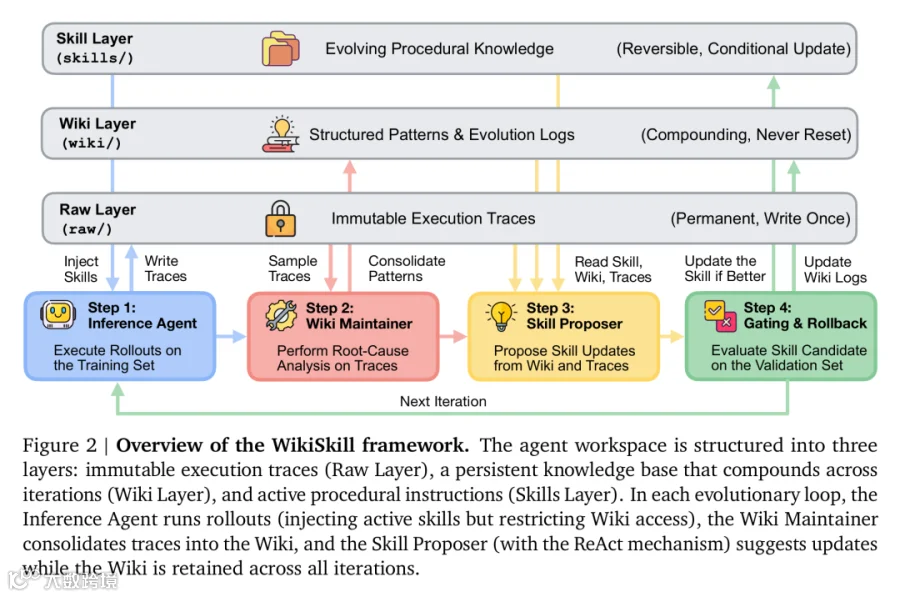 图片说明:Inference Agent 跑轨迹但看不到 Wiki,Maintainer 和 Proposer 才读写知识层 图片来源:WikiSkill 论文 arXiv 预印本
数据:越强的模型,越吃技能进化的红利
论文在 5 个模型 × 5 个基准上评测,任务覆盖数学推理、搜索问答、表格操作、长文档问答和具身交互 ALFWorld。按论文摘要给出的数字,WikiSkill 在 Qwen 4B、9B、27B 三个尺寸上分别带来 12.3、17.5、23.9 分的平均提升;对照 Table 1,五个模型相对各自无技能基线的平均增益约为 12.3、17.5、23.9、13.6、18.6 分,提升随模型尺寸放大。
两个反直觉的发现值得单独说。
第一,模型越大,从技能进化中获益越多,技能进化和单纯把模型做大是互补而不是替代关系。第二,技能可以让小模型越级打怪:9B 模型配上进化后的技能拿到 47.4% 的平均分,反超裸跑的 27B 模型(39.4%)——大约三倍的参数差距,被一份沉淀下来的技能抹平了。
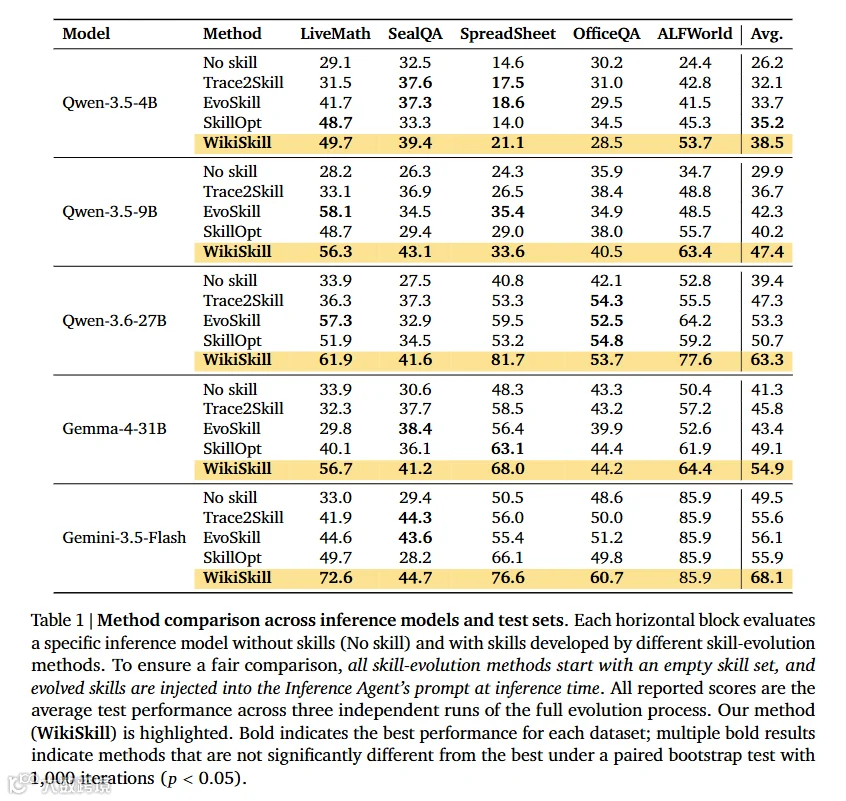 图片说明:五个模型在五个基准上的全面对比,提升随模型尺寸放大 图片来源:WikiSkill 论文 arXiv 预印本
论文还做了跨模型技能转移:27B 进化出的技能交给 9B 用,在 ALFWorld 上甚至比 9B 自己进化的还好用;但转移也会翻车——4B 在表格任务里沉淀的技能塞满了"单行 Python 命令"这类小模型专用补丁,交给更强的模型后反而把成绩从 50.5% 坑到 18.1%。结论是:通用程序性知识可以跨模型迁移,模型特异的 workaround 会负迁移。
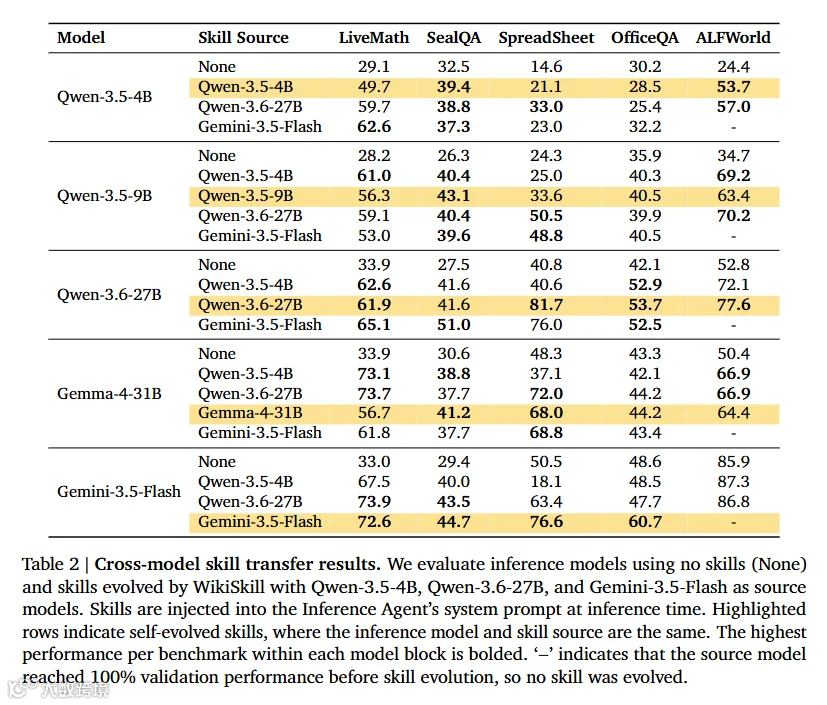 图片说明:大模型发现的技能可惠及小模型,但模型特异的补丁会反向拖累强模型 图片来源:WikiSkill 论文 arXiv 预印本
论文也交代了方法的边界:实验把技能直接注入提示词,技能检索与触发环节本身没有评测,而技能一多,这恰恰是关键问题;闸门只接受能立刻提分的提案,可能错杀短期中性、长期有用的更新;验证集规模较小,闸门判断本身带评测噪声(论文用三次独立运行加显著性检验缓解);Wiki 只增不删,缺少自动剪枝,长期膨胀的维护成本没有研究。小模型也并非处处受益:4B 在长文档问答 OfficeQA 上从 30.2% 轻微退化到 28.5%,因为它执行不了长文档里多步搜索的新流程。这些是把它搬进自己系统前要知道的缺口。
SKILL.state:把技能执行从聊天记录改成状态机
再看消费端。今天几乎所有 Agent 运行时都是一个模式:每一步都把原始技能说明加上不断膨胀的历史——推理、动作、观察、工具输出——整包塞给模型。执行到第 T 步,单步 prompt 是 O(T),所有步骤的累计 token 开销是 O(T²)。更麻烦的是过期观察赖在上下文里不走,模型得不断区分"现在的事实"和"历史的垃圾",论文称之为上下文中毒(context poisoning)。
SKILL.state 的做法是把执行重构为显式状态转移。每一步模型只收到三样东西:不可变的技能说明书 P、结构化的当前状态 Σt(JSON)、以及最新一条环境观察 ot。模型输出步内推理、状态补丁和动作;运行时确定性地校验补丁、合并进新状态,然后——把这一步的推理轨迹永久丢弃。步内的多步思考完全保留,但状态转移一经验证,推理就不进入下一步的 prompt。
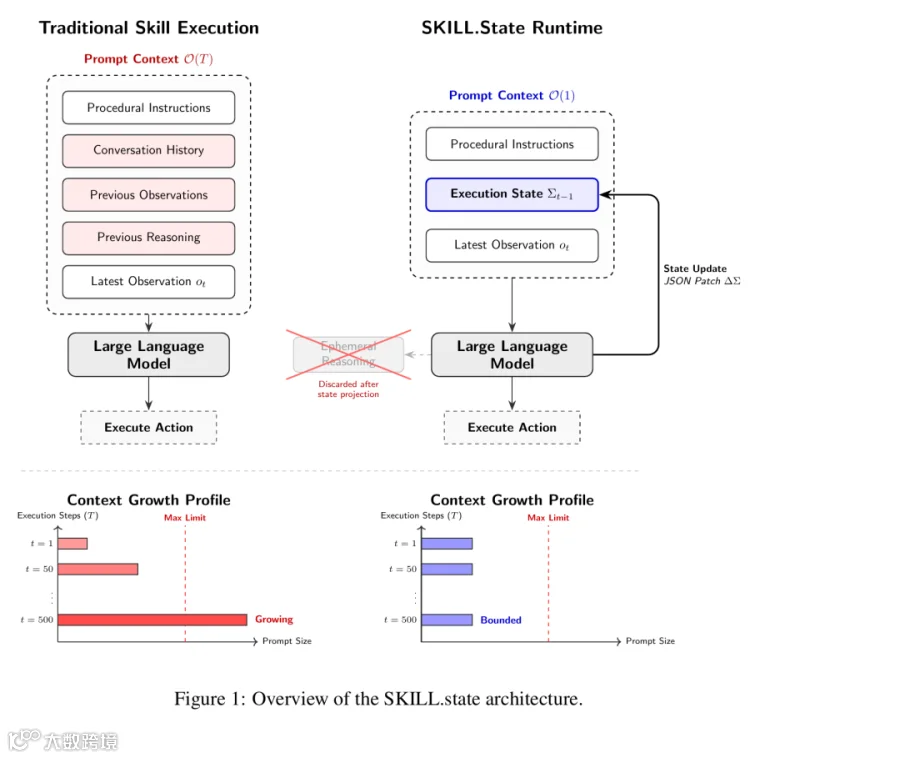 图片说明:推理轨迹在生成并验证状态补丁后即丢弃,只有状态持续传递 图片来源:SKILL.state 论文 arXiv 预印本
于是单步 prompt 恒定为 O(1),累计 token 降为 O(T)。状态 schema 按领域写一次就行,比如 InterCode CTF 的全部 100 道题共用同一个 5 字段 schema:已发现的 flag、已验证的假设、相关文件、工作目录、命令摘要。
16 倍省 token,而且更准
在自建的 SkillExecBench 仓库管理环境里(500 个货架,任务步数从 10 拉到 200),T=100 时持续维护状态的 LangGraph 基线累计烧掉约 106 万 token,SKILL.state 只用约 6.5 万——16.2 倍压缩,准确率反而更高(0.94 对 0.91;原始 ReAct 基线此时只有 0.84);它的每步 prompt 长度始终在 1736 到 1905 字符之间,一条平线。抗噪实验里,往观察中灌入每步最多 50 条遥测垃圾,标准 ReAct 的成绩从 0.68 崩到 0.53,SKILL.state 全程不低于 0.97——干扰信息在生成状态补丁时就被滤掉了。
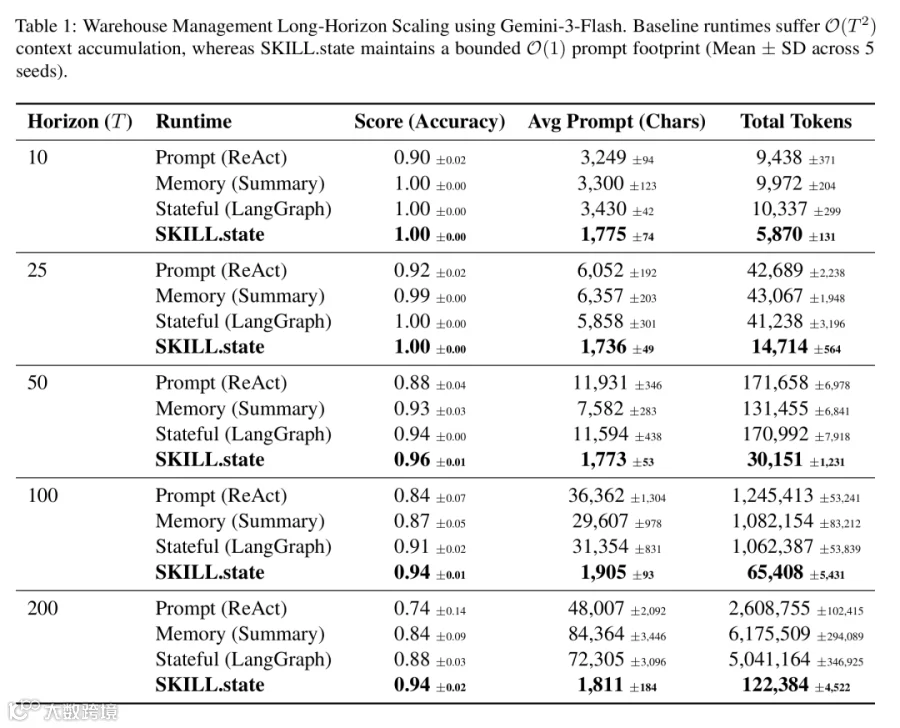 图片说明:基线 token 随步数二次膨胀,SKILL.state 保持线性且准确率更高 图片来源:SKILL.state 论文 arXiv 预印本
公开基准上,InterCode CTF 的 pass@1 达到 54.2%,比最强基线高 7.8 分,总 token 比 ReAct 省 60.4%;τ-Bench Retail 通过率 58.3% 且成本最低;τ-Bench Airline 中基线 prompt 峰值超过 1.1 万 token 一步,SKILL.state 平在约 2800,通过率 32.4%。
作者还预判了"你赢只是因为 prompt 短"这个质疑,把所有基线压到同样约 1800 字符的 prompt 预算重测:滑窗截断崩到 0.18,因为早期库存分配被踢出窗口;LLMLingua 压缩崩到 0.22,因为统计压缩把"看着冗余、实则关键"的货架 ID 删了;SKILL.state 是 0.94。赢的是结构化状态,不是短上下文。
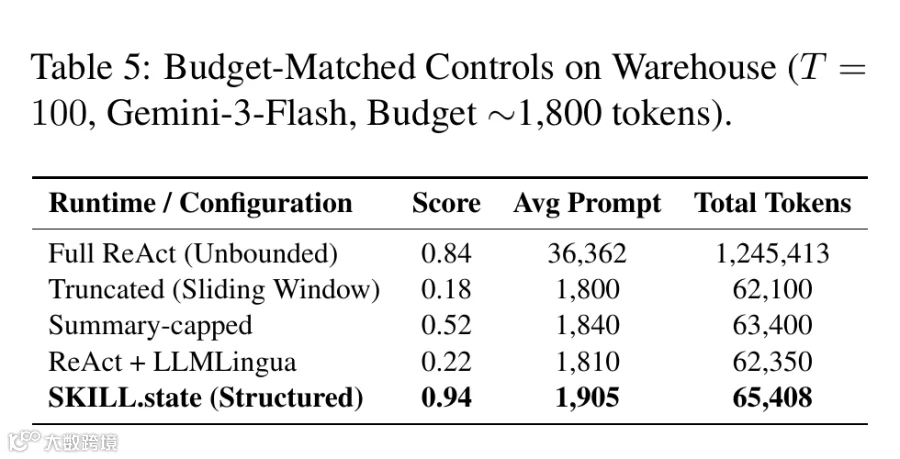 图片说明:同等 token 预算下,截断和压缩都失效,只有结构化状态保持 0.94 图片来源:SKILL.state 论文 arXiv 预印本
状态机的三个失效条件
论文对自己的前提说得很诚实:丢弃历史无损,要求状态是未来执行的"充分统计量"。这个前提在三种场景不成立:一是事先没有固定 schema,相关状态结构必须在执行中动态发现;二是正确决策依赖一条早期观察,而它的重要性当时没被识别、根本没写进状态;三是任务目标本身就是历史轨迹——审计、溯源、解释过去做过什么——这时历史不是开销,而是交付物。另外小模型输出格式补丁容易出错,需要配合语法约束解码。
合起来读:把隐式历史换成显式资产
两篇论文的技术对象完全不同,底层转向却是同一个:不要再让关键信息隐没在流水账式的文本里,而是把它提升为一等公民。WikiSkill 把跨轮次的经验提升为持久知识层,SKILL.state 把执行现场提升为结构化状态;前者规定知识只增不回滚,后者规定推理用完即弃。一个想留住一切有复利的东西,一个想扔掉一切该过期的东西,判断标准都是同一句问话:它对未来的执行有没有用。
对在做 Agent 的工程师,这两篇提供了可以直接搬走的设计:给自进化流程加一层只增不删、可检索的经验记录,并把技能提案放进独立验证集闸门;给长程运行时定义一份按领域复用的状态 schema,让模型每步输出状态补丁而不是复述历史。但搬之前先对照边界——任务没有稳定结构、关键信息要事后才能意识到、或者需要完整审计轨迹时,流水账仍然不可替代。
参考资料
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution(arXiv:2608.27454,2026-08-27): https://arxiv.org/abs/2608.27454
SKILL.state: Scalable Long-Horizon Agent Skills(arXiv:2608.26263,v1 2026-08-27,v3 2026-09-02,Comments 标注 accepted at EMNLP): https://arxiv.org/abs/2608.26263
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!