在 CI/CD 执行完测试后,我们发现报告中有几个用例失败。
接下来,我们按照惯例打开报告,查看 trace,进行调试,并对照代码进行分析。此时,是时候引入 AI 来处理这些任务了。
本文将带大家完成利用 AI 自动定位问题甚至自动修复的 Skill,包括以下功能:
-
解析 trace、HTML 快照和日志,利用 AI 定位失败的根本原因并提供修复建议
-
对失败原因进行自动分类:包括真正的 Bug、Flaky 测试和数据问题,以便进行分流处理
-
输出结构化的根因报告,置信度一目了然,避免依赖猜测
-
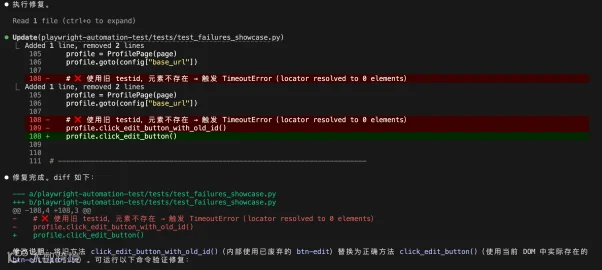
对于高置信度且可修复的问题,自动执行修复,形成闭环
Playwright 官方推出了 Healer Agent,能够自动修复失败的测试,听起来确实不错。然而,实际使用中存在几个明显的局限性:
-
语言绑定:官方 Agent 基于 TypeScript,Python 测试框架无法使用
-
一刀切:无法理解自定义的框架模式、命名约定或项目特定的最佳实践
-
黑盒逻辑:用户无法控制修复逻辑,也无法根据具体需求进行定制
从零构建:专属 Python Playwright 故障分析 Skill
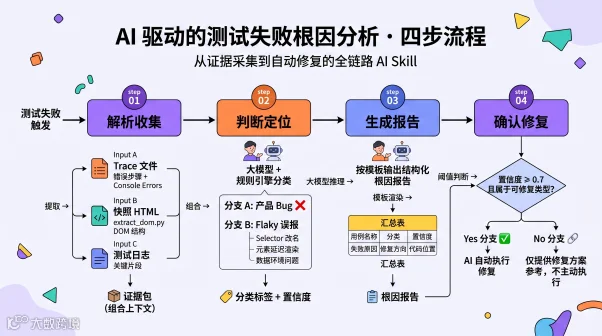
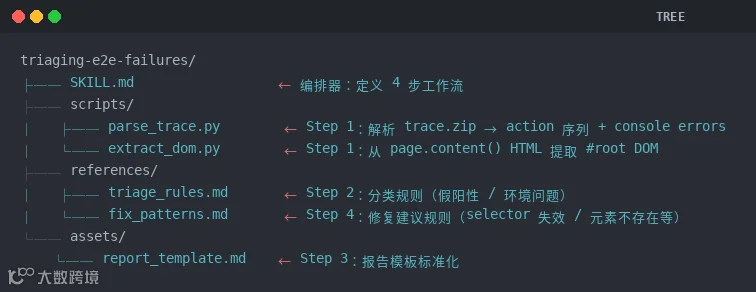
基于上述几个痛点,我决定构建一个适用于 Python Playwright 的 Skill。Skill 分为四个步骤:
我的测试框架在测试失败后会自动生成三种失败证据:trace 文件、失败时的快照 HTML 文件和测试日志,因此我使用 Python 脚本从 trace 文件中提取步骤和控制台信息。
同时从快照 HTML 中提取 Body 或 id="root" 的 div HTML 代码,最后从日志中截取相关的段落。
收集完证据后,大模型根据定义好的规则进行判断分类。比如判断是否是真实的产品 Bug,还是 Flaky 测试误报;如果是 Flaky 的测试,是由于 selector 改名、元素延迟渲染,还是数据环境问题。
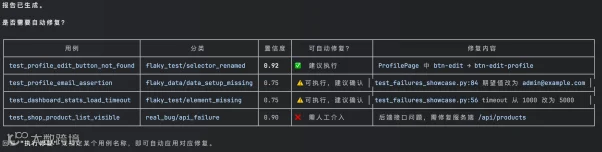
大模型根据分类结论,按模板输出结构化的根因报告。报告以汇总表形式展示所有失败用例的分类、置信度、失败原因、修复方向和代码位置,让排查工作一目了然。
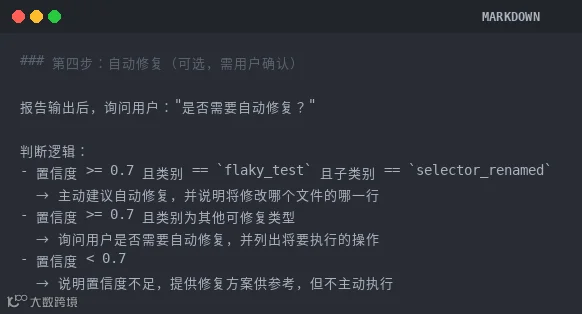
报告输出后,根据置信度判断是否需要 AI 进行自动修复。我的规则是:当置信度 ≥ 0.7 且属于可修复类型时,AI 可以自动执行修复;如果置信度不足,则仅提供修复方案供参考,不主动执行修复。
获取完整源码:完整的 Skill 已上传至 https://github.com/bridgeshi85/playwright-pytest-allure-framework,可自行获取
我的初步设想是仅通过解析 trace 文件来进行问题定位。
但经过尝试后,我发现 trace 仅记录了 Playwright 层面的 API 操作,并不包含 pytest 中 assert 断言失败的具体细节。
所以当断言导致测试失败时,大模型可能无法准确定位问题——因为导致失败的原因不在 trace 中。
所以,我想到在测试失败时框架已经提供了日志和页面 HTML 快照,这也是我手动排查问题时的参考,一起提供给大模型信息才算完整:trace 告诉 AI 测试做了什么操作,HTML 快照告诉 AI 失败时页面上有哪些元素,而日志可以提供断言的内容以及其他额外的信息。
1. 查找所有 trace 和失败时的快照 HTML
查找出 traces 和 screenshots 目录下的所有文件,若指定范围则按范围过滤。
找到 trace 文件后,通过 Python 脚本对每个 trace 文件进行解析,提取最后 10 个 action 以及浏览器 console 的错误日志。
同样通过 Python 脚本对测试失败时的快照 HTML 进行处理:如果有 id="root" 的 div 就提取该 div 下的节点,没有就提取 body 部分。
我的测试框架的日志文件路径为 output/logs/test.log——记录了所有用例的连续日志。此外,日志中会在每个测试用例的开始和结束时打印标记,以便 AI 根据用例名称截取相应的日志片段。
在获得测试失败的信息后,需要对失败原因进行分类分析。这一步的核心目的是将报错信息转化为结构化的结论,主要包含:
-
精准分流:不同类别的失败,后续的处理方式可能完全不同。只有明确了分类,才能实现真正的自动化闭环。例如,flaky_test/selector_renamed 可以进行自动修复;而 real_bug/api_failure 则应自动流转到缺陷管理系统指派给后端。
-
约束 AI 幻觉:通过预定义分类树(如 flaky_test、real_bug、flaky_data),我们给 LLM 提供了一个有限的“决策菜单”。这能有效防止 AI 臆造出不存在的原因,确保它的推理始终收敛在我们可控的业务范畴内。
-
沉淀团队知识:分类规则本质上是团队过往排查经验的固化。每一次新增的 sub_category,其实都是对系统已知故障模式的补充,让 AI 的判断随着项目演进越来越精准。
API 失败 → real_bug(api_failure)
这是最容易判断的,遇到接口出错时,基本 90% 以上是和测试脚本无关。
定位方式已过期 → flaky_test(selector_renamed)
这类是经常遇到的也是最适合 AI 辅助的场景之一,同时也是需要将失败时的 HTML 快照文件交给 AI 的原因之一。
元素不存在 → flaky_test(element_missing)
这类情况和定位方式很类似,但是原因可能有几种:功能已从页面删除、测试导航到了错误的页面、页面延迟导致元素未加载。
由于测试数据不一致导致的误报也非常常见。典型证据包括后端返回 404、数量断言失败(expected 3 items, got 2)、包含特定内容的元素不存在等。
这些无法判断的情况统一放到这里兜底,后续需要人工处理。如果后续整理出新的规则,则继续添加到 triage_rules 中。
经过前两步,每个失败用例已经有了错误类型的判断。这一步的任务是把所有结果按统一模板汇总成一份可读的报告——而不是把原始日志丢给开发者自己翻。
报告分两层:汇总表和逐条详情。汇总表每行对应一个失败用例,包含分类、置信度、失败原因、修复方向和代码位置,扫一眼就能判断哪些是 selector 改名(可以立即修)、哪些是真实 Bug(需要提单)、哪些置信度不足需要人工介入。逐条详情则展开每个用例的关键证据和具体修复操作,供需要深入排查时参考。
在汇总报告生成后,AI 会询问是否进行修复。具体规则如下:
-
对于置信度高于 0.7 且属于选择器错误的类型,标记为高优先级。这表明 AI 已基本判断出脚本的问题,具备直接修复的条件。
-
对于置信度在 0.7 以上但为其他类型的情况,视为建议修复,此时需仔细阅读并判断是否需要手动介入。
-
对于置信度低于 0.7 的情况,不进行辅助修复以避免引入混乱。
随着人工智能技术的持续进步,开发节奏已达到前所未有的快速,自动化测试也必须跟上这一步伐。因此,利用 AI 编写自动化测试已成为一种必要手段。然而,AI 的应用也带来了新的挑战——虽然写得快,但稳定性不足。
引入此技能后,可以在本地开发阶段及时定位并修复问题。后续可将该 Skill 以 Agent 的形式集成到 CI/CD 流程中,实现开发代码提交 → 自动测试 → 自我修复及再次测试的循环。
声明:本文为51Testing软件测试网 TestCraft 用户投稿内容,该用户投稿时已经承诺独立承担涉及知识产权的相关法律责任,并且已经向51Testing承诺此文并无抄袭内容。发布本文的用途仅仅为学习交流,不做任何商用,未经授权请勿转载,否则作者和51Testing有权追究责任。如果您发现本公众号中有涉嫌抄袭的内容,欢迎发送邮件至:editor@51testing.com进行举报,并提供相关证据,一经查实,将立刻删除涉嫌侵权内容。