如果你在2023年跟别人聊“做一个AI Agent”,大概率指的是用LangChain拼一个能调用几个工具的ChatGPT应用。但到了2026年,情况变了:钉钉发布了“AgentOS”,讲的是“数字员工+工作操作系统”;科大讯飞发布了“玲珑Agent OS”;华为在鲲鹏昇腾大会上宣布要“以昇腾算力为底座、以AgentOS为核心操作系统”;面壁智能联合清华THUNLP实验室开源了PilotDeck;神州信息联合多家金融机构发布了《金融领域基于可信框架的AgentOS智能体业务承载与治理》报告。
这不是巧合,也不只是营销话术的升级。它反映了一个真实的工程判断:当你试图让AI Agent真正在生产环境里干活,而不是在Demo里演示,你会撞上一堆和“调Prompt”完全无关的系统性问题。而这些问题,恰好和四十年前操作系统要解决的问题——如何管理多个并发运行的程序、如何分配有限资源、如何隔离故障、如何保证安全——高度同构。于是“AgentOS”这个名字自然而然地被借用了过来。
理解AgentOS,最好的方式不是去背一个定义,而是先理解它要解决的具体痛点,再看它是怎么一步步搭出一套系统架构来应对这些痛点的。
AgentOS到底是什么:把大模型的能力还给系统去管理
用最朴素的话说:
AgentOS是一整套让AIAgent能够安全、可控、可协作、可持续地运行起来的基础设施,它把大模型(LLM)作为核心的"推理引擎"或者说"认知内核",然后在它周围搭建起资源调度、记忆管理、工具治理、安全护栏、多智能体编排等一整套系统能力。
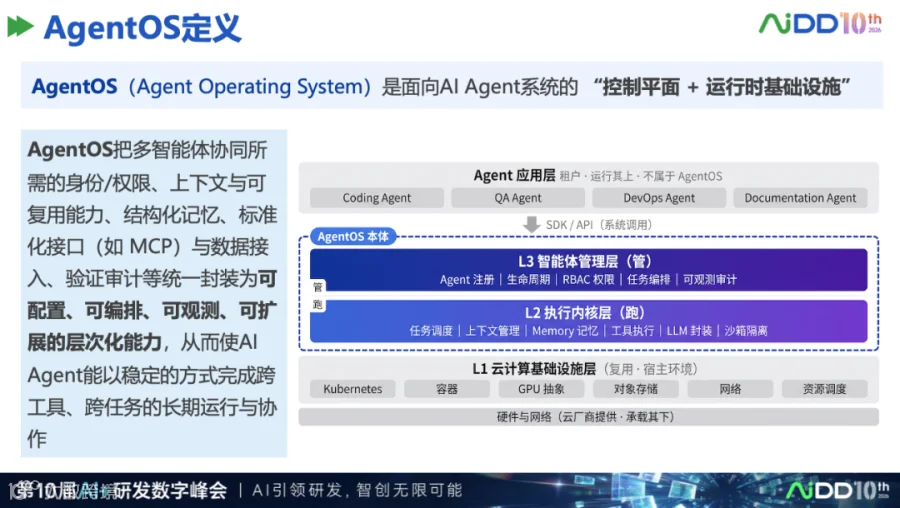
(我在第10届AiDD峰会上《未来每一个企业都需要构建或部署AgentOS》演讲材料摘取)
Rutgers大学团队在2024年发表的AIOS论文(已被COLM2025正式接收)里提出了一个很有洞察力的类比:正如传统操作系统的内核负责仲裁CPU、内存、存储的访问一样,LLM内核仲裁的是对推理能力、上下文窗口、外部工具和持久化内存的访问。这个类比之所以重要,是因为它指出了一个关键转变:AgentOS关心的不再是"硬件资源怎么分配",而是"认知资源怎么分配"。
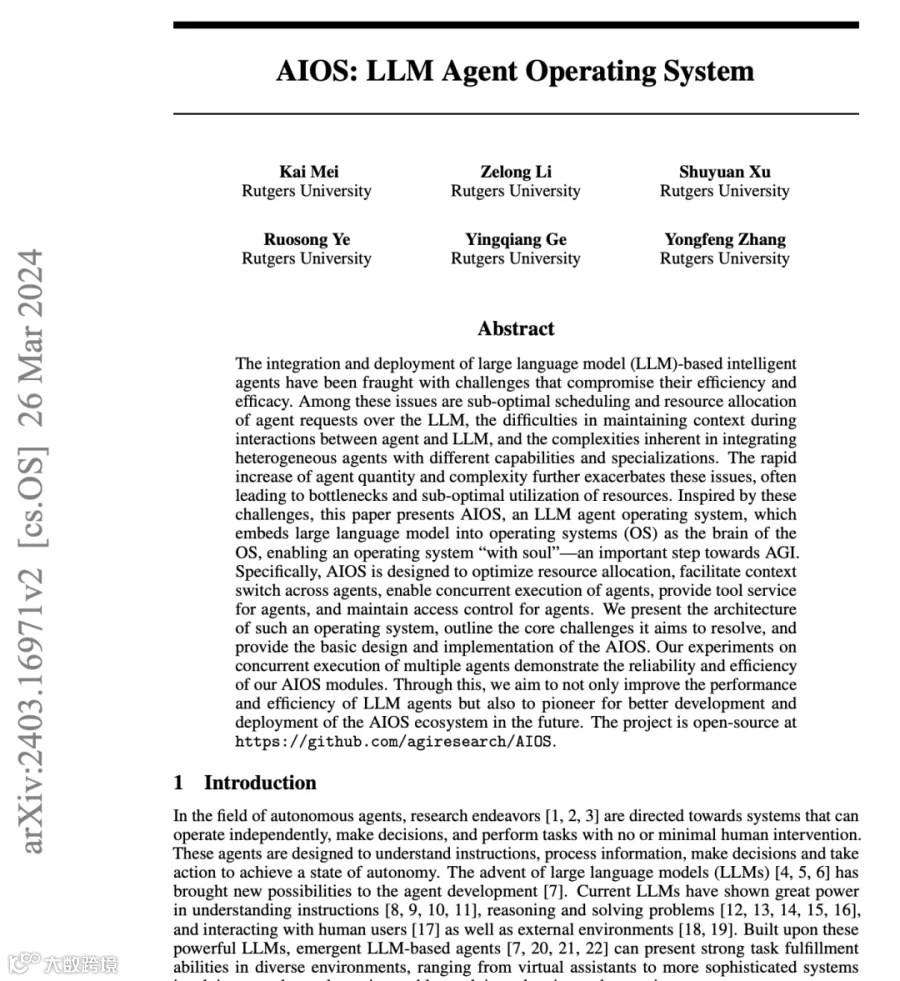
这个映射关系可以列成一张对照表,能帮你迅速建立直觉:

这张表非常关键,因为它解释了为什么"上下文窗口"在Agent系统里会被反复提起——它就相当于传统计算机里那块宝贵的RAM,容量有限,用满了就要"换页"(也就是把旧信息移到外部存储里)。
值得强调的一点是:AgentOS不是要取代大模型,而是要把大模型组织起来。agentOS.md中有一句话点明了这个关系:"Agent= BaseModels +AgentOS"。也就是说,单独一个GPT-4或Claude调用只是一次"推理",而当你把它嵌入到有记忆、有工具、有权限、有编排逻辑的系统里,它才真正成为一个能持续行动的Agent。我们有另一个公式:Agent =Model +Harness,从这个角度看:AgentOS=Harness。
内核循环:四步走完一次"思考—行动"
如果说整个 AgentOS 是一台机器,那么内核循环就是它的心脏——Agent 每"动一次脑子、干一件事",都要完整地走一遍这个循环。它被设计成三个特性:可重入(同一时刻能处理多个回合)、可挂起(随时暂停等审批)、可重放(事后能原样重现)。
一个循环由四步构成,每一步都配一道"安检门"(Gate)。
第一步:装配(Assemble)——把料备齐,但不能塞太多。模型能看的上下文是有限的,但 Agent 攒下的历史、记忆、工具却近乎无限。装配要做的,就是把无限的信息压缩成"本次够用"的有限上下文。这里有一条铁律:先注入、后裁剪——先把工作记忆、过往经验、人格设定、告警信息都注入进来,再统一做滑动窗口、token 预算之类的裁剪。顺序不能反:只有先看到完整候选,裁剪器才知道该舍什么、留什么。门禁一(注入与裁剪防护):检查外部检索回来的内容有没有夹带"提示词注入"攻击,给它降权隔离;预估本次 token 是否超预算,超了就直接熔断不发起调用;同时只暴露本阶段用得上的工具,别把无关工具的说明也塞满上下文。
第二步:推理(Infer)——让模型想。通过统一的模型客户端去调用大模型,产出文本、工具调用指令或结构化结果。这一步的关键不在"调用",而在"检查输出"。门禁二(输出结构校验):先做格式校验,格式不对就在内核内部把错误信息回灌给模型、自动重试,而不是把异常抛给上层;再做强制的依据性检查——模型的关键结论有没有检索证据撑腰,没有就标记低置信;声称的引用必须真的存在于检索结果里。
第三步:执行(Act)——把模型想做的事做掉。这一步会并行执行多个工具调用,然后把结果汇总回灌给模型。可控性的关键在工具分级:
-
只读工具(查一下数据):直接放行,只记账; -
幂等写工具(能重复执行、可回滚):过策略判定 + 留审计; -
关键动作工具(删除、发版、转账、合并主干这类不可逆操作):强制挂起,等人来批。
门禁三(工具权限与沙箱):每个工具都要带一份"契约",声明它的危险等级、可回滚性、权限范围、超时、限流、是否必须沙箱、什么情况下必须审批。执行模型生成的任意代码,必须显式指定隔离后端(微虚拟机、WebAssembly、容器等),不许裸跑在本机;shell 类工具默认本地,但必须绑定命令白名单。
第四步:提交(Commit)——让副作用真正生效前,最后过一道闸。门禁四(副作用提交审批):副作用在落地前必须经控制面判定。若命中"关键动作"或"低置信"条件,内核不是傻等,而是挂起当前执行上下文,等人机协同门禁给出裁决后再恢复。因为状态已经持久化,审批等上几天也不占资源、不怕重启丢进度。
一句话记住内核循环:先备料、再思考、后动手、最后才落账,每一步都有一道安检门兜底。
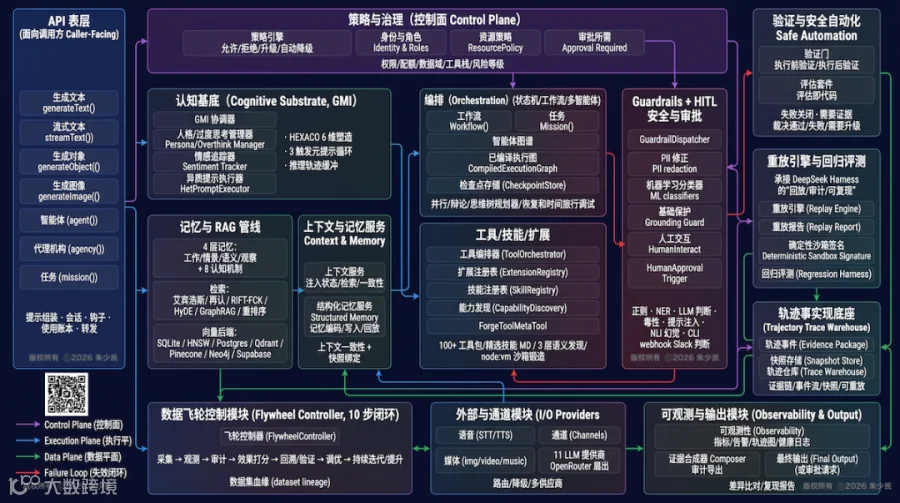
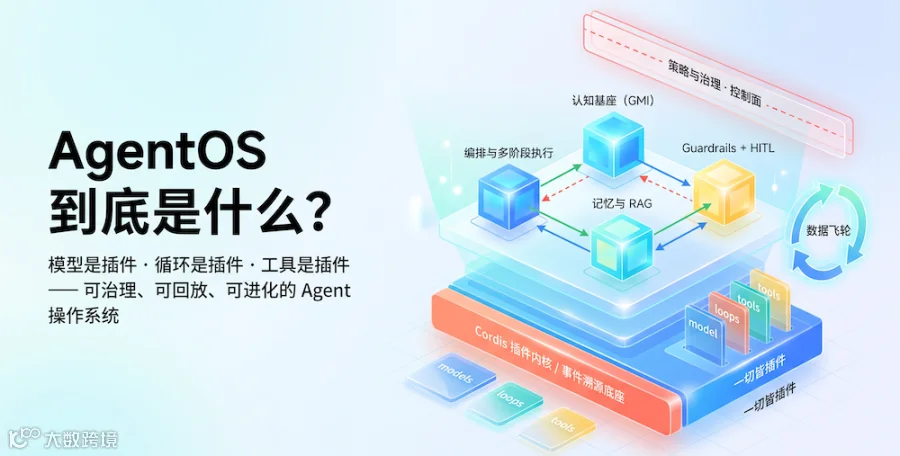
(AgentOS架构图,版权所有 ©️2026 朱少民)
四个内核服务
内核循环要顺畅运转,背后有四个"后勤部门"在支撑。
1 语义记忆管理——管住"记什么、忘什么"
很多人把大模型的上下文窗口当"内存",其实更准确的比喻是:它是每次调用都要重新装载的一组寄存器。所以记忆管理的难点不是"存得下",而是在有限的窗口里,把此刻最该看的东西摆进去。
为此采用三级存储:L1 活跃上下文(本次直接喂给模型的内容)、L2 会话记忆(工作记忆文件,任务状态、中间结论,靠压缩和聚合瘦身)、L3 长期存储(向量库/图库里的情节记忆与领域知识,按需检索取回)。
这里有三件必须做对的事:
-
回放安全:任何压缩、裁剪、聚合之后,剩下的事件区间必须能被模型独立重放——不能"删了工具调用、却留下工具结果"。这是记忆管理的正确性底线,压缩完要自动校验一遍。 -
别把三个问题混为一谈:内存不够了要换出(LRU 淘汰)、窗口放不下了要分层(主上下文 vs 外部上下文)、按用途要分类(工作/情节/语义/观察记忆)。三者是并存的可插拔策略,不是一个名词。 -
工具渐进披露:别一次把上百个工具的说明全塞进去,而是"列清单 → 按需加载 → 执行脚本",批量数据在沙箱里过滤聚合后只回传摘要。
2 调度器——协调一群 Agent 抢资源
多个 Agent 并发跑,调度器负责:控制并发上限(背压,而不是放任队列爆炸)、排优先级(交互式回合 > 后台批任务 > 压缩聚合这类内务)、模型降级路由(主模型限流就自动切备用、简单任务用小模型)、成本感知(按难度选模型档位)。
要诚实说一句:在本地单卡、多 Agent 抢显存的场景下,集中调度能带来可测量的提速;但在云 API场景,服务端是黑盒,调度只能管自己这侧的并发与降级,管不到服务端。这两件事不能混为一谈。
3 事件总线——让每一次动作都有据可查
一条硬规矩:Agent 内部禁止组件之间点对点直接调用,所有交互都必须走不可变的类型化事件流。原因很简单——如果组件互相直调,系统就"黑"了,没法追踪、没法回放。
事件带两个标记:是否参与历史重建(回溯只认这个键)、是否持久化(心跳这类瞬态事件不落盘)。而单一用量账本尤其重要:所有消耗 token 的地方(主循环、子任务、压缩、聚合)都必须在花费那一刻记一笔账,汇总只读这些账。否则子任务和压缩会被重复计数,成本就不可信,熔断也就失灵了。
4 持久状态机——长任务崩了也不怕
Agent 任务动辄跑几小时甚至几天,最怕的就是中途崩溃、全盘重跑。持久状态机靠四件武器解决:
-
写前日志(WAL):状态变更先写日志再改内存,日志就是恢复的事实来源; -
检查点:每个阶段边界自动落盘,重启从最近检查点续跑; -
时间旅行调试:回退到任意检查点重新推演,找出"从哪一步开始错"; -
确定性回放:记录 Prompt、随机种子、工具返回值与环境快照,离线重现。
这里也要诚实:模型在非确定采样下做不到比特级精确复现,所以"回放"应理解为轨迹与状态的完整重建,用于调试和审计是可靠的,但不能拿来断言"完全一致"。而人机审批之所以能等上几天,正是因为有这套持久化兜底——挂起 = 存好状态、等外部信号唤醒。
控制平面:把"可控"制度化
为什么要单独设一个带外的控制平面?因为治理逻辑一旦写进业务代码,就会升级不了、审计不了、早晚被绕过。正确的做法是:治理作为系统能力独立存在,以策略快照的形式下发给内核门禁本地判定,热路径不被拖累。
控制平面有四个部件:
-
策略引擎:声明式规则,维度是"谁(Agent 身份)× 做什么(工具危险级)× 动哪里(资源范围)× 在哪里(模块层级)× 有多确定(置信度)"。 -
身份与权限:每个 Agent 都有可验证身份,从构建期贯穿到运行期,权限压到字段级、资源级、动作级的最小范围。 -
预算与熔断:按回合/任务/租户/天分级设预算,token 超限、循环检测、错误率超标就发"停止事件"。 -
人机协同门禁(HITL):不止"批准/驳回"两个按钮,而是四态——批准(放行)、驳回(终止并记录原因进评测集)、修订(收下结构化反馈,注入上下文后只重跑指定阶段,不用从头再来)、升级(转给更高级的人或更强的模型)。
什么时候触发人工?看两个因子:工具是不是"关键动作"、模块是不是"核心",以及置信度够不够。注意,这里的置信度不采信模型的自述,而是由"审核结论 + 测试通过率 + 结构校验 + 影响面风险 +(可选)多模型投票"综合出来的。
观测平面与自主改进闭环
这是"看得见"和"会进步"两个能力的共同载体。
先说可观察。四件套:分布式链路追踪(完整调用链,核心引擎保持零依赖、配了才加载)、用量账本(成本归因)、确定性回放(轨迹重建)、评测引擎("先产出、后评分":捕获轨迹 → 重建成只读轨迹 → 评分器打分)。一条诚实原则贯穿始终:能说清就说清,说不清就报"未知",绝不瞎猜——可观测性宁可诚实缺失,也不可虚假完整。
再说可自主改进。这不是"让 Agent 随便改自己的提示词",而是一条受治理约束的闭环:
运行 → 留轨迹 → 评分与失败归因 → 生成改进建议 → 受控回写 → 再运行验证;不达标就回滚、重新归因。
闭环的起点是失败归因分类法——每类失败必须落到可行动的分类上(需求误解 / 计划错误 / 上下文缺失 / 工具缺失 / 工具执行失败 / 格式错误 / 无依据幻觉 / 验证不足 / 预算耗尽),而不是笼统一句"失败了"。改进对象分等级,越往下越要人把关:评测用例集(失败案例自动入库,全自动)、策略阈值(半自动,需审批)、装配配置(半自动,需 A/B 验证)、工具/技能(需审核 + 沙箱验证)、系统提示/人格(严格人工审批)。
自主改进必须守住三条底线:改进本身也要过同样的门禁(否则改进过程就成了新攻击面)、一切改进可回滚可对比(不劣化才保留)、行为修改必须人工复核(防止用错误的方式去"修"错误)。
多智能体协作:外围可插拔,不是独立层
多个 Agent 协作,本质就是"几个内核循环 + 一个通信结构",所以它不该做成独立的一层,而是内核之上的可插拔子系统。
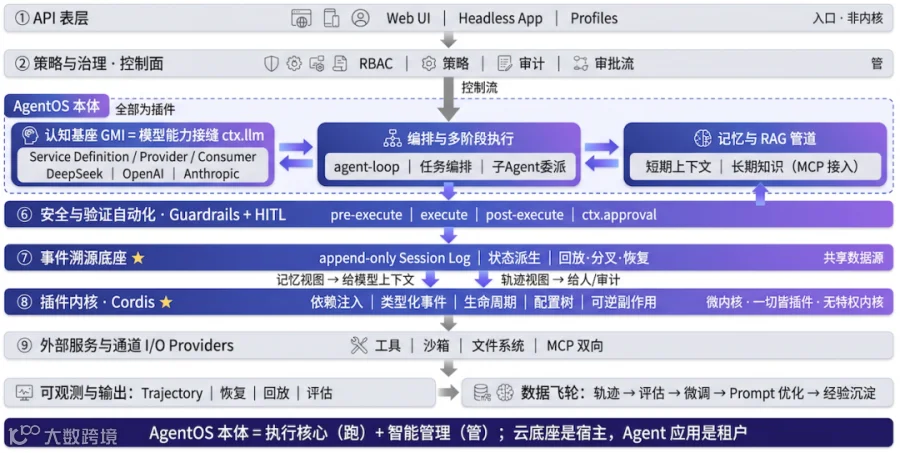
( 融入DeepSeek Harness的AgentOS)
要让协作不乱套,靠三条硬约束:
信任边界:调度中枢从不直接调 Agent 的执行入口,也从不导入业务模块——调度与执行严格分离;
结构防递归:子任务跑在全新的独立流上,且自身不再创建子任务——从结构上就不可能无限递归;
信封可追溯:每条跨Agent消息都带信封(通道、发送方、因果链、追踪号、深度、生存时间)——深度和生存时间就是防失控的硬闸。
协作方式上,顺序流水线、并行合成、辩论、审查循环、层级分派、有向无环图等策略,都作为通信结构的"适配器"去实现。关键是:不同的编写方式(声明式工作流、任务式、图式)要编译成统一的中间表示,交给同一套运行时 + 检查点存储去执行——避免"每种协作模式各写一套运行时"的碎片化。
资源抽象层:一切外部资源皆协议
最底层只做一件事:用协议(接口)把所有外部资源解耦。这叫"协议优于继承"——组件之间靠接口协作,而不是靠继承耦合,这才换来了"可替换、可降级"。
五类资源全部协议化:
-
模型客户端:OpenAI、Anthropic、Gemini、本地模型……统一接口,坏了自动降级链; -
工具协议:MCP、函数工具、客户端工具,渐进式披露; -
沙箱:微虚拟机、WebAssembly、容器、专用沙箱,没有后端就拒绝执行; -
知识存储:内存、磁盘、SQLite、Redis、向量库、图库,统一路径语义; -
流/存储:内存流、Redis 流,从单机平滑迁到分布式。
两条配套原则:优雅降级——核心模块缺第三方依赖时照样能导入,只是调用时才报错并附安装提示;互操作——MCP(工具生态)、A2A(跨 Agent)、AG-UI(前端流)、ACP(编码智能体)作为可选外围接入。
以上六部分合起来,就是一台"可控、可靠、可观察、会改进"的智能体操作系统:内核循环负责干活,四个内核服务负责后勤,控制平面管住边界,观测平面盯着并帮着改进,协作和外部资源都做成可插拔的协议。它不承诺让模型更聪明,只承诺让每一次"思考—行动"都发生在可控边界内、留下可查的证据、并能从失败中有节制地进步。