


Vidu S2 来了!
距离 Vidu S1 发布仅 69 天,我们更进一步,带来实时视频双高峰作品。
并且,发布即开放体验:
🎮 立即体验:
https://vidu.com/vidu-stream
🛠️ API 平台:
http://platform.vidu.com/vidu-stream/doc
📄 技术报告:
https://arxiv.org/pdf/2609.11638
S2-Editing 实时编辑模型,支持实时换风格、换穿搭、换主体、换背景,让视频成为一个实时响应、持续变化的世界。
S2-Avatar 实时互动模型,让实时角色更清晰、更稳定,也更能实时动作参考,接住你的临场想法。
One More Thing: Vidu S2 - Spatial 空间化视频探索,提前推开全景空间视频的大门。
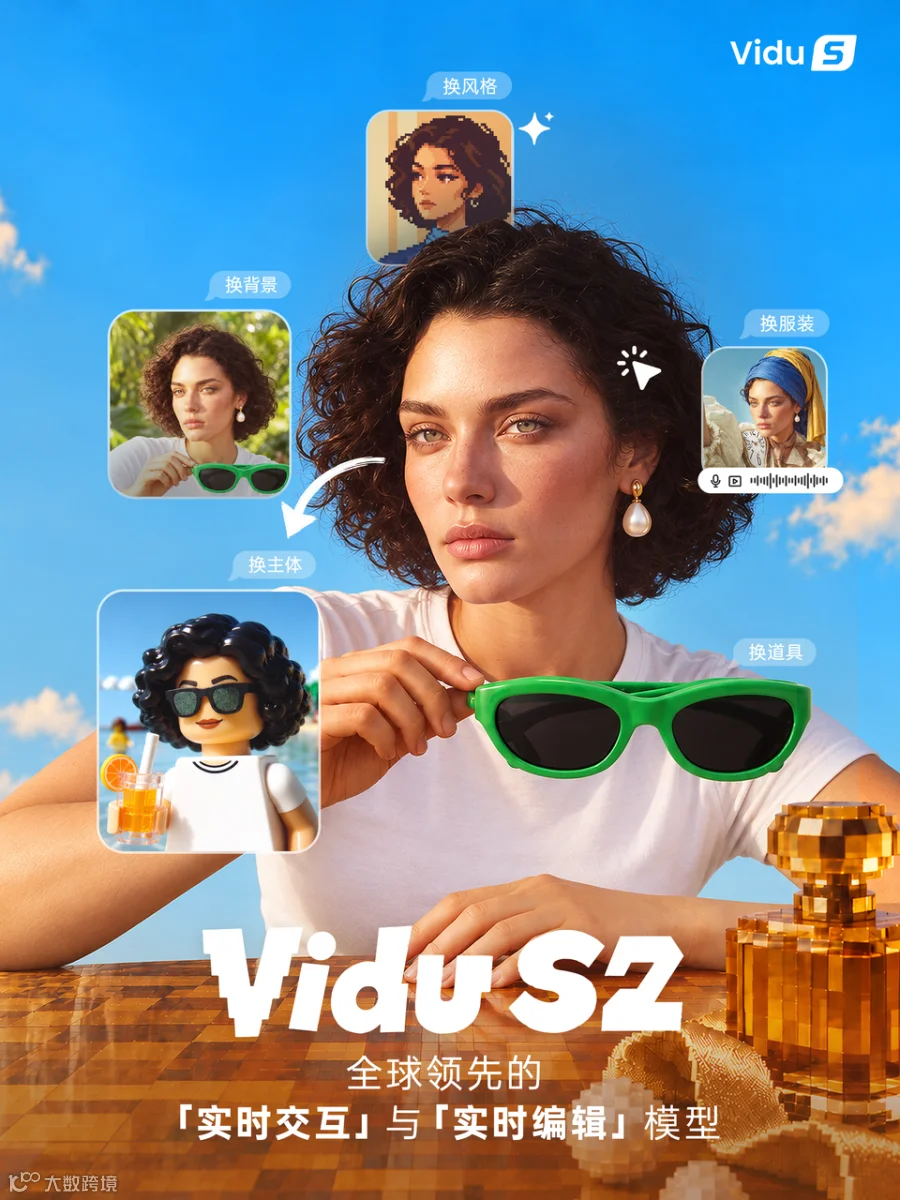
Vidu S2 因何而来?
上一代 Vidu S1 已经证明了视频可以实时回应人,可实时视频更加难的,是让它在一个不断变化的现场,始终稳稳地“活下去”。
直播到一半,观众递来一件新衣服、一件道具、一张新场景图,角色能不能立刻接住,继续演下去?
一段正在发生的视频,能不能不暂停、不重做,就当场换人、换装、换风格、换背景,同时不丢掉原本的动作和节奏?

连放出三个大招,Vidu S2 在主流基准评测中取得领先成绩。
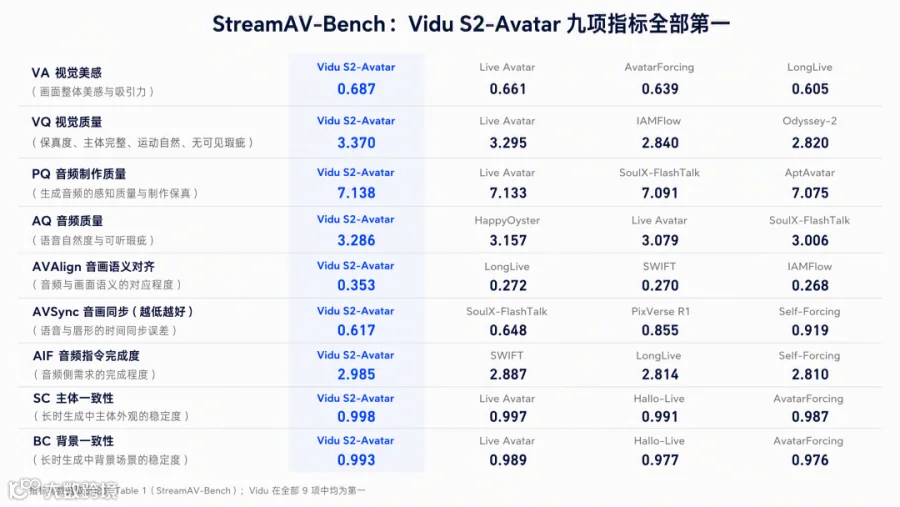
S2-Avatar 在 StreamAV-Bench 对比中取得画面、音频、音画协同、主体与背景一致性等 9 项最优。
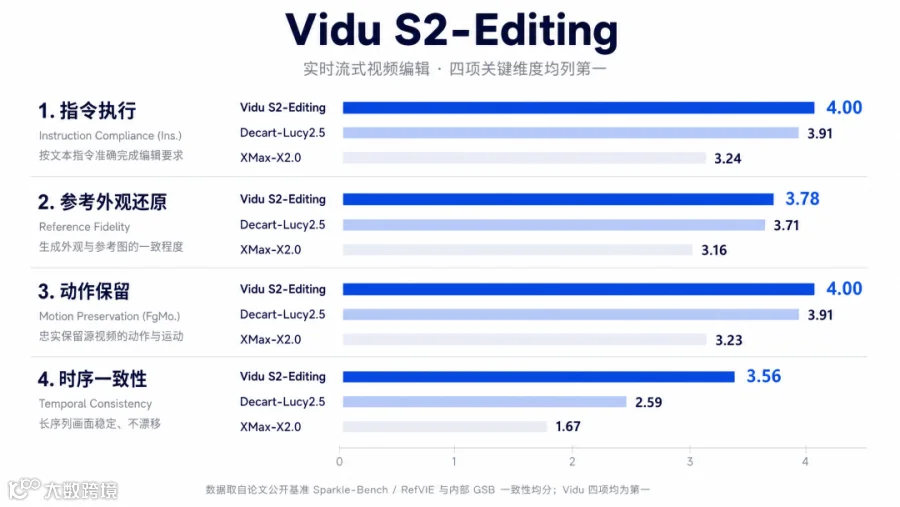
Vidu S2-Editing 在指令执行、参考外观还原、动作保留与时序一致性等关键维度均取得领先成绩
实时编辑 Vidu S2-Editing:像修图一样,实时“精修”视频流
过去,改变风格或换装常常意味着拍摄结束后,再进入剪辑软件重新做一遍后期。
现在,Vidu S2-Editing 将这种百万级后期的魔法,提前到了镜头正在运行的时刻。
只需一条简单的文本指令,外加一张可选参考图,你就能对正在播放的视频流进行实时编辑,施展四种魔法: 改风格、虚拟试穿、换角色、换背景
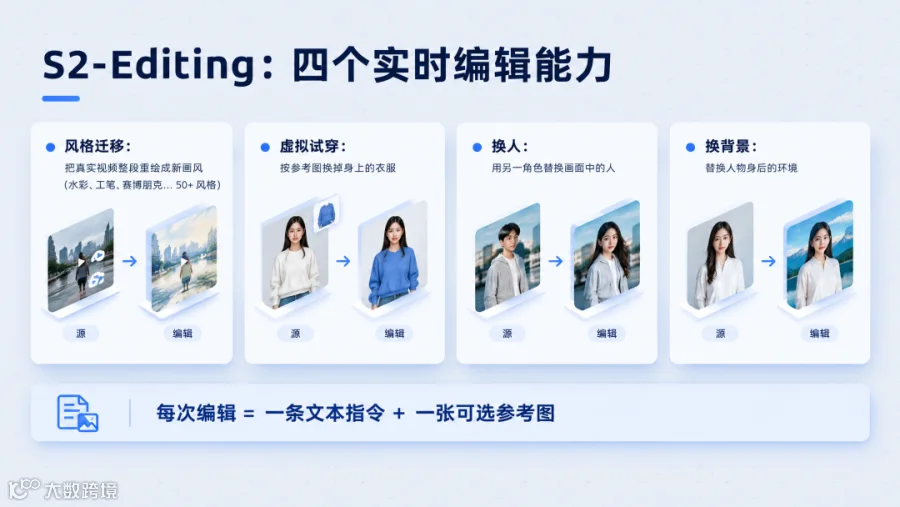
虚拟试衣,实时换装,重塑电商与零售体验:打破“买家秀与卖家秀”的隔阂,让指定时尚单品瞬间上身。这不仅能应用于主播,更能切实解决真实消费者的决策痛点。消费者在购买前即可直观看到服饰完美贴合肢体动作的试穿效果。这将极大降低了购买决策成本,直接帮助商家提升成单转化率,并有效降低退货率,实现体验与生意的双赢。
角色替换,IP 商业化的百变大咖秀:将画面中的主角,瞬间无缝替换为另一个形象或二次元角色,连肢体节拍都分毫不差。未来,也许品牌方或游戏厂商可以直接让自家的虚拟偶像、游戏主角“空降”直播间代替真人带货,粉丝沉浸感拉满,开拓全新的 IP 变现与互动玩法。
背景替换,瞬息全宇宙:这一秒在温馨卧室,下一秒就在异国街头或卢浮宫,杂乱背景一键清退。尤其对于跨境电商或场景化营销而言,这将意味着极低的布景成本:卖户外冲锋衣时秒切雪山背景,卖高端美妆时瞬间置身巴黎秀场,高度契合的场景氛围强力拉动满满停留与购买欲。
风格迁移,极低成本的素材裂变引擎:无论是赛博朋克、水墨画还是动漫风,不管是局部还是全部渲染,实拍短片瞬间风格重绘,且风格贯穿全片。这为短剧出海、游戏买量以及品牌大促提供了批量生成差异化视觉素材的利器,一条原片瞬间裂变出适配不同圈层的多次元广告。
在高速运动的视频里疯狂改图,如何保持画面依然稳如泰山?
S2-Editing 采用帧对齐稀疏注意力等底层技术,实现在实时编辑时,新画面的每一帧都严格锁死并对齐原视频的同一时刻,确保换装、换人后的运动轨迹绝不穿帮、画面不撕裂。
实时交互 Vidu S2-Avatar:高清、稳定,即兴表演
如果说 Vidu S1 让角色学会了回应,那么 Vidu S2-Avatar 则让角色学会了“接招”。
它在跨越数字人“只能看不能玩”的恐怖谷,赋予 AI 角色“临场接戏”的即兴表演能力,越来越像一个真正带脑子、带记忆且能全身运动的“活体演员”。
凭借全面升级的 720P R2V 与 25-42 FPS 的超高实时输出帧率,现在的人物、发丝与画面细节都无比清晰细腻。
但真正改变游戏规则的,是动态参考。以前的角色一旦设定,全程无法更改。但在 Vidu S2 的世界里,你可以随时随地强行“介入”:
任意时刻动态参考:在视频持续生成过程中,用户可以随时补充新的参考图:一只杯子、一件衣服,或一个新的场景。当粉丝在直播间点播想看某款香水时,模型瞬间“拿”出产品进行展示,画面不仅极其顺滑不会打断,且 S2-Avatar 会持续保留状态信息,记住介绍时香水应留在手里。这种极具前后关系的连贯交互,彻底打破了以往呆板的“说话头”,还原了线下真实、有温度的导购服务。
自定义一键换装:视频播到第 30 秒,粉丝想看新衣服。只需传一张图片,角色在视频流完全不中断的情况下,瞬间完成换装,动作连贯、情绪不掉线。
支持舞蹈等指令的完整肢体表演,强大的指令跟随能力:从简单的“说话头”彻底解放,S2-Avatar 支持涵盖独舞、2D/3D动画在内的全身高难度动作跟随,怎么动都不崩。
和上一代 Vidu S1 能力对比
为了彻底终结长时间流式生成带来的“崩溃”与“漂移”,我们独创了 SRF(Self-Replay Forcing)训练技术。简单来说,模型拥有了“自我纠错的记忆”,它学会了直面自己的生成历史并修正误差。
这不仅仅是一个会说话的模型,而是一个能在千变万化中,把戏完美演下去的演员。未来的 AI 不应该只是一段只能观赏的漂亮 CG,而应该是一个你能递给它一杯水,它会接过来并对你笑的数字生命。
One More Thing:迈入全景空间视频的任意门
除了平面屏幕,我们还想带你走得更远。
Vidu S2 带来了空间化视频方向的惊艳探索。通过将单目实时视频转换为左右眼同步画面,我们正面向 VR 等沉浸式设备打造极具空间感的实时体验。让视频不仅在时间上连续发生,在空间感知上也保持完美的一致。

发布即体验,从 Day 1 开始共创
Vidu S2 的发布,不是一次能力展示的终点,而是与千万创作者共创的起点。
对实时视频来说,真正的挑战,往往发生在真实使用中:真实的直播间、高强度的游戏创作和你们无数个疯狂的脑洞。
所以这一次,我们依然选择尽早把能力交出来。
发布,即开放体验。
Vidu S2 还会继续打磨。我们也希望从真实的互动和创作中,更快知道它已经能做什么,还有哪些地方需要继续改进。
欢迎从 Day 1 开始,来玩、来试、来挑战。那些没有被接住的指令、不够自然的动作,以及你最希望补上的能力,都欢迎告诉我们。
🎮 立即体验:
https://vidu.com/vidu-stream
🛠️ API 平台:
http://platform.vidu.com/vidu-stream/doc
📄 技术报告:
https://arxiv.org/pdf/2609.11638
🔗 Vidu S1 往期链接:
生数科技发布 Vidu S1,推动视频生成迈向“实时交互”新时代