


我们每天都在往 AI 里输入越来越多东西。
工作方案、代码、合同、会议记录,有时候甚至是体检报告、个人经历,以及一些不太方便跟别人说的话。
但有一个设置,很多人可能从来没有认真看过:
你和 AI 的这些对话,会不会被拿去改进和训练模型?
以 ChatGPT 为例,个人账户的数据控制里有一个“为所有用户改进模型”的选项。OpenAI 官方明确说明,在允许使用内容训练模型的情况下,用户提交的内容可能被用于模型改进;关闭之后,新的对话不会再用于训练模型。
DeepSeek、豆包、智谱清言、腾讯元宝等产品,也有各自的数据管理或体验优化设置,只是入口、默认状态和具体规则并不完全一样。
我把自己常用的几个 AI 都翻了一遍设置。
这篇文章就做一件很实际的事:看看这些开关到底藏在哪里,以及关掉以后,还有哪些事情需要注意。

1 你的聊天,究竟可能怎样被用于 AI?
先把一个很容易混淆的问题说清楚。
我们平时打开 AI 问一个问题,使用的是已经训练完成并部署好的模型。你发出问题,模型进行推理,然后给你答案。
这和“训练模型”是两回事。
如果平台允许把用户内容用于模型改进,那么符合条件的对话可能经过筛选、过滤以及减少个人信息等处理,再进入后续的模型改进流程。以 OpenAI 为例,其官方说明会在训练数据用于改进模型之前,采取措施减少其中的个人信息;2026 年公布的隐私技术说明中还提到,会对训练数据以及允许“为所有用户改进模型”的用户对话应用隐私过滤。
这里还有一个很重要的区别:
模型并不是一个聊天记录数据库。
训练更接近于让模型从大量数据中学习规律并调整参数,而不是把某一次聊天原封不动地存进模型里,等以后再把它调出来。OpenAI 对模型训练的解释也是“学习信息之间的关系”,而不是像数据库一样保存信息。
所以,“我的聊天记录被平台保存”和“我的聊天被用于模型训练”,实际上是两个问题。

2 为什么这个开关值得你自己检查一次?
以前很多人使用搜索引擎,输入的通常只是几个关键词。
现在使用 AI 完全不一样。
为了让 AI 真正帮我们干活,我们会主动提供大量上下文:把一份合同整个上传,让它帮忙检查;把公司的代码贴进去,让它找 Bug;把会议记录扔进去,让它整理纪要;甚至把检查报告上传,让它帮忙解释指标。
我们交给 AI 的信息,正在变得越来越完整。
而不同 AI 产品、不同账户类型,对这些数据的处理方式并不完全相同。
比如 OpenAI 目前明确区分个人服务和商业服务。对于 ChatGPT 等个人服务,在符合设置条件的情况下,内容可能用于训练模型;ChatGPT Business、Enterprise 和 API 等商业产品,默认不使用客户的输入输出训练模型。
所以我越来越觉得,使用一个 AI 产品之前,除了看模型能力、价格和功能,还应该顺手看一眼它的数据设置。
可能只需要一分钟。
3 实操:把常用 AI 的设置检查一遍
以下路径根据我目前使用的产品界面整理。AI 产品更新很快,如果以后界面发生变化,菜单名称和位置可能会有所调整。
3.1 豆包
路径:设置 → 隐私与权限 → 帮助模型改进效果
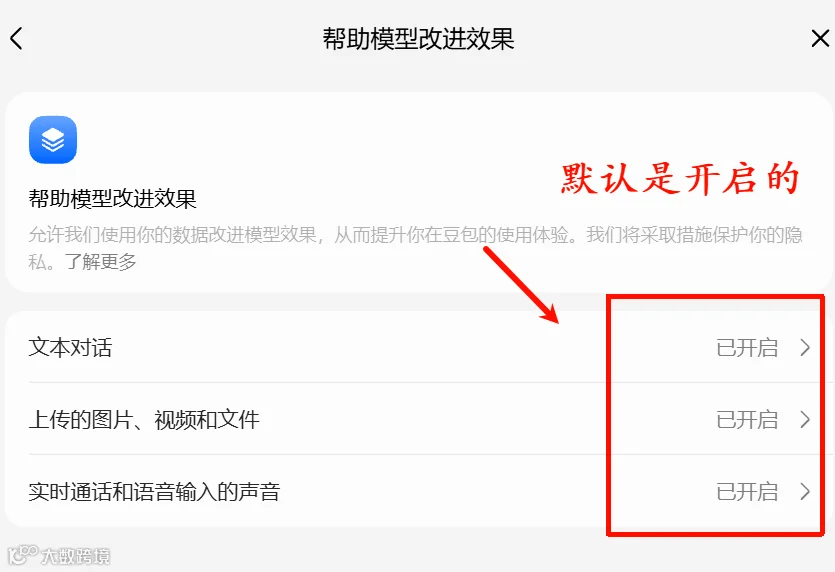
进入之后,可以分别看到文本对话、上传的图片/视频/文件、实时通话和语音输入等相关选项。
如果不希望相应内容用于模型改进,可以根据自己的需要关闭。
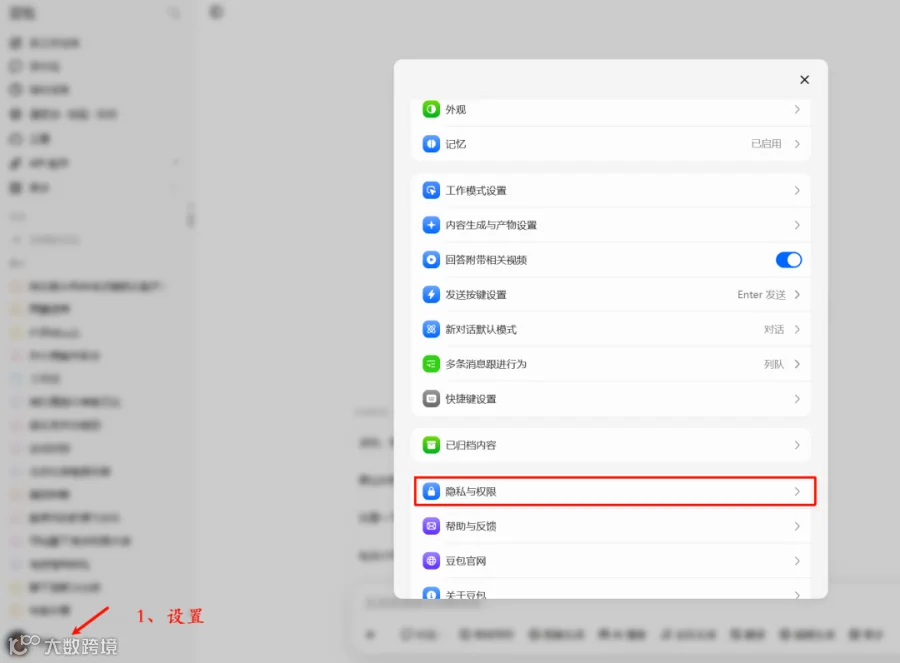
选择帮助模型改进效果
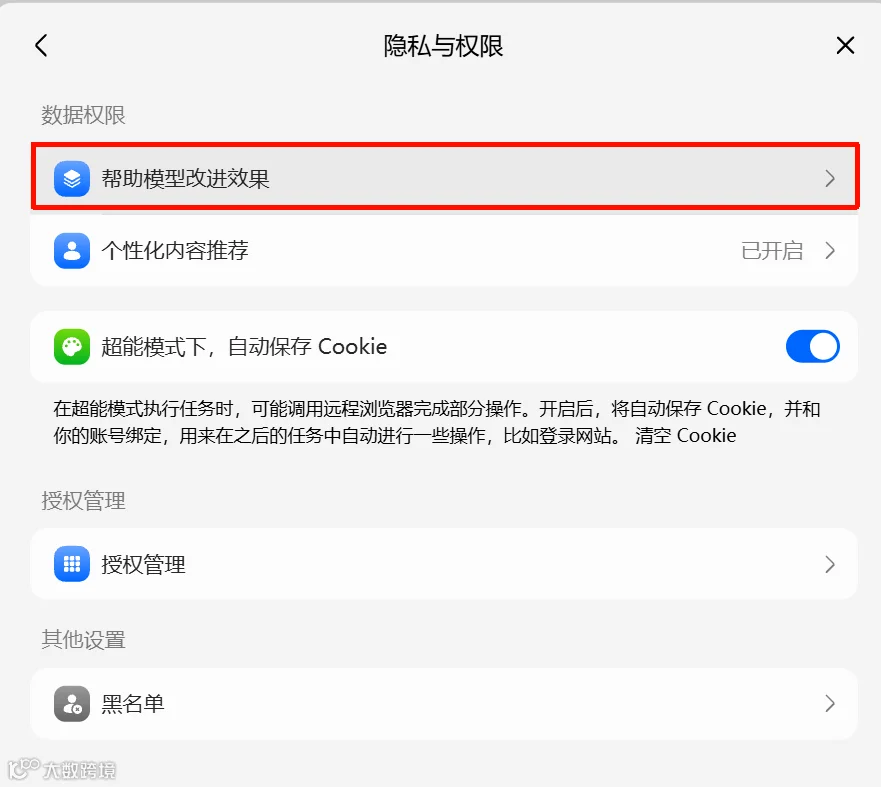
默认都是开启的,关闭即可。
3.2 DeepSeek
路径:头像 → 系统设置 → 数据管理 → 数据用于优化体验
找到“数据用于优化体验”之后,可以直接调整。

3.3 智谱清言
路径:头像 → 设置 → 数据管理 → 数据用于优化体验
进入数据管理后,可以看到相关开关。

ㅤ
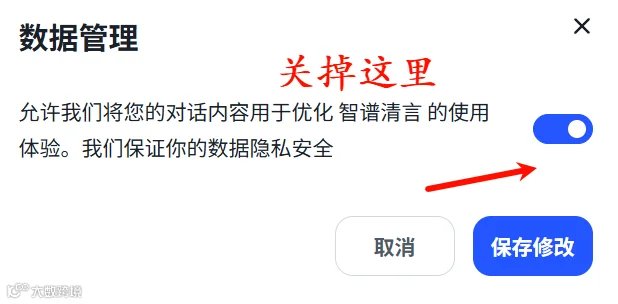
3.4 腾讯元宝
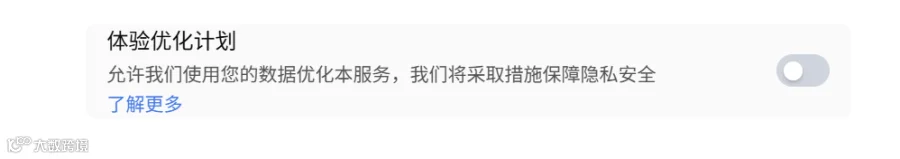
路径:设置 → 数据管理 → 体验优化计划
这里有一点和前面的产品不太一样:我目前看到的“体验优化计划”默认处于关闭状态。
这个必须给腾讯元宝点个赞。
至少从默认选择上,它把决定权留给了用户。

必须点个赞,默认是关闭的。
3.5 ChatGPT
路径:头像 → 设置 → 数据控制 → 为所有用户改进模型
关闭以后,聊天仍然可以正常保存在历史记录中,但新的对话不会再被用于训练 ChatGPT。这个设置会同步到同一账户使用的设备。

至于 Kimi、通义千问、文心一言,我这次在当前产品界面中没有找到与前面几款产品完全对应的关闭入口。
这里我不想简单下结论说它们一定没有,因为产品版本、客户端以及隐私政策都有可能变化。如果大家发现了新的入口,也欢迎补充。
4 关掉训练开关,事情就结束了吗?
这是我觉得整篇文章里最需要说清楚的一部分。
答案是:还没有。
首先,关闭训练通常影响的是之后产生的新内容。以 ChatGPT 为例,官方的表述非常明确:选择退出之后,新的对话不会再被用于模型训练。
其次,有些反馈机制可能存在单独的规则。比如 OpenAI 明确说明,即使已经退出模型训练,如果你主动对某个回答点“赞”或“踩”提交反馈,与这次反馈关联的整段对话仍可能被用于训练模型。
还有一个特别容易被忽略的问题:
训练、聊天记录和记忆,其实是三件事。
训练开关决定的是符合条件的新对话能否用于改进模型。
聊天记录决定的是这次会话是否继续保存在你的账户和平台系统中。
记忆则决定 AI 会不会在之后的对话中继续使用关于你的某些信息。
所以,关闭训练开关,并不等于删除聊天记录;删除一段聊天,也不能简单理解为同时关闭了 AI 的记忆功能。

5 还有一个问题,比关开关更重要
把这些设置一个个翻完之后,我反而觉得,真正值得我们注意的并不只是某个 AI 到底开没开训练。
更重要的是,我们正在越来越习惯把完整的信息交给 AI。
以前你可能只问一句:
这个合同条款是什么意思?
现在很可能直接把整份合同上传。
以前问:这个报错怎么解决?
现在可能直接把一整个代码仓库交给 Agent。
AI 越来越好用之后,我们给它的数据也越来越多,而且越来越真实。
这时候,一个藏在三级菜单里的数据设置,就变得比以前重要得多。
用户当然可以选择贡献自己的数据来帮助模型变得更好,这本身没有什么问题。
但我更希望这种选择是清楚的:我知道自己的数据可能怎么被使用,也知道在哪里可以改变这个选择。
这才是数据控制真正应该解决的问题。
6 如果你经常使用 AI,我建议做这几件事
第一,花几分钟检查一下自己最常用的 AI,把模型改进、体验优化、数据用于优化这类设置都看一遍。不同平台规则不同,不要默认认为它们都是开启的,也不要默认认为它们都是关闭的。
第二,真正敏感的数据,尽量不要直接输入公共 AI 服务。 即使关闭了模型训练,也不能把它理解成任何数据都可以放心上传。身份证号、银行卡信息、账号密码、公司核心数据、未公开代码和涉密材料,该做脱敏的还是要脱敏。
第三,一次性或者相对敏感的内容,可以优先使用平台提供的临时对话功能。以 ChatGPT 为例,Temporary Chat 不进入历史、不用于训练,也不会创建记忆,但仍可能因安全需要保留最多 30 天。
第四,工作场景尤其要注意公司自己的数据安全要求。企业版和 API 往往有不同于个人版的数据政策,但这并不意味着所有业务数据都可以随意上传。公司的数据分类分级、保密制度和第三方数据处理要求,优先级应该更高。
最后,偶尔回去看看这些设置。
AI 产品更新得实在太快。今天看到的菜单、开关和规则,以后都有可能发生变化。
写在最后
我们越来越习惯把问题交给 AI,也越来越习惯把自己的信息一起交出去。
所以这次把几个常用 AI 的设置翻了一遍之后,我最大的感受其实很简单:
AI 可以越来越懂你,但你至少应该知道,它是通过什么方式在使用你的数据。
一个开关解决不了所有隐私问题。
但知道它在哪里,知道自己可以选择,是第一步。
学废了或有启发,别忘了顺手给我点个赞、在看、转发,三连~因为你的反馈真的很重要!如果想第一时间收到推送,也可以给我个星标⭐