9月3日,GPT-6 Astra发布。
朋友圈刷屏了。有人说AGI时代来了,有人说工作要没了,有人说再不拥抱AI就要被淘汰。
然后呢?
热闹是别人的。你的企业AI项目,该卡在哪还是卡在哪。
模型越来越强,企业AI的回报却越来越难拿。
行业研究显示,绝大多数生成式AI试点项目没有产生可衡量的回报。Gartner甚至预测,到2026年,超过半数的AI项目将被放弃。

很多人以为,企业AI做不好,是因为模型选得不对。
换个更大的模型?买更贵的算力?找更牛的算法团队?
这些都重要,但都不是核心问题。
核心问题是:你的数据,AI根本"吃"不到。
什么意思?
企业里的数据,散落在十几个系统里。ERP里有销售数据,CRM里有客户数据,MES里有生产数据,WMS里有库存数据,财务系统里有成本数据……
每个系统的数据格式不一样,口径不一样,更新频率不一样。同一个"销售额",销售部算出来一个数,财务部算出来另一个数,运营部又有第三个版本。
你让AI去分析销售数据,它应该听哪个系统的?
AI不会帮你解决数据混乱的问题。它只会把数据混乱的结果,用更流畅的语言讲出来。
更麻烦的是,企业里大量数据根本没有被结构化。合同在PDF里,技术文档在Word里,会议纪要在聊天记录里,经验在老员工脑子里。
这些数据对人有用,对AI没用。AI要的是干净的、结构化的、有标注的、能理解的数据。
而大多数企业的数据现状是:
- 数据散在各处,拿不全
- 口径不统一,信不过
- 质量参差不齐,用不了
- 没有元数据管理,找不着
这就像你请了一个米其林大厨,却只给了他一堆没洗、没切、没分类的食材。
大厨技术再好,也做不出好菜。
不是AI不行,是你的数据基础设施不行。

第一个:拿不到——数据散在孤岛上
企业建了那么多年信息化,建出了一堆系统孤岛。
每个系统各管一摊,数据互不打通。销售数据在销售系统,库存数据在库存系统,财务数据在财务系统。看起来每个系统都在产生数据,但合在一起用的时候,全是断点。
要做一个"哪些产品卖得好但不赚钱"的分析,得从三个系统里导数据,人工拼到一张Excel里,再挨个核对口径。
人干都费劲,你让AI怎么干?
AI不是神仙。它拿不到完整的数据,就只能基于残缺的信息给出残缺的答案。
数据孤岛不打通,AI再聪明也只是个"盲人摸象"的高手。
第二个:信不过——口径不统一,数据会打架
更头疼的是,同一个指标,不同部门算出来不一样。
销售额怎么算?含税还是不含税?包含退货吗?包含折扣吗?算渠道还是算终端?
每个部门有每个部门的定义,每个系统有每个系统的口径。开会的时候,销售报一个数,财务报一个数,运营再报一个数。谁也说服不了谁。
你把这些数据喂给AI,它只会选一个它"觉得"对的口径,然后给你一个看起来很专业、实际上可能完全错了的答案。
数据质量的短板,会在大模型场景下被集中放大。
因为大模型不会主动质疑数据的准确性。输入的数据有问题,输出的结论就有问题。而且因为AI的回答看起来特别流畅、特别自信,你甚至更难发现哪里错了。
脏数据 + 强模型 = 更隐蔽的错误。
第三个:用不了——数据躺在那里,谁也"读不懂"
还有一种情况:数据有,质量也还行,但AI就是用不了。
为什么?因为数据没有被"翻译"成AI能理解的语言。
企业的数据表里,字段名可能是英文缩写,可能是拼音首字母,可能是技术人员随手起的名字。业务部门的人都看不懂,更别说AI了。
数据之间的关系是什么?这个指标是怎么算出来的?那张表是从哪个系统来的?更新频率是多少?哪些数据是可信的、哪些是仅供参考的?
这些信息,以前靠人问、靠经验传、靠文档查。AI没有这个能力。


很多企业搞AI的顺序搞反了。
一上来就选模型、搭平台、买算力,恨不得明天就上线一个"智能大脑"。结果做了半年,发现数据根本接不进来,接进来了也用不了,用了也不敢信。
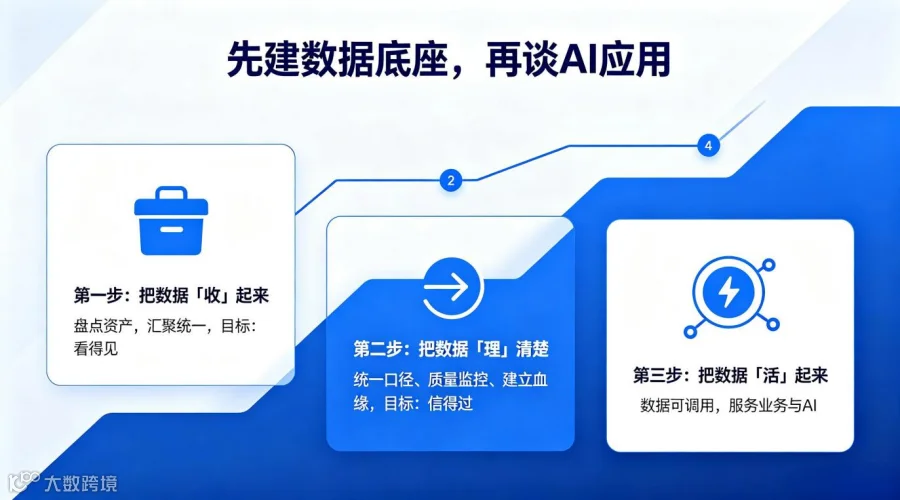
正确的顺序是:先建数据底座,再上AI应用。
就像盖房子,先打地基,再盖楼。地基没打好,楼盖得越高越危险。
具体怎么做?三步。
第一步:把数据"收"起来
第一步不是搞AI,是搞清楚你到底有哪些数据。
数据都在哪?有哪些系统?每张表是什么内容?每个字段是什么意思?数据从哪来、到哪去?
先做一次全面的数据资产盘点。把散落在各个系统的数据,统一汇聚到一个平台上。让数据从"分散在各处"变成"集中在一处"。
这一步的目标不是完美,是看得见。
以前你不知道自己有多少数据、数据在哪、谁在用。现在至少能在一个地方看到全貌。
这是数据治理的起点,也是AI落地的前提。
第二步:把数据"理"清楚
数据收上来了,还不能直接用。得把它理清楚。
怎么理?三件事:
统一口径。
把"销售额""利润""客户数"这些核心指标的定义,在系统里固定下来。不管哪个部门看、哪个系统取,结果都是一样的。
保障质量。
建立数据质量监控机制。缺失值、异常值、重复记录,系统自动发现、自动预警。不让脏数据流到下游,更不让脏数据喂给AI。
建立血缘。
搞清楚数据之间的关系。这个指标从哪张表来的?经过了哪些计算?最后用到了哪里?出了问题能追溯到底,改了底层能预判影响。
这一步的目标是信得过。
数据口径统一了、质量有保障了、来龙去脉清楚了,AI用起来才靠谱。
第三步:让数据"活"起来
数据收好了、理清楚了,最后一步是让它真正服务于业务。
怎么服务?不是做一堆大屏给领导看,是让数据能被业务部门、被AI系统随时调用。
比如天枢·数在做的事情,本质上就是帮企业把数据从"躺在系统里的死资产"变成"能被业务和AI随时调用的活资产"。通过数据中台把分散的数据汇聚起来、把指标口径统一起来、把数据血缘理清楚,然后通过驾驶舱、分析工具、移动端应用,让数据真正服务于日常决策。
数据中台不是给AI做的,但没有数据中台,AI就是空中楼阁。
因为AI需要的不是一堆原始数据,而是一套完整的数据服务能力——能取到、能理解、能信任、能追溯。

以前建数据中台,目标是"让业务部门用数据做决策"。
现在建数据中台,目标多了一层:让AI能用数据干活。
这两个目标听起来差不多,实际上差别很大。
业务部门用数据,是人在看、人在判断、人在决策。数据有点小问题,人能发现、能修正、能打个折用。
但AI用数据不一样。AI是自动的、规模化的、24小时不停的。数据有问题,它不会自己发现,不会自己修正,只会按照错误的数据给出错误的答案,而且速度快、规模大、隐蔽性强。
所以,AI时代的数据中台,要求比以前更高。
高在哪?
第一,数据质量要求更高。
以前数据有点小问题,人能兜底。现在不行——AI规模化使用,小问题会被放大成大问题。数据质量必须从"差不多就行"变成"精确可靠"。
第二,数据服务能力要求更高。
以前数据中台主要服务人,人能等、能问、能查。现在要服务AI,AI需要的是API化的、标准化的、可直接调用的数据服务。数据不能再躺在报表里,得变成能被系统直接消费的接口。
第三,数据治理要求更细。
以前治理到表级就差不多了。现在不行——AI需要理解每个字段的含义、每个指标的口径、每条数据的来源。治理必须从"表级"深入到"字段级"甚至"值级"。
一句话:AI越强大,对数据中台的要求就越高。

不用做复杂的评估。回答三个问题就够了。
你的企业,能不能在10分钟内,拿到一份口径统一、数据准确的经营日报?
如果不能,说明你的数据还没"收"好。数据还散在各处,人工拼凑、层层上报,效率低还容易错。AI连基础数据都拿不到,更别说高级应用了。
你的核心业务指标,各个部门的口径是一致的吗?开会的时候,大家用的是同一个"销售额"吗?
如果不是,说明你的数据还没"理"清楚。口径不统一,数据就不可信。数据不可信,AI给出的结论就更不可信——而且因为AI的回答看起来特别专业,你反而更容易被误导。
如果有人问"这个数是怎么来的",你能在5分钟内说清楚它的来源、计算逻辑和影响范围吗?
如果不能,说明你的数据血缘还没建立起来。出了问题找不到根,改了数据不知道影响谁。这种状态下让AI自动跑业务,风险是不可控的。
三个问题里只要有一个答不上来,说明你的数据中台还没建到位。
别急着追新模型。先把数据底座打牢。
模型可以随时换,算力可以随时加,但数据治理这件事,欠的债早晚要还。而且越晚还,代价越大。


GPT-6很厉害。后面还会有GPT-7、GPT-8,模型会越来越强,越来越便宜。
但模型是公共资源。你能用到的模型,你的竞争对手也能用到。大家站在同一起跑线上,拼的不是谁的模型更大,是谁的数据更好、谁的数据中台更扎实、谁能把AI真正用到业务里。
未来的企业竞争,表面上拼的是AI应用能力,背后拼的是数据中台的建设能力。
模型可以买,算力可以租,AI工具可以开源。但你自己的业务数据、数据质量、数据治理体系,这些是买不来、租不到、也抄不走的。
这才是企业真正的护城河。
—END—
内容看完有收获
点个“推荐”吧