

编辑 | 倪云松
审核 | 王紫嫣
今天介绍一篇发表在 Nature Machine Intelligence 上的论文:Large language models as uncertainty-calibrated optimizers for experimental discovery。在反应条件优化和功能分子设计实验里,“下一步测什么”面临高昂的时间与资源瓶颈。传统的贝叶斯优化(BO)难以跨领域迁移,而大语言模型(LLM)虽有通识却缺乏严谨的不确定性评估。为此,本研究提出 GOLLuM 框架,通过高斯过程贝叶斯目标联合微调 LLM,将 LLM 的盲目自信逆转为精确的学习信号,驱动其特征空间自发聚类出清晰的设计结构。
一、背景
生成模型可以在服务器里一小时画出一万个新分子,但任何一家药企或实验室,一年的湿实验通量可能只有几百到几千次。从反应优化到分子设计,实验探索都面临着同一个代价高昂的难题:在时间与资源有限的约束下,下一个实验该测哪个候选样本?

贝叶斯优化(BO)提供了符合统计原理的方案,但极度依赖难以跨领域迁移的专家经验:例如优化一个化学反应,需要先将分子结构、催化机理和路径转化为包含化学直觉的手工描述符。这些特征表示几乎无法通用。
大语言模型(LLMs)作为通用模型展现出跨越领域边界的能力,蕴含丰富的先验知识,却受制于一个致命缺陷:不可靠。LLM会产生幻觉,输出看似言之凿凿实则完全错误的内容。

在此,作者提出了 GOLLuM(Gaussian process Optimized LLMs,高斯过程优化大模型),它没有将大模型直接当作实验优化器,而是将其深度整合进成熟的贝叶斯优化机制中,实现基于自然语言的规范化科学决策。GOLLuM 通过高斯过程的边际似然(Marginal Likelihood)与大模型进行联合端到端训练。来自该目标的梯度反向传播给 LLM,教会大模型去编码实验结果与表现,而非单纯的文本字面相似度,从而将其隐空间自组织为截然不同的高表现与低表现区域。

二、方法
2.1 实验设计的跨领域通用文本表征
在化学反应、材料合成与生物分子优化中,实验变量通常包含离散类别(试剂种类、催化剂)、连续数值(温度、停留时间、投料比)以及复杂拓扑结构(分子 SMILES)。传统的贝叶斯优化(BO)高度依赖定制化特征工程(如 DFT 量子化学描述符或 DRFP 反应指纹),这些表征无法跨领域迁移。为打破表征壁垒,作者提出了一种基于自然语言的统一编码机制:将任意异质参数空间统一转化为标准化文本描述,并由通用大语言模型(LLM)映射为高维连续嵌入空间。
构建与嵌入过程分为两个标准化步骤:
① 标准化模板构建(Template Construction): 将每次实验的具体条件定义为键值对模板: 。对于复杂反应优化,模板覆盖溶剂配比、温度及催化剂等多种异质变量;对于单变量分子属性优化,模板直接简化为分子标识符。这提供了一种适用于不同科学任务的无缝文本接口。
② 连续高维嵌入提取(LLM Embedding): 将模板化文本 传入预训练语言模型,生成固定维度的连续稠密向量: 。该嵌入天然保留了自然语言预训练阶段学到的参数内在拓扑与语义关系,无需为每个领域定制专门核函数,即可直接输入标准连续核进行概率建模。
2.2 基于深度核学习(DKL)的 LLM 架构适配
直接使用冻结的静态 LLM 嵌入作为高斯过程输入面临严重的几何失配:预训练语言模型的潜在空间基于文本共现组织,导致目标属性函数的响应面极其崎岖。为此,研究引入深度核学习(Deep Kernel Learning, DKL)框架,将核函数建立在经参数化变换后的动态特征空间上:
其中 表示高斯过程核的超参数(长度尺度 、信号方差 、噪声方差 及常数均值 ), 是具有可学习参数 的特征提取网络。如图 3 所示,针对不同计算约束和模型开放度,作者系统评估了三种模块化适配架构:
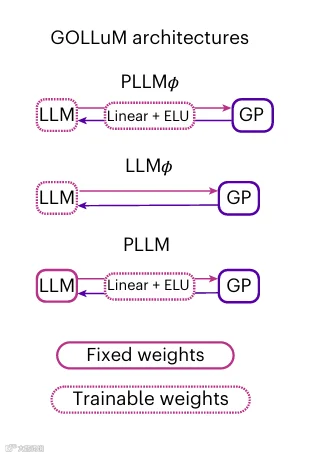
① 投影层架构(PLLM): 在固定的预训练 LLM 嵌入外层构建轻量级映射: ,其中 为可学习的线性投影矩阵,结合激活函数。该结构主要用于闭源 API 模型(如 OpenAI Embeddings),在不改动基础大模型权重的前提下学习任务特定的表征重构。
② 参数高效微调架构(LLM ): 基于低秩自适应技术(LoRA)直接对开源大模型的注意力层权重进行动态调整: 。LoRA 仅需更新极低比例的参数,在充分保留大语言模型深厚化学常识先验的同时,避免灾难性遗忘并降低计算开销。
③ 级联复合架构(PLLM ,GOLLuM 主力模型): 将 LoRA 调优与非线性投影层串联: 。该架构兼具底层特征自适应与高阶流形塑形的双重自由度,实验表现最为强健。
2.3 边际似然驱动的端到端联合概率优化
传统语言模型微调主要依靠均方误差等确定性回归损失,仅关注点估计预测而完全剥离了不确定性分布。GOLLuM 的底层突破在于:将贝叶斯高斯过程的对数边际似然(Marginal Likelihood)作为唯一的训练目标,直接反向传播微调大语言模型的深层权重。
给定历史观测数据点 个(输入矩阵 ,目标标量向量 ),边缘似然函数解析形式如下:
式中, 为包含观测噪声的核协方差矩阵,元素为 。该目标函数天然体现了奥卡姆剃刀原则:第一项确保变换后的空间能精准解释实验观测,第二项复杂度惩罚项自动约束模型容量,从数学原理上杜绝了在极小样本下微调大模型的严重过拟合风险。
优化求解直接通过全局梯度上升完成:
利用矩阵求导法则,解析梯度沿网络反向传播至 GP 超参数与 LLM 适配器权重:
在训练实践中,为保证优化过程的数值稳定性并消除两类参数的曲率失衡,算法对 LLM 嵌入参数 和 GP 超参数 分别赋予了独立的解耦学习率。
2.4 隐式度量学习与设计空间几何重构
为什么在没有任何显式对比损失或数千条样本标注的情况下,GOLLuM 仅凭 10 个失败的初始实验样本即可重塑出极具泛化性的潜在表征?数学推导揭示了高斯过程优化过程中的隐式对比学习机制。
基于距离的平稳核,核值随潜在空间欧氏距离增加而单调衰减。将公式中的二次型数据拟合项重写为基于逆核矩阵加权系数 的成对相互作用和:
梯度下降优化会自动对 LLM 空间施加动力学推拉:迫使高产率(或高活性)实验与低产率实验在几何上相互远离,而令具有相近性能的实验在嵌入空间中紧密聚类。
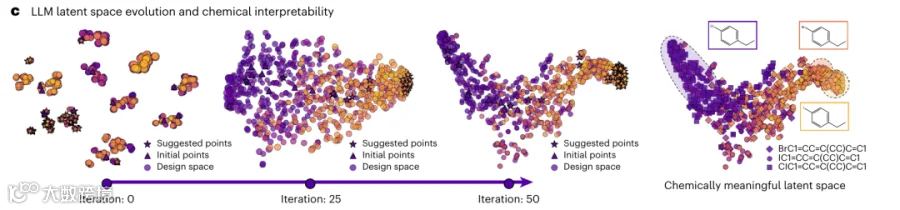
如下图所示,以 Buchwald–Hartwig 反应设计空间为例,随着主动学习迭代的推进(0 步 25 步 50 步),t-SNE 降维投影生动展示了模型潜在表征的演变轨迹:初始混乱分布的化学空间自发演变出清晰的化学活性聚类——高反应活性的碘代芳烃反应(I)被聚合在高产率区域,而低活性的氯代物(Cl)被清晰分离至低性能区域,呈现出完全符合物理化学先验的规律。
这种基于边缘似然对齐的隐式度量学习,使学习到的 GP 长度尺度与平均成对距离之比( 平滑度度量)由原始 LLM 的低于 0.8 大幅跃升至 1.4 以上。这不仅赋予高斯过程一个平滑、利于探索的高质量目标流形,更使大模型在无需人工干预的情况下,具备了向人类专家清晰解释其决策机理的可解释性。
三、实验
3.1 跨科学领域的稳健高效优化
为了检验语言模型是否能真正摆脱人工特征工程的桎梏并具备通用的实验优化能力,研究团队构建了一个极具挑战性的跨学科评估体系。他们一口气搜集了横跨有机合成、高通量分析、化工工艺、新能源催化及功能分子设计 4 大学科门类、共 23 个真实的实验基准任务。
在这场全流程使用同一套通用超参数、仅靠10个低产失败实验冷启动、且预算被严格锁死在50步以内的实验中,作者使用了三大代表作为基准方法:依赖人类专家几十年手工特征的传统高斯过程标杆、直接冻结大模型抽取死向量的 BoChemian、以及用传统均方误差微调再事后贴置信度补丁的LAPEFT。

如上图所示,GOLLuM在前5%优质方案覆盖率上达到36.3%,全面超越传统高斯过程(29.7%),并在缺乏专用特征的工艺化学中取得90%的相对提升(13.4%增至25.4%)。在样本效率上,收敛曲线显示其减少了41%的实验迭代即可匹敌传统基准。更为关键的是,隐空间t-SNE投影揭示了其表征重塑机制:模型通过似然微调从原本无序的分布中自组织出清晰的高/低产率聚类,并在无监督条件下自发捕获了关键科学规律,实现了全局搜索效率与机理可解释性的统一。
3.2 静态 LLM 表征的局限与表征几何重塑机制
作者在经典的布赫瓦尔德-哈特维希 C–N 偶联反应基准上进行了系统诊断,揭示了静态 LLM 嵌入在优化中失效的深层机理:决定优化成败的关键是表征空间的几何平滑度,而非模型蕴含的化学知识多寡。
-
静态表征全面受挫:瓶颈在于“几何结构”而非“知识匮乏”
在 50 次实验预算内,各类静态 LLM 仅能发现 15%–26% 的最优反应(Top-5%),大幅落后于化学专属指纹 DRFP(38%)。即便化学专精模型 T5Chem 表现同样低迷(23%),但仅将输入切换为 SMILES 格式其发现率增加 44%。这表明模型并不缺少化学知识,而是静态向量空间未与优化搜索对齐。
-
图3a: 静态 LLM 表征优化性能全面落后于化学专属指纹 DRFP。 -
核心机制揭秘:平滑度比拟合精度更决定成败
传统回归指标( )与优化表现相关性仅为 0.78;而作者提出的表征平滑度指标——GP 长度尺度与样本空间平均距离的比值( ),与优化表现的相关系数高达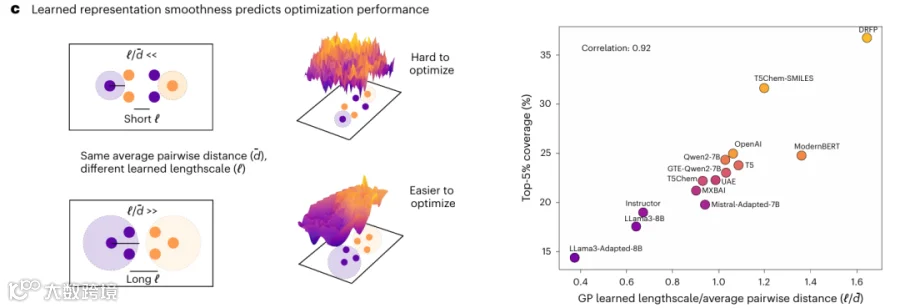
-
图3c: 与 Top-5% 发现率呈现极高正相关( ),证明平滑几何空间是高效优化的核心前提。 -
深度核微调(GOLLuM):反向传播重塑表征空间
GOLLuM 将高斯过程边缘似然转化为训练信号,推出三类微调架构:适配闭源 API 的投影层
-
图3b: GOLLuM 三种深度核架构示意,微调后各架构性能均迎来爆发式跃升。
3.3 隐式对比学习与涌现的化学可解释性
针对 AI 在实验科学中普遍存在的黑盒质疑,作者通过分析模型在 Buchwald–Hartwig 反应中的动态演化过程,揭示了 GOLLuM 的另一核心机制:高斯过程的边缘似然目标本质上扮演了隐式对比损失的角色,无需任何人工标注,即可驱动 LLM 潜在空间自发涌现出符合化学规律的结构化认知。
-
隐式度量学习:产率差异驱动的嵌入距离拉伸
传统微调需要显式构建正负样本对,而 GOLLuM 在联合优化 GP 边缘似然时,数学上自然导出了类似对比学习的效果:产率相似的实验点被拉近(高核相似度、小空间距离),产率悬殊的点被推远。这种机制迫使模型直接根据实验成败重构潜在空间。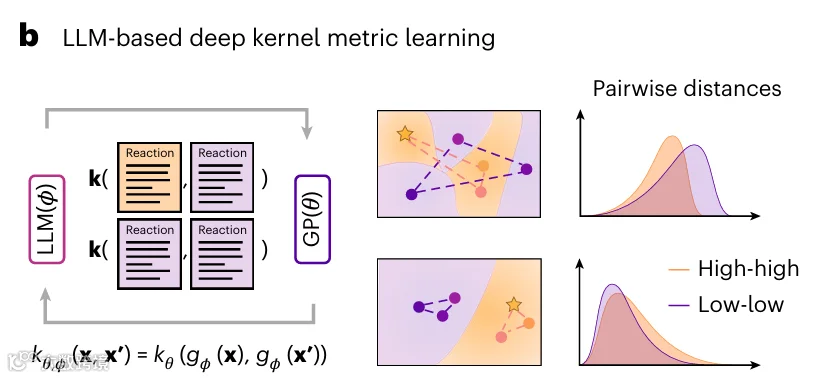
-
图4b: 深度核度量学习示意图。展示了 GP 边缘似然如何自发驱动“高产-高产”聚集、“高产-低产”分离。 -
化学规律涌现:从未被教导,却能精准复现反应活性趋势
在初始状态(迭代 0),LLM 的潜在空间呈现完全无序的混沌状态;随着贝叶斯优化迭代推进(迭代 25 至 50),空间自发演化出高度结构化的化学图谱——高活性的芳基碘化物(I)被自动聚类在高产率区域,而低活性的芳基氯化物(Cl)被隔离在低产率区。模型在完全没有领域规则指导下,自主“领悟”了经典的偶联反应活性阶梯。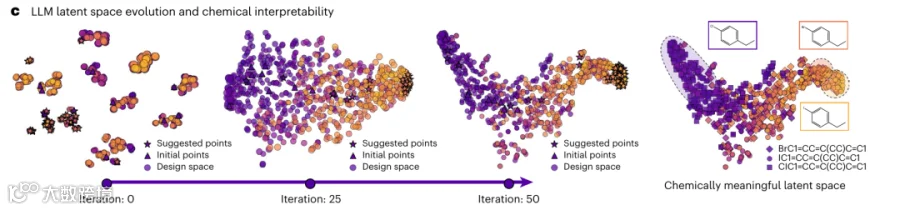
-
图4c: 潜在空间随迭代进程的 t-SNE 动态演化过程(4c),直观展示了化学反应规律的自发涌现。 -
几何分离直接转化为采样效率的大幅跃升
两两样本间的 距离分布显示,随着实验进行,“高产-低产”之间的距离显著增大,而同类反应紧密聚集。这种鲜明的几何分离消除了目标函数中的剧烈震荡,使得自适应模型( )从早期迭代开始便在搜索速度和 Top-5% 覆盖率上全面碾压静态基线。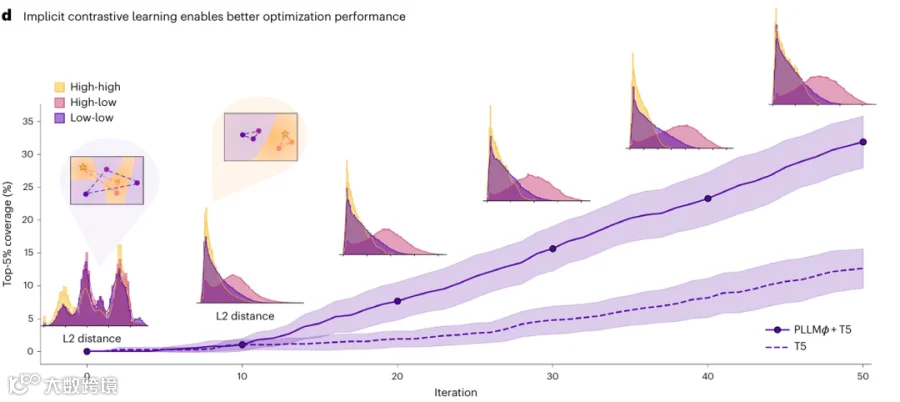
-
图4d: 优化迭代轨迹与距离分布内嵌图。高产与低产样本空间距离逐步拉大,直接驱动了优化成功率的持续领先。
4. 总结
4.1 创新点
架构创新:LLM 与高斯过程的深度核联合优化(DKL)
算法创新:基于 GP 边缘似然的端到端梯度回传(摒弃传统 MSE 回归)
理论发现:提出优化几何黄金判据( )
4.2 指导意义
数学本质:GP 边缘似然即无需负采样的连续对比学习
范式重构:不确定性引导胜过海量文献蛮力堆砌
通用底座:自然语言统一跨学科表征
扫描二维码获取
更多精彩
AI in Graph

点个在看+赞支持一下