· 2026 ·
RESHAPE · 万有引力
/让我们用 AI 一起重塑职业未来/

过去用 AI 生图,很像抽卡:写提示词、生成,不满意就重来。但真实设计不是一次交付,而是不断返工——耳机换色、删掉便签、加一张照片,再把麦秸秆换成雏菊。只要每次修改都会牵动整张图,AI 就很难真正进入工作流。
这次测试,我们不只看 GPT Image 2.5 会不会画,而是看它能不能理解已有画面、准确执行修改,并在多轮编辑中尽量保留之前的结果。测试覆盖连续编辑、草图理解、中文数字修改、透明背景商品图和 Poster 模板等场景。

GPT Image 2.5 正从单次生成,走向生成、理解、编辑和迭代的一体化流程。
更快
官方称,相比 Images 2.0,生成延迟最高降低 50%。这不代表每张图都会快一倍,实际速度仍受尺寸、质量档、网络、服务器负载及任务类型影响。本文没有进行严格计时,因此只引用官方结论,不用网页端等待时间做横向判断。
更稳
图像编辑最棘手的问题,不是 AI 不会改,而是改了 A,又顺手动了 B、C、D。2.5 强调局部编辑和多轮一致性:用户点名修改什么,就尽量只动什么;上一轮结果也应成为下一轮的编辑基础。
更像设计工具
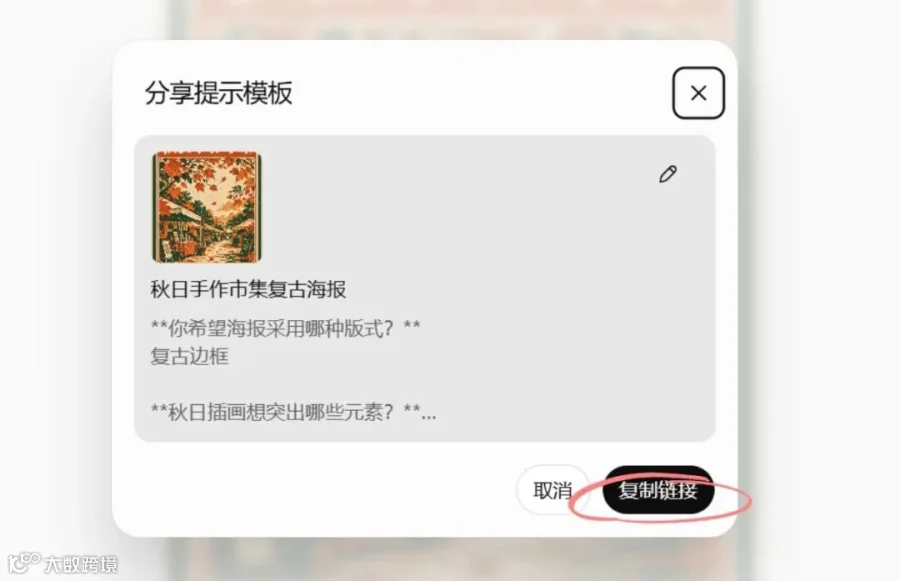
草图、图片批注、Poster 和 Merch 模板,以及提示模板分享,让用户不必每次从空白提示词开始。AI 的角色也从“生成一张图”,逐渐变成“陪你把图改完”。

GPT Image 2.5 包含两款定位不同的模型。两者的官方 Token 单价相同,差别主要在速度与复杂任务处理能力。
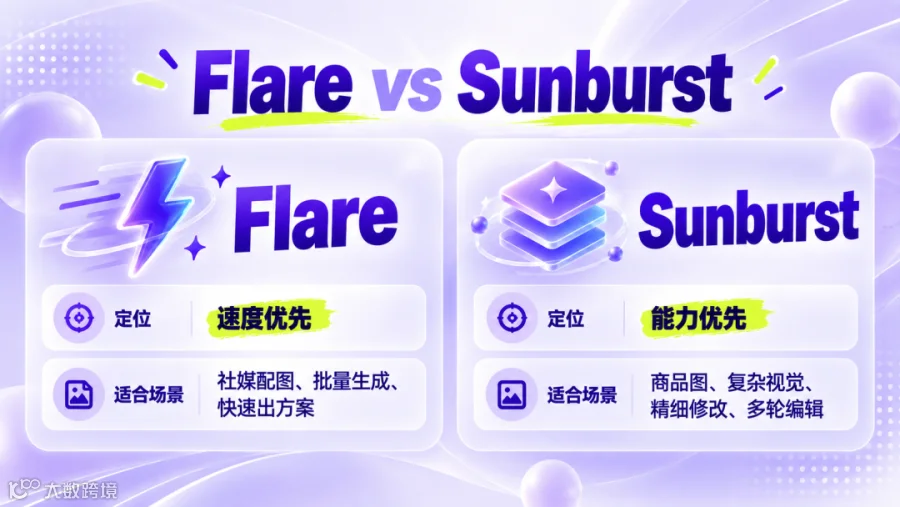
Flare 和 Sunburst对比图
需要注意:在 ChatGPT 网页版中,用户看不到手动选择 Flare 或 Sunburst 的开关,具体模型由系统自动处理。因此,下面的网页实测统一称为 ChatGPT Images 2.5,不对单张结果强行贴模型标签。通过 API 调用时,开发者可以按任务需求选择。

01
桌面图连续修改四轮测试
图1|初始基准原图
这是我们的初始基准图,整体构图、光影都已经固定定型。所有静物元素摆放规整,画面风格统一,作为我们后续一步步微调对比的基础样本。
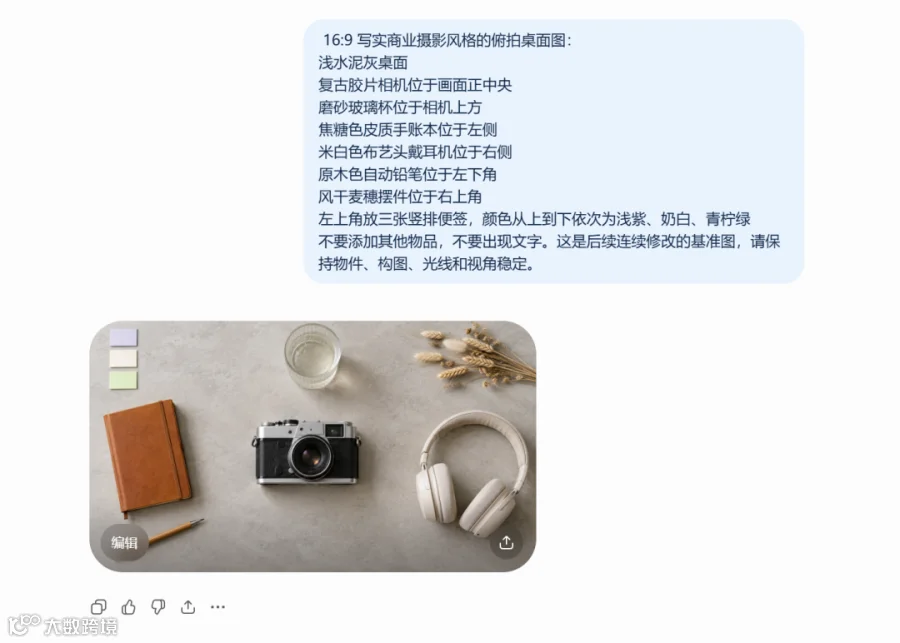

图2|耳机配色修改
修改单个耳机的颜色,其余不变


图3|删掉单个便签
在上一张图的基础上,我们只移除青柠绿色便签。
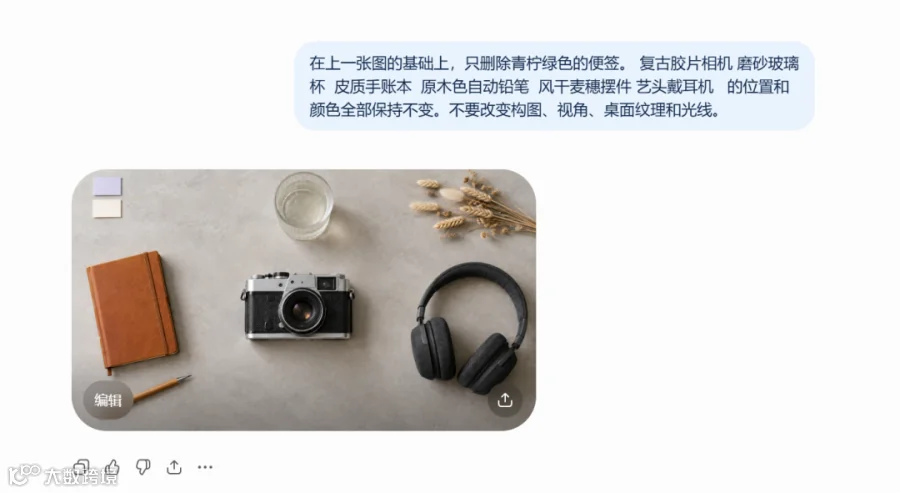

图4|把麦秸秆改成雏菊花
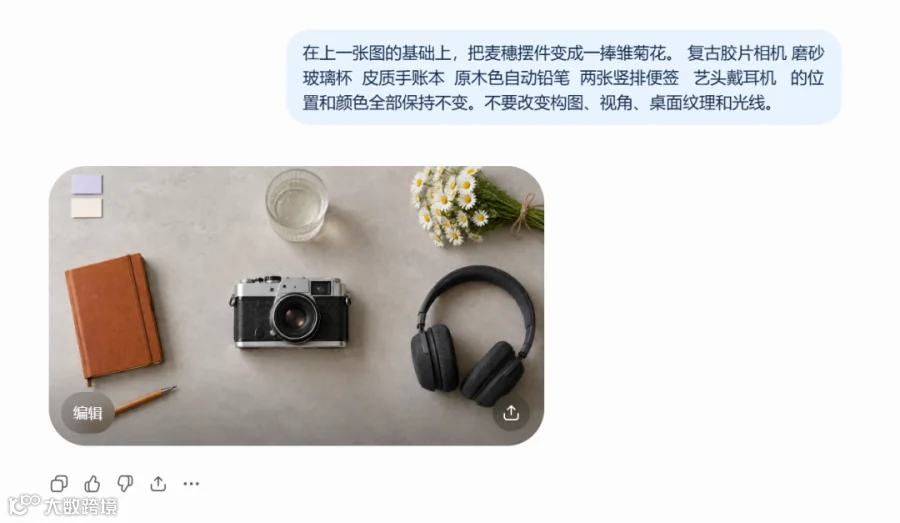
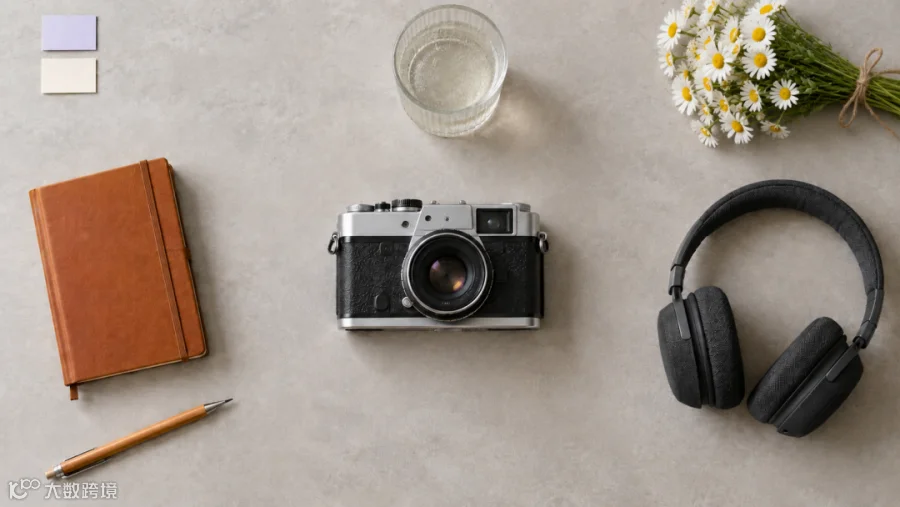
模型精准识别目标物体,将麦穗自然替换为雏菊,花束光影和桌面环境完美融合,其余物品没有发生任何形变、移位。这种局部物体替换,很适合快速测试产品搭配、更换画面装饰元素。
图5|在相机下方添加一张雏菊花的照片
继续测试 Image2.5 的局部添加能力:在保留整张桌面静物画面的前提下,向指定位置插入一个新物体,我们选择插入一张雏菊花的照片。


Image2.5 精准定位相机下方区域,自然嵌入一张雏菊相片,相片的光影、透视与桌面环境完美融合,其余物品没有发生任何形变或移位。这种局部插入能力,非常适合快速调整画面构图、补充装饰元素,无需重新生成整张图。
从单物体改色、删减元素、替换物件到新增细节,整套测试直观印证了GPTimage2.5 新版本的超强实力!相比旧版本,它对单个物体的修改精度大幅提升,真正做到「改一处、不动全局」,不会乱重绘、不跑偏光影,画面稳定性极强,是精细化AI修图、画面微调的绝佳工具!
不过,它适合概念设计、广告视觉、社媒内容和快速出稿;若任务要求精确排版、专业修图或像素级一致,Photoshop、Illustrator、Figma 等专业工具仍不可替代。
02
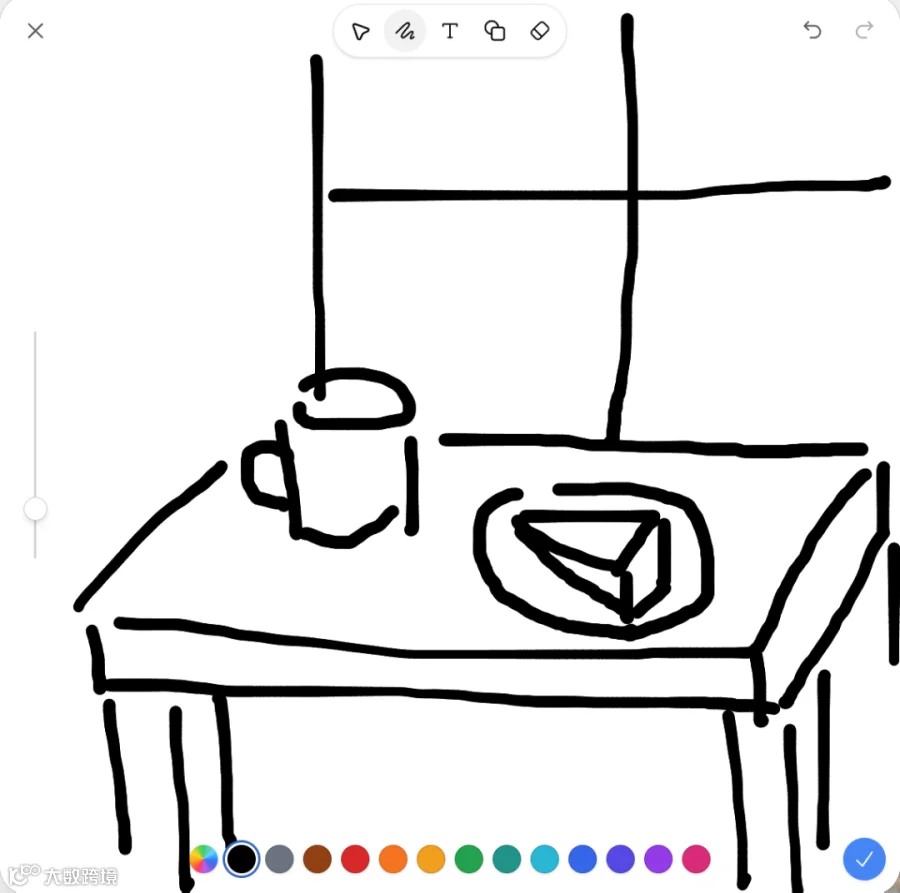

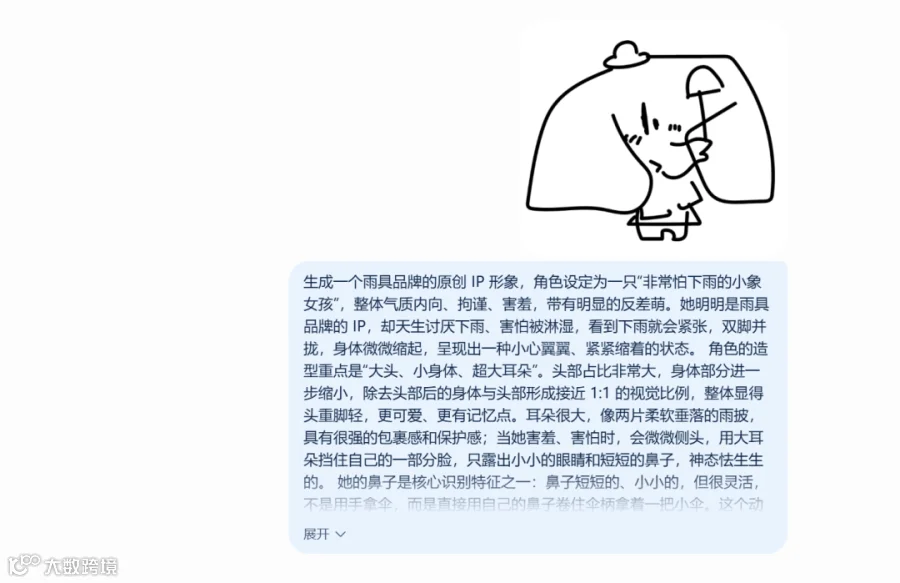

Sketch 对 2.5 的帮助非常明显。相较 2.0 更偏向重新解释文字描述,2.5 更愿意遵循草图提供的轮廓等关键关系,同时把粗略线稿补全为具有品牌感的角色。草图在这里不只是风格参考,更像是对构图和角色骨架的约束。
这意味着用户不必依靠极长的文字去解释空间关系:当角色姿态、轮廓或物体位置难以描述时,一张简单草图往往比继续增加提示词更有效。
不过,草图约束越强,模型越可能沿用其二维造型语言;如果希望获得特定材质或三维质感,还应额外明确媒介、光线和表面材质。
03
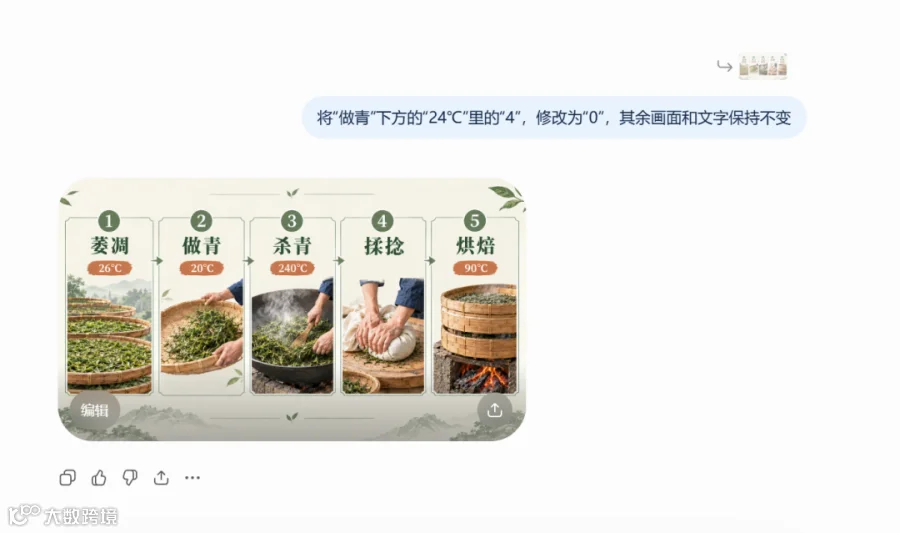
中文和数字一直是 AI 生图的高风险区域。画面再漂亮,只要“24℃”被改成“29℃”,成品就无法直接使用。我们拿一张已经完成的信息图,只要求修改其中一个数字,其余内容保持不变。
这同时考验文字准确性和局部编辑能力,也模拟了最常见的返工场景:客户临时改数据,但整张图不能重做。
我们先生成了一张含有多个数字的茶叶制作流程图:

茶叶制作流程图

04
透明背景商品图
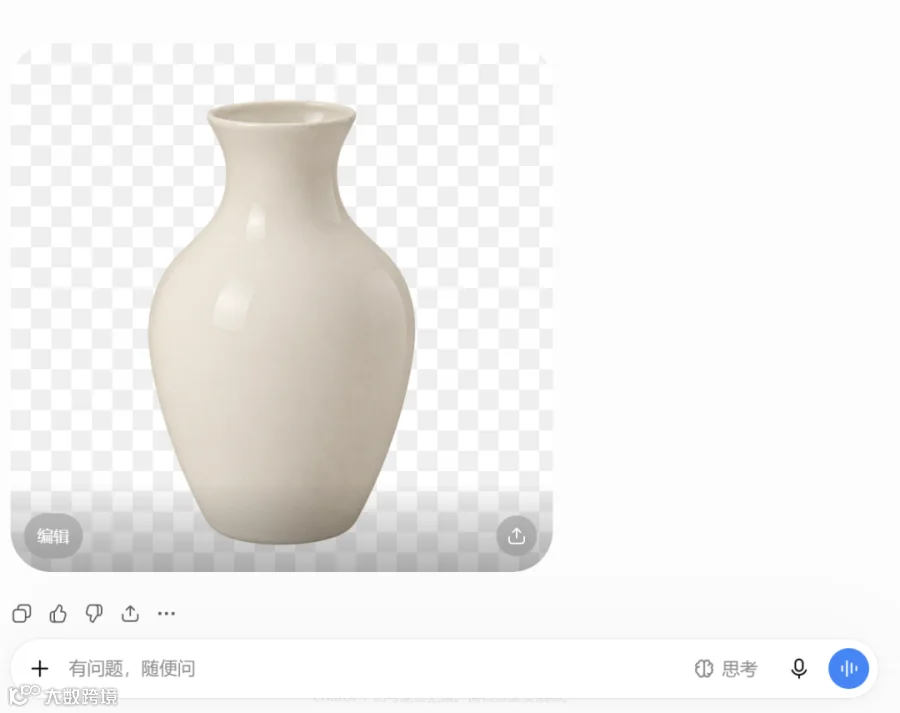
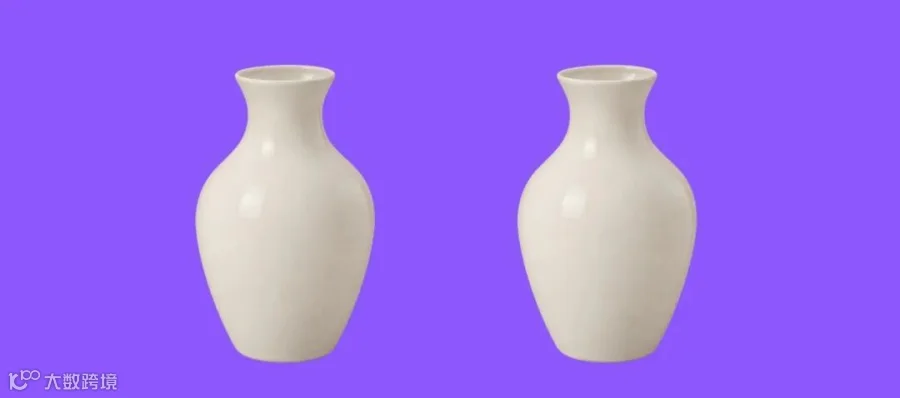
我们生成了一个陶瓷花瓶商品摄影图,测试能否直接得到可用于后续设计的素材。重点包括主体完整度、边缘质量、细节与光影,以及背景是否真正带 Alpha 透明通道。
05
Poster 模板
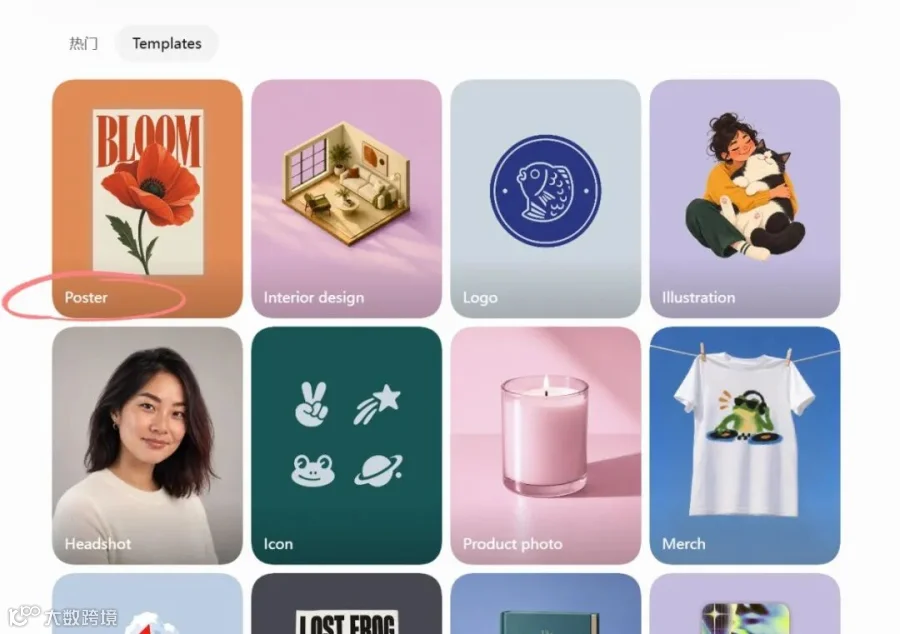

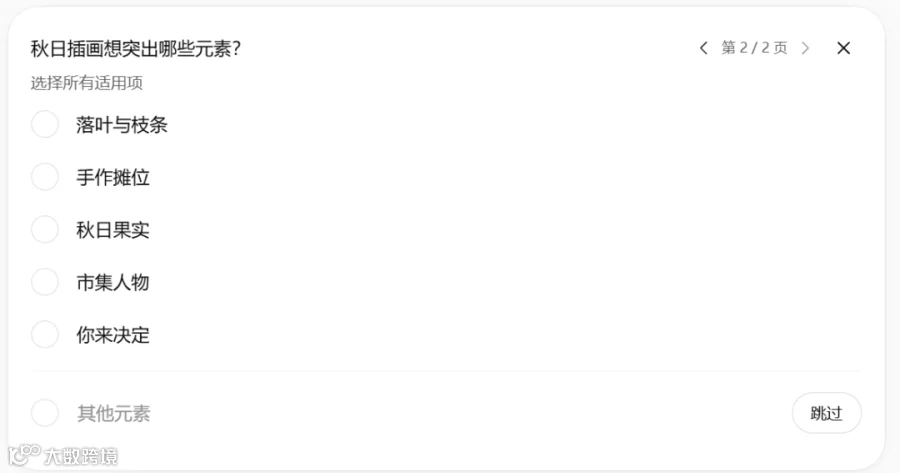
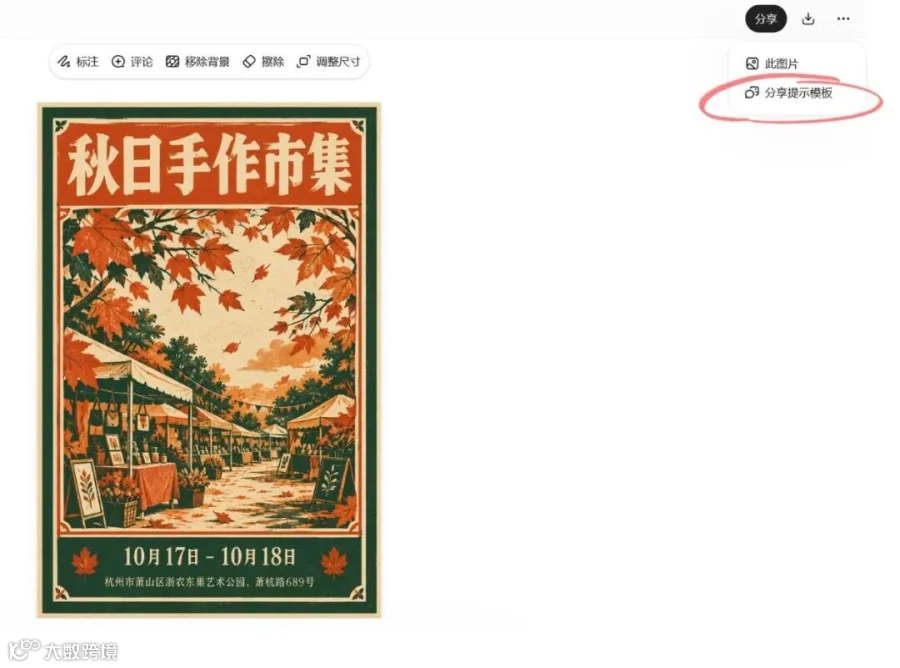
工具会弹出版式、重点突出元素等选项供我们挑选。本组提示词,仅生成了两项可选内容,最后生成了这张海报:

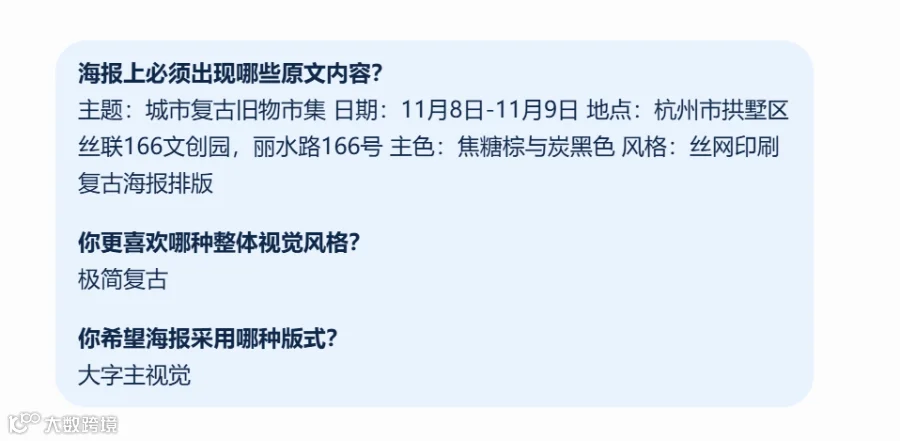
之后我们继续测试另一组。这一次,模型会先询问海报核心信息,再确认画面风格,后续给出的两项选项和上一组保持一致。
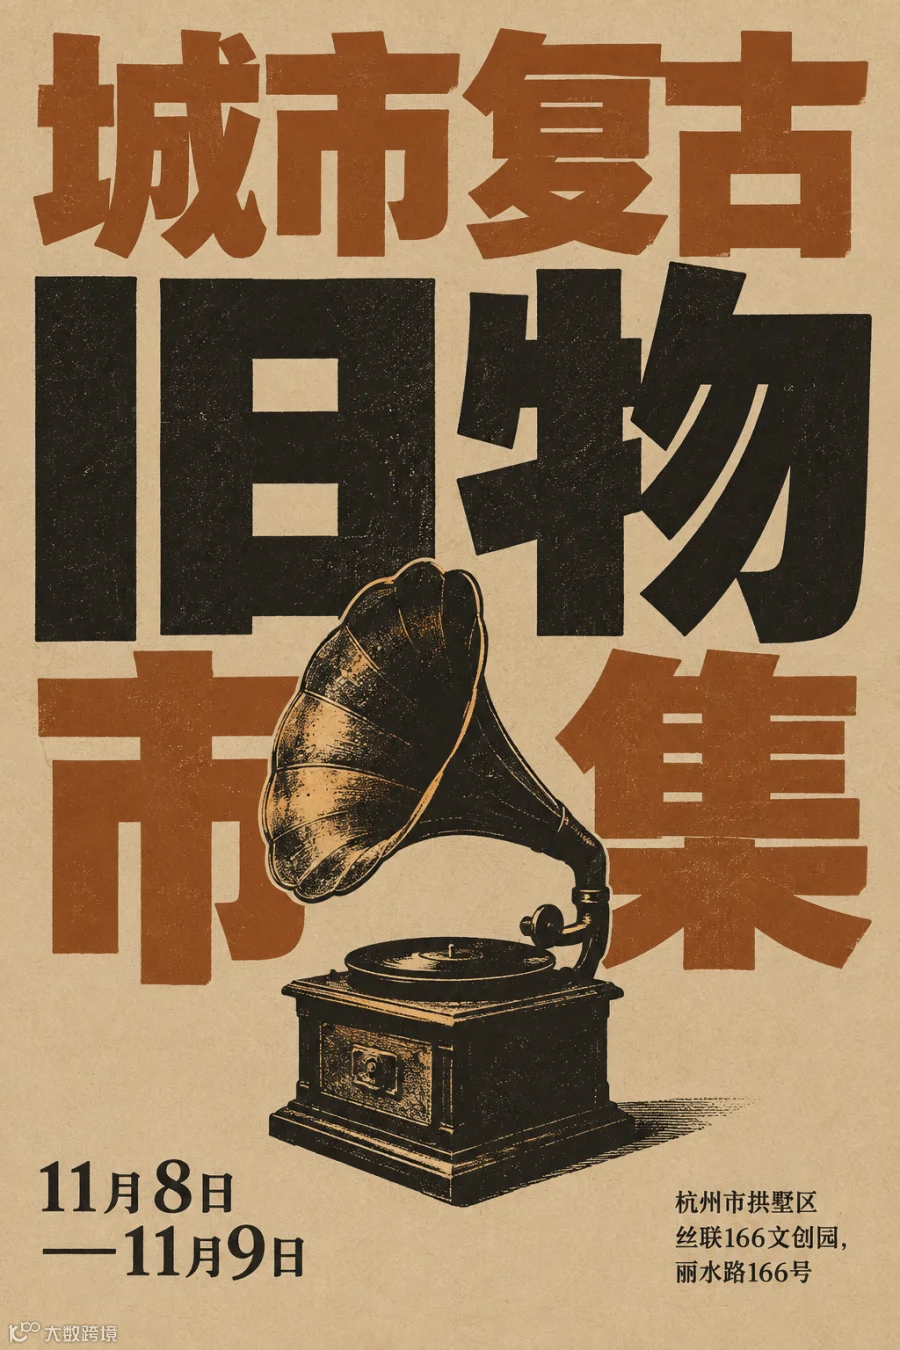
GPT Image 2.5 最值得关注的,不只是画质,而是它开始能接住用户的下一句话:先做一张图,再换色、删元素、加内容、继续替换,并尽量保留前面的成果。
它还不是像素级编辑工具,也不能替代专业软件在矢量、印刷、精确排版和品牌系统设计上的控制力。但在概念设计、快速出稿和重复返工中,它已经可以充当高效的设计协作助手。
上一代主要解决“帮我生成一张图”,2.5 开始认真解决“帮我把这张图做完”。这正是 AI 生图,从一次性出图,走向可返工、可迭代的完整设计工作流的关键转变。