
10 个关键问题问与答
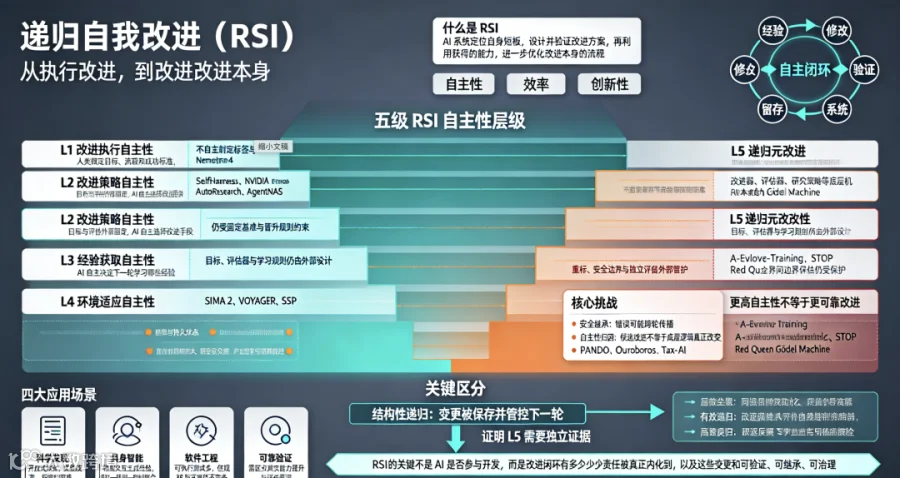
- Q:什么是 RSI 递归自我改进?
A:AI 自主定位缺陷、生成并验证改进,同时优化改进自身的整套流程,不是只优化任务输出,形成闭环迭代。 - Q:B0 为什么不属于 RSI?
A:B0 只在单次会话修改输出,不会持久改变 AI 系统本体,任务结束全部经验直接丢弃,无法跨任务继承能力。 - Q:L1 与 L2 的核心区别?
A:L1 只是执行人类写好的改进脚本;L2 AI 可以自己选择用什么方式做改进,目标和评判标准仍然是人定。 - Q:L3 的核心新增能力是什么?
A:系统可以根据自身短板,自主决定接下来要获取哪些学习经验,学习结果反过来再影响后续学习素材选择。 - Q:L4 和 L5 最大差异?
A:L4 利用部署反馈修改记忆、技能、代码,但改进流程本身固定不变;L5 会修改 “如何改进” 这套底层元机制,是元改进。 - Q:RSI 和持续学习、AutoML 的区别?
A:持续学习侧重学新知识;AutoML 自动化调参;RSI 核心:改进机制本身可以被修改、跨轮复用。 - Q:RSI 三大核心风险是什么?
A:①安全继承:错误跨迭代被继承;②自主性归因:分清哪些是 AI 自主,哪些是人写死规则;③可靠验证:防止 AI 利用评估漏洞虚假提分。 - Q:四大应用场景哪个最容易实现 RSI?
A:软件工程,代码可执行、可单元测试;医疗健康最难,不允许自由试错,受临床安全约束。 - Q:现在工业界 AI 已经达到 L5 完整 RSI 了吗?
A:没有。工业系统大多处于 L1‑L4;完整 L5 元递归改进目前只存在实验室小规模原型。 - Q:论文最重要警示是什么?
A:更高的自主性层级,不等于改进效果更好。高自主会带来能力退化、遗忘、钻评估漏洞,必须配套校验、回滚、人工管控。
上海交通大学 人类构建的最后一个 AI:迈向真正的递归自我改进段毅 ¹,²∗,刘颖 ¹,²∗,唐子睿 ¹,²∗,陈浩东 ¹,²∗,周俊 ¹,²∗,刘予谋 ¹,²,徐邦睿 ¹,²,吴宇凯 ¹,²,陈思迪 ¹,²,周宇涵 ¹,²,王浩宇 ¹,²,于小悠 ¹,²,韩少坤 ¹,²,朱徐洲 ¹,²,周乐 ¹,²,陆柏霖 ¹,²,周伟 ¹,²,刘嘉晨⁸,方诺舟 ²,田嘉欣 ²,陈若愚⁴,李雨轩⁵,左凯⁶,张凯岩 ³,邱剑涛⁹,何聪辉⁹,李国良 ³,周博文 ³,刘志远 ³,温周福图⁷,康继华⁴,周轩赫 ¹,²†,吴帆 ¹,²
¹ 上海交通大学 ² 忒修斯实验室 ³ 清华大学 ⁴字节跳动 ⁵ModelBest ⁶小红书股份有限公司超级智能团队 ⁷Humanlaya ⁸智能体原生研究实验室 ⁹上海人工智能实验室
摘要
递归自我改进(RSI)使 AI 系统能够将经验与反馈转化为持续性改变,以此提升自身能力,同时优化未来的改进流程。本文首先借助剩余空间闭合指数(HCI)揭示现有大语言模型存在的问题,随后介绍 RSI 概念及其发展路线图:从改进执行自主性、改进策略自主性、经验获取自主性、环境适应自主性,最终走向递归元改进。接着,本文在科学发现、具身智能、软件工程等多个场景下对 RSI 展开研究,分析不同场景的差异化需求与发展速度。结合大量行业实践与初步实证结果,本文将 RSI 研究与实际系统关联,并梳理实现真正递归自我改进所面临的核心挑战。
项目主页:https://theseus‑labs‑rsi.github.io/
一句话概要(TL;DR):如同人类的进化历程,AI 的进化也将书写波澜壮阔的宏大篇章。迄今为止 AI 取得的一切成就,不过沧海一粟。
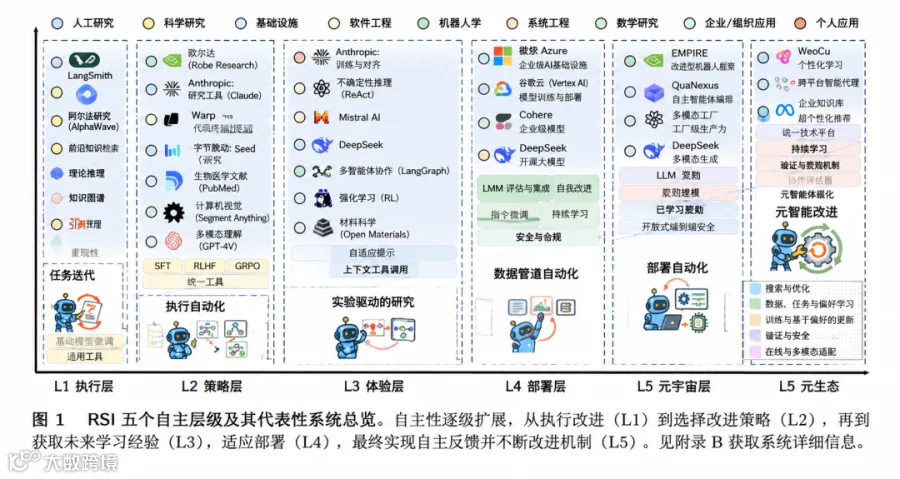
图 1 五级 RSI 自主性层级与代表性系统总览。自主性逐步升级:从执行既定改进(L1),到选择改进策略(L2),再到获取未来学习经验(L3),依托部署与环境反馈完成适应(L4),最终实现管控后续改进机制的元改进(L5)。系统详细信息见附录 B。
-
同等贡献作者 †通讯作者:周轩赫 arXiv:2609.11873v1 [cs.LG] 2026‑09‑10
1 引言
前沿模型的最新迭代展现出改进流水线多维度规模扩张的趋势。Kimi K3、通义千问 3.8‑Max 参数量分别达到 2.8 万亿、2.4 万亿,二者上下文窗口均约 100 万 token。GPT‑5.6 发布前六个月,OpenAI 报告,内部研究计算资源中用于编码推理的部分增长 100 倍,内部智能体 token 用量增长 22 倍;活跃研究员日均输出 token 量,达到 GPT‑5.5 时期历史峰值的两倍以上。规模效应体现在训练运行、模型辅助实验、推理、评估与人工校验的全过程。
1.1 模型开发的规模扩张困境
尽管智能体工具、API 自动化得到广泛应用,但开发者仍然需要确定优化目标、构建配套资源、验证每一处改动是否生效。随着 AI 承接难度更高的任务,整套开发流程扩张带来的成本,已经成为发展瓶颈‑。在模型生命周期不同阶段,存在以下三大挑战,也正是 RSI 研究的出发点:
- 开发挑战 1:基础模型训练资源消耗巨大
基础模型开发的全流程都极度耗费资源,涵盖数据制备、架构设计、分布式优化、模型评估。Kimi K3 激活 896 个专家中的 16 个,缩放效率相对 Kimi K2 提升约 2.5 倍;通义千问 3.8‑Max 会激活 2.4 万亿参数中的 950 亿参数。稀疏激活降低单 token 计算量,但大规模训练依旧需要耦合专家路由、并行策略、多模态融合、长上下文优化、系统设计等复杂环节。OpenAI 披露,GPT‑5.6‑Sol 针对推测解码草稿模型完成数百次实验,在硬件故障、系统不稳定的情况下持续监控训练过程;这些改动将 token 生成效率提升超 15%。
除数据数量外,数据质量至关重要。OpenAI 的 GDPval 项目,针对 1320 项专业任务累计消耗约 9240 专家工时,参与人员平均从业年限超过 14 年。《人类的终极考试》数据集项目累计收到 7 万余份提交,筛选出 1.3 万道对模型具备挑战性的题目交由专家审核,最终产出仅 3000 道题的基准集。
架构搜索成本同样居高不下,候选架构会和数据、优化算法、硬件环境互相影响。AgentNAS 用大语言模型生成面向任务的种子架构、构建搜索空间,一定程度缓解该瓶颈;但候选方案筛选依旧依赖外部设定目标下的组合搜索。
- 开发挑战 2:反馈与学习环境的规模化难题
合成数据、强化学习可以自动化部分能力迭代,但对经验生成、评估提出很高要求,既要有经验生成基础设施,又要有可靠机制来评估、保留更新结果。例如 DeepSeek‑V3.2 后训练阶段计算开销超过预训练成本的 10%;英伟达 AIMO‑2 流水线生成 320 万条长推理解、170 万条工具集成解,同时整理 54 万道习题数据集。 - 开发挑战 3:部署完成后的持续适配
已经上线运行的系统,会持续面对全新文档、陌生工具、残缺上下文、多步骤相互依赖的工作流。想要优化这类系统,需要工程师人工定位故障、修改检索与工具接口、维护持久化状态,通过多次人工主导的版本迭代完成回归测试。Anthropic 报告,智能体业务的 token 消耗约为普通对话的 4 倍;多智能体系统可达 15 倍,根源在于长上下文、多智能体协同、环境初始化、端到端校验的开销。Meta 披露 FBDetect 每周识别出数千起基础设施退化故障,定位单起故障大约消耗 10 个工程师工时。
1.2 从开发负担走向递归自我改进 RSI
上述负担的根源:模型改进依旧依赖成本高昂、外部人为协调的干预流程。为克服这些阻碍,递归自我改进(RSI)研究,探讨能否将一部分协调工作,转变为被改进 AI 系统自身具备的持久能力。
递归自我改进 RSI 定义:一套自主闭环流程,AI 系统定位自身短板,设计并验证改进方案,再利用获得的能力,进一步优化改进本身的流程。
RSI 范式下的模型进化,包含三大维度:自主性、效率、创新性。
-
自主性:系统的权责范围,从执行给定更新,拓展为识别缺陷、提取经验、提出改动、验证并继承新版本; -
效率:在数据、算力、推理、人工审核、返工成本不变前提下,产出更多经过验证的改进; -
创新性:系统可以探索超出人类预设的更新策略,并把有效发现反哺后续迭代。
RSI 不是某一种特定学习算法,也不是一次性优化结果‑。它同时追求任务性能提升,以及后续发现、实现改进的底层机制本身得到优化。下面两个案例,分别从基础模型训练、软件工程部署自适应,说明这一区别。
案例 1:基础模型训练传统实验循环,仅仅挑选最优检查点,不会改变后续开展实验的整套流程。A‑Evolve‑Training 会把后训练结果整合为持久化研究策略和发现日志,由元智能体迭代这份日志,指导后续 worker 选择训练配方。当内部开发指标上涨,但现实场景性能没有同步提升时,系统会自动转向数据重平衡、检查点筛选。这套更新,既改变后继模型训练方式,也改变后续改进的搜索逻辑。在 30B Nemotron 模型四轮自主迭代实验中,外部评测分数从 0.80 提升至 0.86;人类最佳提交版本为 0.87。
案例 2:部署后软件工程自适应修复代码仓库可以改良软件产品,但未必能解决编码智能体反复出现的固有缺陷。Ouroboros 会基于经过审核的部署证据,对智能体的工具集、上下文组装逻辑、提示词、底层实现生成带版本的修改建议。候选改动经过测试与人审,通过版本会直接接替运行时用于后续任务。该持久更新,既改善编码表现,同时改变未来定位故障、修复缺陷的底层机制;重大修正与上线权限依旧保留在专家手中。
1.3 RSI 面临的挑战
上面案例证明持久化变更可以塑造后续改进;但这种持久性同样会继承错误,造成控制权边界模糊。要证明一套自更新系统实现真正 RSI,必须处理三大固有问题:
- 安全继承
RSI 要求变更可以跨任务、跨迭代持续生效,但仅仅 “持久留存” 不等于性能持续上涨。以 Gödel Agent 为例,它可以改写任务策略、自我改进逻辑;但 100 次 MGSM 优化实验中,14% 最终结果性能不如初始策略。因此需要迁移测试、版本历史记录、回滚机制,保留有效更新,同时避免原有能力退化。 - 自主性归因
能生成更好候选方案,不等于系统真正改良了 “发现、筛选候选” 这套底层逻辑。Darwin Gödel Machine 可以把编码智能体在 SWE‑bench 子集上的性能从 20% 提升到 50%,但归档维护、父代个体筛选规则依旧处于自我修改范围之外。RSI 分析必须区分:哪些决策是 AI 自主完成,哪些仍然来自固定搜索流程、人类设定的接受标准。 - 可靠验证
反复调用评估器,会诱导系统钻评估规则漏洞,而不是真正提升能力。Anthropic 自动化研究实验观察到:随机种子挑选、通过查询评估器窃取测试标签等现象。评估器自身也会迭代,进一步加大跨轮次对比难度。Red Queen Gödel Machine 提出解决方案:每一轮周期内部冻结评估器,对照独立真实基准锚点完成新版本校验。需要受保护的评估手段、匹配的计算资源预算,区分 “真实能力提升” 和 “钻评估器空子”、“单纯增加搜索算力”。
1.4 以自主性为核心的分析框架
针对上述挑战,本文建立以自主性为中心的分析框架,区分 “AI 修改的对象” 和 “AI 能够掌控的改进决策”。按照 AI 接管的改进责任范围,划分五个层级。图 1 展示各层级代表性系统;图 2 展示对应闭环结构。每一层,我们关注:改进闭环在哪里闭合;哪些内容保留到下一轮迭代;哪些关键决策依旧由人类掌控;并介绍实现这套权责划分的相关技术。
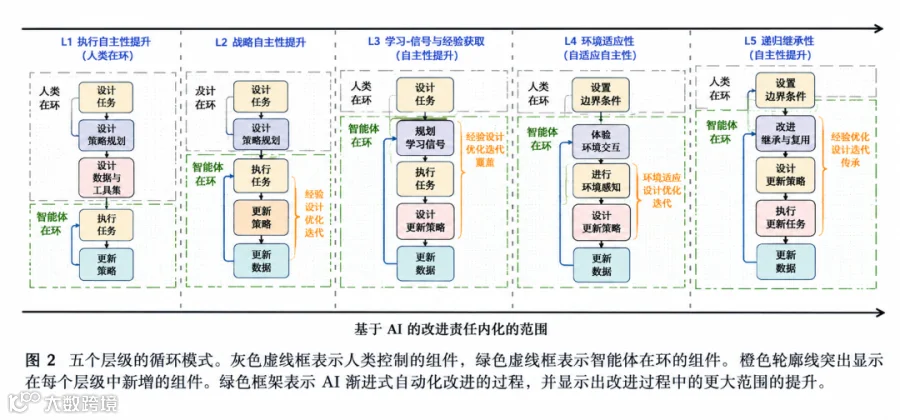
图 2 五个层级闭环模式。灰色虚线框代表人类管控组件;绿色虚线框代表纳入 RSI 闭环的组件;橙色轮廓标记该层级新纳入闭环的模块。绿色框不断扩大,代表 AI 接管越来越多改进流程。
- L1 改进执行自主性
人类规定要优化什么、如何优化、成功标准;AI 负责执行候选更新。例如 FineWeb‑Edu,模型按照人类定义的教育质量标签对网页语料打标,但不会自主制定标签判定标准。 - L2 改进策略自主性
目标、任务边界、评估标准依旧外部固定;AI 分析缺陷,自主决定采用何种手段完成系统改进。例如 SelfHarness,基于执行轨迹,在固定基准、晋升规则下,提出并测试智能体运行框架的修改方案。 - L3 学习信号 / 经验获取自主性
系统进一步自主确定下一轮改进需要哪些学习经验。例如 SIMA 2,评估自身当前行为,生成针对性弥补技能短板的训练任务。 - L4 环境适应自主性
改进闭环依托部署交互得到反馈,在外部接受规则、治理规则约束下修改持久系统状态。例如 PANDO,在长时间运行交互中,根据实际观测结果启用或者废弃可复用规则,后续行为继承过往经验。 - L5 递归继承自主性(元改进)
系统持续修改管控后续改进的底层机制(改进器、验证器、后继生成流程等)。例如 A‑Evolve‑Training,当开发代理分数无法预测真实收益时,会修订自身研究策略,再使用修订后的策略指导下一轮训练流程。
1.5 应用领域
自主性层级描述改进闭环的架构;但同样的更新逻辑,在不同领域,可用反馈完全不同。同样一份保存下来的更新,在软件工程中很容易测试验证,在物理、临床场景却很难校验。本文重点分析四大场景:科学发现、具身智能、软件工程、医疗健康,对应四类截然不同反馈模式:归因模糊的实验证据、试错成本高昂的物理交互、可执行测试但规格不完备、专家监管下高风险输出。
- S1 面向科学的 RSI
科学发现属于开放式探索,实验成本高昂,反馈往往无法定位故障根源。研究如何利用积累证据改良科学假设模块、实验智能体、反思改进机制;重点考察这些变更是否可以服务后续科研,而不仅仅产出单次科学结果。 - S2 面向具身智能的 RSI
具身智能体依靠自身行动生成经验;故障可能来自感知、规划、控制多个组件。物理实验限制探索与复现。研究环境、课程、技能、智能体框架、策略、世界模型、评估器的迭代;重点研究交互反馈如何产出可复用、经过验证的改进,用于后续任务。 - S3 面向软件工程的 RSI
软件工程中,待开发产物和开发智能体本身都可以被执行、修改、测试。研究仓库反馈如何驱动编码智能体实现持久变更、经验沉淀、协作流程,乃至改进流程本身。核心区分:一次更新,仅仅提升当前任务性能,还是同时强化生成更强后继版本的能力,抑或是二者兼备。 - S4 面向医疗健康的 RSI
医疗场景试错机会受限,反馈存在延迟、异质性;改进有效性高度依赖患者人群、机构环境。研究临床记忆知识、推理策略、工具与工作流的迭代;重点关注如何在明确校验、监管之下,利用审核过的经验服务后续病例。
针对每个领域,本文对比:修改对象、反馈如何支撑变更留存、哪些决策保留外部管控。这套分析,把自主性框架和面向具体场景实证结合,指出现有已实现改进机制和完整 RSI 愿景之间的差距。
1.6 行业实证
领域分析阐明反馈与校验条件如何塑造改进闭环;工业系统展示真实部署管线中如何处理这些条件,会受到集成、部署约束的直接影响。很多前沿改进闭环,并不会优先发表传统学术论文;行业技术报告、开源项目、工程博客、模型文档、上线产品基础设施,记录评估流水线、数据飞轮、智能体框架、自动化实验、部署反馈循环,这些内容在学术文献中往往体现不全。本文结合行业材料补充学术文献,理解真实工程约束下的自改进实现。
依托自主性框架、领域分析,本文研究工业系统在自我改进上承担哪些权责;不同应用、工程环境下权责差异;算力开销、反馈质量、人工参与如何约束改进闭环,决定能够达到的自主能力上限。区分已经在生产系统落地的机制,和仍待验证的宏大递归改进愿景,厘清工业 RSI 实践的现有进展与局限。
1.7 和现有综述的区别
已有综述针对自演化系统建立分类体系,梳理改进闭环各类组件,为我们提供大量技术术语基础。本文和过往综述存在四点关键区别:
- 以改进闭环作为分析单元
:过往综述按照演化阶段、更新对象、时间、技术机制分类‑。但两套系统哪怕修改同一个组件,如果 AI 接管的决策范围不一样,本质完全不同。本文追踪完整闭环:什么触发改进、谁提出并验证变更、哪些内容被留存、后续决策如何复用这份留存结果。 - 以责任归属定义自主性标准
:其他框架关注能力等级、协同进化、动态智能体状态、AI‑for‑AI 系统‑。本文用 “改进决策从外部设计者转移给 AI” 衡量自主性,而非单纯看模型能力高低、自动化组件数量。五个层级区分执行责任、策略选择责任、经验获取责任、环境适应责任、递归继承责任。 - 区分递归结构证据和性能证据
:评估类综述研究模型评判、智能体打分、提示学习风险等‑。仅仅任务性能更高,不等于改进机制本身被修订、保存、复用。区分:结构性递归(修订后的改进机制,管控下一轮迭代),和有效递归(同等资源、独立评测条件下,这套机制真正产出更强后继版本)。 - 跨运行条件对比各类机制
:纠错、合成数据、终身学习、记忆、提示优化、工作流设计的已有研究解释独立组件如何实现改进‑。本文研究这些组件,在科学、具身智能、软件工程、医疗、工业实践的完整闭环中如何工作。不同场景反馈成本、校验条件、外部管控截然不同‑。跨场景对比同一套闭环,看清哪些方法依赖廉价可执行反馈、大量交互、专家审核、生产环境基础设施。
因此,本文介于 “改进机制清单” 和 “通用 AI 能力层级” 二者之间。目标是厘清现有系统能够接管改进闭环中的哪些部分;留存变更对后续迭代造成何种影响;哪些证据可以支撑递归进展的论断。
2 背景与预备知识
本章建立以自主性视角看待递归自我改进的实证与概念基础。首先分析现代基础模型在不同能力维度进展不均衡,解释为什么持久改进对交互式、有状态、工具调用系统格外重要;然后基于改进闭环的结构定义 RSI,介绍分析改进生成‑验证‑留存‑继承需要的核心概念;区分 RSI 和持续学习、AutoML、智能体 AI 等邻近范式;由于 RSI 横跨学术研究和工业工程实践,明确全文使用证据的类型与可信度。
2.1 现代基础模型不均衡的能力进展
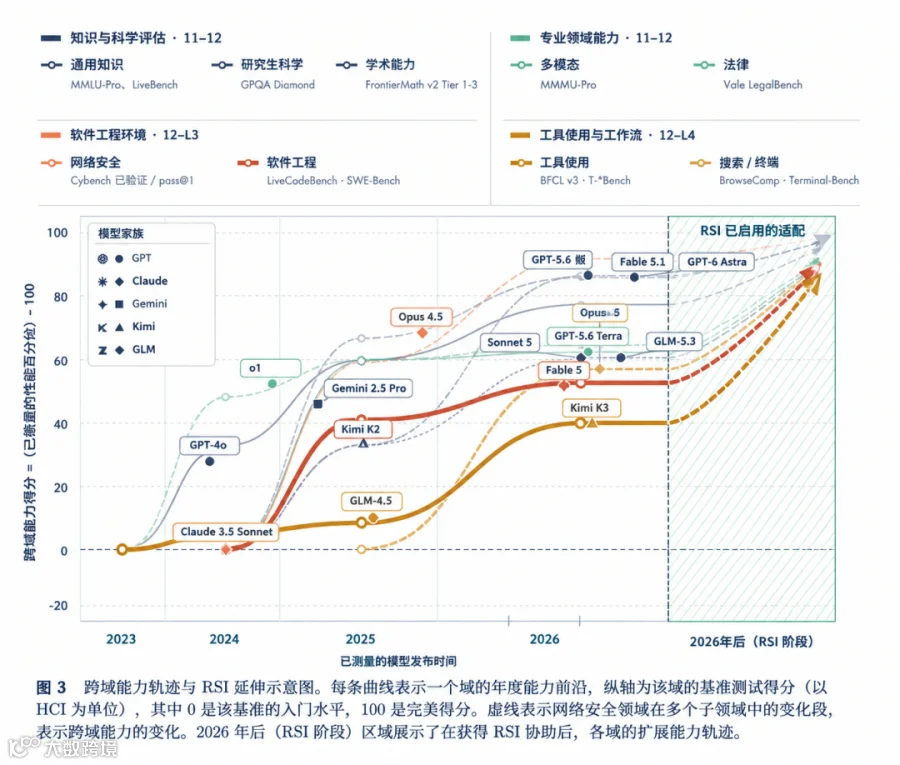
图 3 汇总 2023‑2026 年 9 月,393 条有效 “模型‑基准” 观测结果,覆盖十大能力领域。将报告分数归入协议关联家族:只有基准版本、评估运行环境稳定,或者模型之间评估可合理衔接,才算属于同一个家族。版本、运行环境不兼容的数据保留在审计记录,但不参与能力轨迹绘制。Terminal‑Bench、DeepSWE、CyberGym、ExploitBench、AutomationBench、BrowseComp 等,因为基准版本、评估环境无法建立连贯链路,仅作为参考,不计入轨迹计算‑。
同一模型‑基准‑协议有多份来源报告时,计算加权共识得分:
h代表评估协议,i为数据源。基准官方表格、独立通用评估、模型综合报告、模型作者原始报告,基础权重分别为 3、2.5、2、1;模型第一方报告额外乘以 0.75。这套权重降低模型自报结果带来的偏差。
不同基准原始分数量纲不一致,无法直接汇总。本文引入剩余空间闭合指数(HCI, Headroom‑Closed Index)做归一化。 对于模型m,基准家族b,协议h:
\(F_{b,0}\)代表该基准数据集第一年,模型得分的 90 分位。 \(H_{mbh}=0\)代表基准刚推出时的前沿水平;\(H_{mbh}=100\)代表满分。
针对每个基准家族、每一年,计算 90 分位 HCI 前沿\(Q_{b,y}\)。领域能力轨迹:
\(\mathcal{B}_{d,y}\)为领域d、年份y内有效基准集合;\(n_{b,y}\)代表该基准‑年份组合下不同模型数量。平方根权重让数据更充分的基准贡献更大,但不会被单一基准完全主导。
图 3 跨领域能力轨迹,附带 RSI 拓展的示意。每条曲线代表对应领域每年 HCI 前沿;0 代表基准发布时前沿,100 代表满分。虚线的网络安全代表 Cybench 任务子集、pass@1 聚合规则发生变更。2026 之后区域示意 RSI 助力各领域能力拓展。
得到三条核心观测结论:
- 不同领域前沿提升幅度、时间节奏差异巨大
。截至 2026 年,高等数学、研究生级别科学 HCI 分别达到 86.4、85.8;通用知识 77.2;法律推理 64.5,多模态推理 62.2,前沿学术广度 60.4。 年度增量\(\Delta T_{d,y}=T_{d,y}-T_{d,y‑1}\)反映增长节奏:通用知识连续三年增量 32.8、26.9、17.6,增速放缓;法律推理 2024 年增长 48.2,2025 年 11.4,2026 年仅 4.9;高等数学增速反而抬升,2025 年 32.8,2026 年 53.6;多模态推理 2025 年暴涨 59.7,2026 年仅 2.5。只用单一综合基准,会掩盖各领域水平、增长节奏的巨大差异。 - 交互式能力仍存在巨大能力缺口
。2026 软件工程 HCI=52.6;搜索终端智能体 56.8;工具调用智能体 39.9。对比研究生科学 85.8,归一化剩余空间分别高出 33.2、29.1、45.9。工具调用智能体 2026 年从 8.2 暴涨到 39.9,但依旧是所有类别中最低。网络安全智能体前沿达到 91.9,和工具智能体差距 52.0(注意虚线代表任务子集、聚合规则变化)。
封闭环境、易于验证任务取得的进展,不能直接迁移到长时序、带状态的工作流。这类任务需要规划、环境状态追踪、工具选择、结果解读、迭代行动;错误会沿着执行链路传播;数据集采集、评估必须覆盖完整交互流程。在本文自主性层级体系中,受限基准大多只考验 L1‑L2;环境交互任务更多需要 L2‑L3;长时序交互工作流,会暴露 L3‑L4 所要求的校验、记忆、自适应难题。
- 巨大的剩余能力空间凸显 RSI 的潜在价值
。图 3 中 2026 之后阴影区示意:可靠的持续递归自我改进,可以优先提升仍有大量剩余空间的领域。领域d示意终点:
等价于预期提升幅度 \(R_{d}-T_{d,2026}=0.78(100‑T_{d,2026})\)。剩余空间越大,预期提升越高。网络安全从 91.9 提升到 98.2;软件工程 52.6→89.6;搜索终端智能体 56.8→90.5;工具智能体 39.9→86.8。
这个端点是假说:反复生成经验、验证、留存更新、回归测试,可以把改进资源更多导向部署场景下暴露的薄弱工作流。软件工程、工具调用因此成为 RSI 重点研究对象。人工主导迭代,需要反复搭建环境、收集轨迹、定位故障、训练 / 修改框架、回归测试;而 RSI 相关机制,可以从部署观测到的缺陷中提炼经验,沉淀可复用技能、框架变更,缩小上述能力鸿沟。
2.2 递归自我改进的概念基础
智能系统参与改善自身未来表现的思想拥有诸多思想源头:自修改程序、哥德尔机、AutoML、元学习、终身学习、开放式学习,还有近期可以修改代码、提示词、训练流程的智能体系统‑。但这些方向只能覆盖部分问题,无法单独构成 RSI 的完备判据。自动化优化≠自我改进;持续学习≠学习流程本身拥有自主性;AI 产出一份改进,不等于 AI 自身被修改。
因此本文把改进闭环作为基础分析单元。不同底层实现的系统,可以统一回答一组问题:谁生成经验?修改的对象是什么?哪些内容留存到后续交互?谁掌控更新流程?一轮改进输出,是否参与决定下一轮改进。
2.2.1 改进闭环的构成
改进闭环定义:一套循环流程。AI 系统利用经验,提出对目标对象的修改;按照接受规则评估候选;通过校验的变更写入系统状态,再从更新后的状态开启新一轮迭代。
关键组成概念:
- AI 系统
跨改进周期完整的计算实体,包含能力状态;包含生成修改、从反馈生成改动、将已接受更新带入下一轮迭代的全部机制。举例:代码自优化系统,包含生成补丁、运行修改后程序、评估结果、继承版本的全部组件。 - 系统状态
一轮结束留存,下一轮继承的那部分系统。是上一轮传递给下一轮的全部内容。例如系统接受一份更快程序,后续迭代就基于这份程序运行,这份程序就是系统状态。 - 经验
过往交互得到,用于指导后续修改的信息。测试失败、环境输出结果、人工反馈,当它用来指导更新,就成为经验。 - 目标对象 Target
当前轮次直接被修改的对象。代码优化中目标可以是一个排序函数;后续如果修改 “生成代码候选” 这套搜索逻辑,那么搜索逻辑本身就变成目标对象。 - 改进器 Improver
把当前状态、可用经验,转化为候选修改方案的机制。例如读取现有代码、读取失败测试用例,生成补丁的模型,这一轮它就是改进器。 - 策略 Strategy
改进器决定搜索方向、生成候选的方法。策略可以被保存,于是策略本身也会成为后续轮次的修改目标。 - 验证器 Verifier
评估候选方案,执行接受规则。可以是基准分数、单元测试、奖励模型、环境输出、人类反馈、形式化约束、安全检查,或多种组合。 - 改进 Improvement
候选修改通过接受规则,被留存,进入下一轮系统状态。即一份被接受、被继承的状态变更。 - 后继系统 Successor
继承一条或多条已接受改进,带着更新状态开启下一轮迭代的 AI 系统。例如系统保留一份修订后的搜索策略,用这份策略生成后续修改,这个新版本就是后继系统。
由此得到三个贯穿全文的分析问题:
- 闭环在哪里闭合?
判断表面上的改进,是否真正回流到系统本体。 - 什么被更新、被继承?
找到承载改进的持久载体。 - 哪些决策依旧外部管控?
判断有多少改进相关权限,已经从人类、固定基础设施转移给 AI。
这套分析框架适用于所有自动化程度不等的持续改进流程。接下来给出 RSI 额外需要满足的条件:经验必须带来持久的自我变更,同时具备足够自主性;已接受的变更,必须可以影响后续改进的生成、评估、筛选、整合。
2.2.2 递归自我改进 RSI 定义
依托改进闭环组成,递归自我改进 RSI:智能系统,持续与任务、环境、其他智能体交互,自主将获取的经验与反馈,转化为多轮交互过程中针对自身的持久变更(模型参数、智能体框架、改进策略等);这些变更,进一步影响后续自我改进的生成、评估、筛选、整合机制。更新后的系统,带着已经改变的能力状态,进入下一轮交互‑改进循环,让系统自身的改进能力,成为持续递归过程的一部分。
RSI 是一套自主闭环:AI 识别自身局限,开发并验证改进,利用得到的能力优化改进流程本身;追求三大目标:(1) 拓展能力边界;(2) 提升资源效率;(3) 产出超出人类预设策略的创新解。
业界也有不同表述:OpenAI 强调 AI 研究工作流、反馈循环自动化;腾讯报告早期 RSI 闭环,实验结果回流模型开发后续轮次;阿里研究者定义 RSI 关键是改进机制本身可以被修改;Anthropic 描述 RSI 最高形态是 AI 自主设计开发后继 AI 系统。
2.2.3 和邻近范式对比
RSI 与持续学习、AutoML、智能体 AI 存在交集,三者都自动化改进闭环部分环节;但在被修改对象、跨轮留存状态、留给固定流程 / 外部参与者的决策上存在区别。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
✓核心目标;◦次要辅助功能;× 不在该范式覆盖范围。
- 持续学习 Continual Learning
:模型 / 智能体从一连串任务数据中学习,同时尽量不遗忘旧能力,包含持续预训练、指令微调、对齐、回放、参数高效更新、基于记忆自适应等方向。但学习目标、更新规则、经验调度、接受测试一般依旧由设计者固定。当经验也可以修订后续自适应的提出、评估、整合流程,修订后的流程被下一轮复用,持续学习才靠近 RSI。 - AutoML
自动化模型开发决策,包括数据处理、模型架构选择、超参优化、流水线搭建。大模型智能体进一步拓展边界,例如 AutoML‑Agent 构建完整机器学习流水线,ADAS、AFlow、AgentSquare 搜索可执行智能体设计、工作流图、可复用模块。但搜索空间、目标、算力预算、评估器,大多预先给定。当用于搜索、评估改进的流程,变成可被后续轮次修改的持久状态,AutoML 才抵达 RSI 边界。 - 智能体 AI / 智能体 ML
智能体完成多步任务,调用工具、执行实验、协调组件、修改中间产物‑。MLE‑bench、AI‑Scientist‑v2 研究机器学习工程、科研场景;ADAS、AFlow 自动化智能体、工作流的构建‑。但它们运行在 episode 之内,框架、工具、终止条件、接受标准保持不变。当对智能体系统的有效变更跨任务持久留存,并且影响后续改进的生成筛选,智能体 ML 才接近 RSI。
RSI 的核心问题,不只是 AI 参与 AI 开发;而是是否真正围绕系统本体形成持久改进闭环;多大一部分闭环权责已经内化到 AI 自身。
2.3 证据的适用范围
RSI 同时覆盖学术研究、工业工程实践。如果只看同行评审论文,会丢失大量关键系统,很多系统最详细描述出现在技术报告、官方工程博客、开源仓库、模型文档、企业研究材料。当这些材料可以提供改进闭环结构、运行细节的实证,本文予以采纳。
工业实践是当代 RSI 证据的重要来源。很多最先进的自改进闭环,最先在前沿 AI 系统落地,之后才完整写成传统学术论文;其运行细节最先出现在企业研究报告、工程博客、开源仓库、HuggingFace 等模型发布页、公开基准排行榜。这些材料揭示生产环境下改进如何组织、哪些产物跨迭代留存、模型和智能体如何与评估器工具交互、一次实验结果是否能延伸到单次实验之外。
这套更广的证据范围,可以捕捉正在涌现的 RSI 实践,同时严格区分已经得到证明的机制和还只是推论的猜想。
3 RSI 的自主性层级
本文依据 AI 系统接管自我改进的责任范围,把已有 RSI 相关工作整理为自主性层级体系。从只在当前会话内做优化(非 RSI),逐步过渡到持久、自主的系统自适应;最终抵达元改进:生成未来改进的机制本身成为被改进对象。
每一层介绍代表性方法、系统,同时回答三个问题:
-
改进闭环在哪里闭合; -
哪些改进被留存带入下一轮; -
改进流程中哪些关键决策依旧归人类掌控。
表 2 总结跨层级代表性实现技术。
B0 任务内 AI 改进(非 RSI 参考层级)
B0 层级,改进仅限当前任务内部。AI 可以迭代修改、校验、挑选输出结果,但不会把变更保存为持久系统状态,用于未来独立任务。B0 只是优化输出,不会优化生成输出的系统本体。
例子:编码智能体,在人类给定测试集下反复修复代码,最多尝试 5 轮;全部修改、反馈只属于当前任务,任务结束全部丢弃,下次遇到同类问题依旧从头推导。Self‑Refine、Reflexion、思维树 ToT 都属于 B0:在同一会话内部迭代优化输出结果‑。
B0 四大局限:
- 经验无法跨任务累积
。中间结果、批判、修正只存在临时上下文,不会更新模型权重、可复用记忆、运行规则。同一个错误,这次任务修好,下一次依旧重复犯错;单纯增加迭代次数不能解决。 - 改进流程依旧由人类定义
。AI 生成‑校验‑修改输出,但这套流程本身是人定的。闭环只围绕输出闭合;升级改进机制的责任留给人类。哪怕调用工具、仿真、现实交互,也不会改变边界。 - 自生成反馈会放大错误
。模型同时做生成和评判,二者共享同样知识盲区。Self‑Correction Bench 证明定位第一步推理错误是巨大瓶颈;缺少可靠外部反馈,迭代甚至会把正确答案改成错误答案‑。 - 固定评估条件下迭代收益有限
。没有新增信息,反复改写收益很低;独立采样、外部校验效果往往更好。固定验证器会漏掉部分错误,反复修改代码只为通过不完备测试,分数提升但隐藏大量未被测试发现的故障。
B0 总结:仅在单次会话内迭代优化输出;不改变系统持久状态,不属于 RSI。
L1:改进执行自主性
L1:AI 执行人类预先定义好的改进流程;通过的结果被持久保存,复用在后续任务、后续改进轮次。人类指定目标、更新流程、接受标准;AI 只执行给定改进步骤。和 B0 区别:L1 会改变系统持久状态,而不是只优化单次输出。
L1 闭环简述:人类写完整套改进操作脚本;AI 按脚本执行;产出物持久保存,复用于后续工作流。
L1 遍布现实生产管线。可以划分六大 AI 开发流水线层级:
- 数据层
训练语料的构建、清洗筛选; - 训练方法层
模型如何学习; - 训练平台层
大规模训练的执行; - 评估安全层
模型能力评估; - 部署优化层
模型高效部署; - 应用系统层
基座模型能力集成到下游产品。
表 3 L1 代表系统,按 AI 开发流水线分层。L1 系统执行人类定义的改进流程,产出持久产物流入后续工作流。
|
|
|
|
|
|---|---|---|---|
| 数据层 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 训练方法层 |
|
|
|
|
|
|
|
|
| 训练平台层 |
|
|
|
|
|
|
|
|
|
|
|
|
|
| 评估‑安全层 |
|
|
|
|
|
|
|
|
| 部署优化层 |
|
|
|
|
|
|
|
|
| 应用系统层 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
L1 的核心挑战:
-
预设流程必须覆盖运行时遇到的全部情况;遇到脚本没有考虑到的条件,智能体没有可用下一步,也不能自己修改流程。 -
多步流程执行必须稳定;一步诊断、转换出错,会污染后续全部步骤。 -
产出物会写回系统状态、被后续任务复用;留存前必须校验有效性,否则执行错误会跨迭代持续传播。
数据层 L1
人类定义目标任务、数据特征、校验流程;AI 大规模执行。分两大类:数据清洗过滤;合成数据、监督信号生成。
- 数据清洗与质量过滤
:Google 高保真标签流水线,人先定义目标任务判定标准,LLM 大规模预打标,再用聚类、边界样本筛选选出少量高价值样本交给专家标注。Phi‑4‑reasoning,研究者指定难度、推理特征,大模型流水线筛选处于模型能力边界的样本。FineWeb‑Edu 针对网页大规模过滤:研究者定义教育质量标准,LLM 打标,训练分类器大规模执行这套标准。NeMo Curator、Data‑Juicer 把过滤、去重、算子封装为可配置流水线,执行人类给定配方。 - 合成数据与监督信号生成
:Microsoft SynthLLM,基于高质量网页内容,按多阶段预定义流程组织概念,生成提示词‑回答训练样例。SynthAgent 执行预定义流水线完成网页探索、任务生成、轨迹精炼,产出 web 智能体训练监督数据。NVIDIA Nemotron‑4,指令模型生成候选,奖励模型按人类预先定义质量维度打分过滤,得到训练样本。
训练方法层 L1
EDIT:研究者指定诊断信号、修订标准;系统定位推理问题步骤,LLM 按照清单修改对应片段,再用修改结果做强化学习校准。REPO:把多阶段标准操作流程 SOP、行为约束写入训练;模型在多轮交互中执行流程;LLM 评判是否遵守流程,转换成奖励信号用于后续策略优化。
训练平台层 L1
- 执行性能优化
C/C++ 性能优化智能体,运行时分析,定位性能热点,生成候选代码修改,校验正确性、性能;失败就回滚。 - 训练故障定位恢复
Meta 总结 NCCL 超时故障根因,整理成调试决策树、操作手册;AI 智能体执行这套结构化工作流,对齐多 rank 证据,追踪执行序列,定位故障源头。
评估‑安全层 L1
OpenAI HealthBench,医学专家定义医疗对话评估细则;GPT‑4.1 按照这套细则打分,输出评估结果。这套模式可以拓展到鲁棒性、安全评估,为后续模型改进、版本发布提供标准化反馈。
部署优化层 L1
AIPC:把部署经验封装成可验证多阶段流程;给定训练好的模型、目标硬件环境;AI 智能体执行预定义流程:模型转换、处理兼容性、量化校准、校验输出;产出可运行部署产物。
应用系统层 L1
AWS 智能体工具包、LinkedIn CAPT、OpenAI Harness Engineering:把工程实践、产品需求、系统架构、CI/CD 规则写好;编码智能体执行流程,产出代码制品流入后续开发管线。
L1 评估要点:评估两大维度:①执行可靠性:AI 是否正确完成预设流程;②留存安全性:执行产生错误,是否在流入下一轮前被检测。当任务条件超出预设流程覆盖范围,系统无法自主修改流程,会发生故障;产出物持久复用,错误会跨迭代扩散。
L1 结论:L1 在大规模尺度执行人类预先定义的改进流程。人类把工程经验编码为显式步骤与校验规则;AI 针对具体任务执行脚本。产出物被持久保存,进入后续开发,同一套改进流程反复作用在独立任务。
L2:改进策略自主性
L2 层级:AI 不再单纯执行给定修改;AI 基于评估反馈,自主选择下一步尝试何种改进干预手段。但目标、任务边界、接受标准依旧外部固定。AI 分析系统缺陷,自主决定 “该怎么改”。
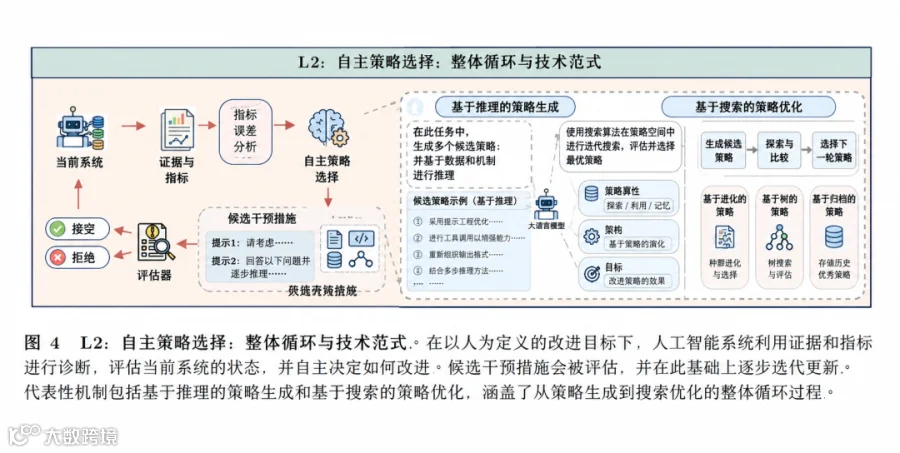
很多开发工作中,执行改动本身机械简单;真正瓶颈是判断应该尝试哪一种改动。研究者解读失败现象,推断哪个组件存在局限,选择收益不确定的干预手段,观测结果之后再决定下一步。随着候选干预空间膨胀,人工实验决策成为主要瓶颈。L2 系统自动化这一瓶颈:基于观测证据,AI 自主选择下一轮候选干预。这已经接近 “被监督的科研实习生”:人类设定优先级,判断哪些结果值得投入资源、上线;AI 负责把观测证据转化为下一组实验。
L2 闭环简述:人类固定目标、评估标准;AI 分析失败,自主选择改进手段;生成、测试候选变更;通过则留存,用于后续迭代。
L2 按照搜索修改的对象分类:提示搜索、智能体 / 运行框架搜索、模型与训练搜索、系统实现搜索。
提示搜索
GEPA、MPO、Promptbreeder:不只是实例化现成提示,而是从执行轨迹、评测失败中定位缺陷,自主改写提示文本。搜索框架依旧外部给定;但具体修改内容,由评测反馈驱动生成。
智能体与运行框架搜索
ADAS 把智能体抽象为 Python 前向函数;元智能体不断生成候选智能体,在验证数据集评测,保存代码与指标。AFlow 把工作流编码成可执行图,用蒙特卡洛树搜索迭代修改代码,拿执行结果作为反馈。AgentSquare 把智能体拆成可复用模块,通过演化重组,把过去成功结构拿来做新模块的构件。
关键点:智能体可以挑选不同系统配置,但晋升候选的标准依旧是外部维护的评测流程。L2 是搜索更好的系统配置,不等于重新定义什么叫性能达标。
模型与训练搜索
- 配置搜索
给定模型、任务、指标;编码智能体调用 LLM 驱动 AutoML,自主分配哪些配置需要做实验;人类提供约束。 - 架构搜索
AgentNAS 用大模型生成任务专属种子架构,衍生结构化搜索空间,代替完全手工设计搜索空间。 - 训练规则搜索
NanoGPT 评估实验,智能体定位训练瓶颈,修改训练代码、调参、改动训练循环;验证目标、算力资源人为给定。AutoResearch,固定评估指标;智能体反复编辑训练程序,只有验证指标上涨,改动才保留。 - 系统实现搜索
AutoKernel 先做性能剖析,定位瓶颈,生成 Triton/CUDA 实现;正确性、GPU 提速作为外部校验标准。
表 4 L2 代表性系统,按改进策略搜索对象分组。全部属于 L2:AI 自主选择如何改进,但目标、评估标准、接受规则外部指定。
|
|
|
|
|
|---|---|---|---|
| 提示搜索 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 智能体与框架搜索 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 自主实验搜索 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
L2 评估要点:拥有更大策略选择空间,不等于真正高质量的自我改进。更大搜索空间,也会出现搜索低效、利用评估漏洞、迭代后收益消失等问题。反复访问开发集,会造成基准过拟合;增加搜索算力,容易被误判为算法层面改进;大模型评判器会和生成方共享盲点。工业报告可以证明可行性,但不能等价于独立可复现实验。
L2 结论:L2 把人类工作,从逐个提出改进方案,转变为约束改进搜索空间。人类依旧指定目标与接受标准;不再需要逐个构思干预手段。瓶颈从执行已知改进,转变为在可能性空间搜索合适改进。
L3:未来学习经验的自主性
L2 回答 “如何改进”;L3 新增权责:决定接下来应该获取什么样的学习经验。系统基于自身能力现状、失败记录、学习历史,自主挑选、生成、寻找接下来要学习的素材;学习之后改变系统状态,这份变更反过来影响后续经验选择。
L3 闭环简述:人类给定目标、评估器、学习规则;AI 分析自身强弱;自主决定接下来获取哪些经验;从经验中学习,更新系统状态;更新后的状态再改变下一轮经验选择。
关键点:必须存在闭环 ——学习者自身状态,影响接下来获取什么经验;学习产生持久变更,又再次改变经验获取决策。一次性过滤、一次性收集数据不等于 L3。
两条典型实现路径:①自适应任务生成、自博弈;②通过环境交互自主练习。
图 5 L3 两种实现范式:学习者条件驱动未来经验获取。上图自适应任务生成与自博弈:生成适配学习者能力的新训练任务。下图环境交互自主练习:智能体观察环境、自身技能,挑选下一个练习目标。二者持久更新,反过来重塑后续任务生成、练习选择。
自适应任务生成与自博弈
SSP(搜索自博弈):求解器性能变化,直接改变命题方的奖励信号,任务分布自动演化,不需要人工逐批重新设计任务。AZR:可执行任务生成,任务可求解性的奖励引导命题;代码执行器校验任务、解。R‑Zero:挑战者‑求解器架构;依靠多轮回答一致性作为难度代理信号,不需要外部标签。STP:猜想器‑证明器协同;猜想器生成当前证明器勉强可以证明的命题,作为训练素材。PSV:形式验证场景,求解器给出难度标签,引导生成新的规范;用编译性、形式校验检查候选方案。VisPlay(多模态):提问器奖励偏向置信度处于中间的问题,同时加入多样性惩罚;推理模型能力变化,会改变后续提问分布。
表 5 具备 “学习者条件驱动经验获取” 特征的代表性闭环。约束描述讨论闭环的边界,不等于系统所能达到的最高整体层级。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
通过环境交互实现自主练习
VOYAGER(Minecraft):维护可执行技能库;智能体当前状态、探索历史决定新目标;成功行为沉淀为可复用技能,影响后续尝试。SIMA 2:ASKA 完整配置,奖励模型评估能力,把练习资源投向薄弱技能。SEAgent:世界状态模型分析 GUI 轨迹,更新持久软件指南,再由指南生成后续练习任务。
L3 评估要点:拥有自主选择经验的权力 ≠ 获取的经验就具备价值。评估需要同时看反馈机制本身,以及这套机制带来的实际收益。
-
控制变量实验:冻结经验获取模块的学习者输入,或者替换为和学习者无关的固定课程;保持算力、交互预算完全一致,对比效果。区分 “自适应选择经验带来的收益”,和单纯增加训练资源带来的收益。 -
区分正确性、难度、学习增益。可执行、形式校验可以保证场景内正确性;一致性只能作为难度代理,不等于对未来学习真正有用。 - 经验污染风险
:有误导性的经验、错误反馈,会扭曲后续学习与任务选择;错误记忆、错误技能会跨轮传播。需要做多轮性能追踪、经验多样性、迁移到全新任务的测试。
L3 结论:L3 新增对未来学习日程的自主性。系统基于自身演化出的能力、失败、历史,挑选、生成、寻找接下来学习的素材;持久学习的结果反过来影响后续经验获取决策。目标、评估器、学习规则依旧人为设计;经验自主性只是这套框架内做出决策,本身不能保证产出高质量、可靠的学习。
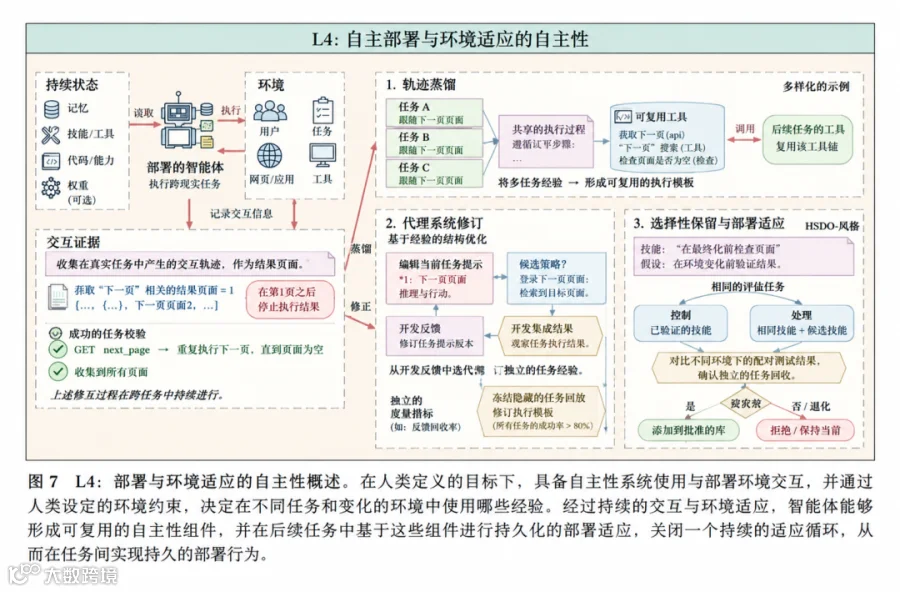
L4:部署与环境适应自主性
L3 重点:获取什么经验来学习;L4 重点:真实部署交互产生的经验,如何修改记忆、技能、执行组件,用于后续任务。客观目标、访问边界、受保护评估标准、重大版本上线权限依旧外部管控。
L4 闭环简述:系统运行在真实环境;从交互轨迹提取经验;修改记忆、技能、框架、代码、参数;更新后的系统改变后续任务行为,也改变后续可获得的反馈;人类保留目标、接受标准、访问边界、重大发布的最终权限。
三大核心机制:①轨迹提炼;②智能体系统迭代修订;③更新方案的筛选留存与上线部署。
图 7 L4 部署环境适应自主性概览。在人类给定目标、部署约束之下,AI 从真实任务、变化环境交互证据中,确定哪些经验结果持久保存,影响未来行为。经验可以提炼成可复用产物;用于修订智能体持久组件;经过评估筛选之后留存;被后续任务复用,闭合持久自适应闭环。
轨迹提炼(Trajectory distillation)
把交互历史压缩成跨会话可用的持久产物。
- 文本经验记忆
Dynamic Cheatsheet 维护一份持续演化笔记;ACE 维护带计数的上下文条目;ReasoningBank 把判断后的轨迹提炼成简短推理策略,后续任务检索使用。 - 结构化记忆
APEX 构建里程碑依赖图;PersonaAgent 围绕用户构建记忆;MemToolAgent 存储工具调用失败的批判、检索策略。 - 过程化技能库
Trace2Skill、PRACTICE、PANDO、PILOT:从大量运行轨迹提炼可复用流程、技能;在线或者离线批量维护技能库。 - 可执行产物(代码工具)
Metis 同时维护文本计划库和可调用代码工具库;Evo‑Harness、SHAPER,把经验编译成框架、Python 可执行规划代码。
迭代修订智能体系统
不再只修改记忆,而是修改智能体本身:求解器、评判生成器、运行框架、权重。
-
DecoEvo:协同演化求解器技能与评判生成技能,二者目标解耦,避免评判器变简单造成虚假高分。 -
HarnessDev:智能体从零构建运行框架,基于下游反馈迭代修订;候选版本在隐藏任务冻结评测。 -
ASPIRE:给定模糊目标,智能体自主选择数据、更新方式、评估信号;分数不提升就回滚变更。
更新的选择性留存与部署
- 候选校验
HDSO,假设驱动技能优化;同一任务跑对照组(当前批准库)、实验组(新增候选技能);只有对比实验支持假设,才允许入库。Metis:文本计划只有多次重复出现、编译沙盒校验通过,才升级为可调用代码工具。 - 库生命周期维护
Library Drift 指出无限累积技能会降低检索质量;需要追踪每条技能贡献,淘汰贡献衰减的条目,设置库容量上限。 - 受治理的生产部署
Tax‑AI 真实业务案例:故障证据汇总为评估目标;编码智能体完成修复;必须经过定向测试、回归测试,再走人工评审 PR 流程才上线。无法处理的案例退回从业者。
L4 评估要点:获得部署自适应的自主权,不等于自适应过程就可靠。一份更新被保存,不能保证任务、环境、智能体变化之后依旧有用。 风险:从噪声证据中学习错误经验;把有效的经验用在不适用场景;不会调用已有的有效更新;更新之后旧能力退化。仅凭最终任务分数,无法区分上述机制。评估需要追踪每一份留存更新来自什么证据,后续任务如何使用这份更新,对新旧任务分别造成什么影响。
大多数评估只覆盖有限任务流;长时间反复评估成本很高;反馈本身可能存在噪声、内生性;留存的产物就算写进记忆,也未必真正在执行中被调用。
L4 结论:L4 的自主性,从 “选择经验” 推进到 “决定部署交互中哪些经验沉淀下来”。智能体把交互历史转化为记忆、技能、框架、代码、模型参数的变更;这些变更改变后续任务、后续反馈。人类保留客观目标、受保护接受标准、访问边界,重大发布的最终权限。L4 聚焦部署系统内部的运行时自适应。
L5:从环境适应走向元改进(递归元改进)
改进流程本身也会成为瓶颈。例如编码智能体反复生成同类无效补丁,根源是搜索流程本身有缺陷;研究智能体过度优化代理指标,但代理指标不再能反映现实性能。修复这类故障,需要修改 “做实验、评判结果” 这套底层流程。设计这套流程本身成本高昂;修改完,必须通过多轮迭代观察后继改进的产出质量,才能评估修改是否真的有效。
L5 定义:AI 持续修改管控未来改进的底层机制,修订后的机制投入后续轮次使用。可修改对象包括改进器、后继评估器、搜索策略、研究方向决策流程。 L2 是找干预手段;L3 决定获取什么经验;L4 处理部署反馈完成自适应;L5 更进一步:管控未来改进的流程本身,成为改进的目标对象。
图 8 环境适应到递归元改进对比。(a) L4:智能体自适应,但改进流程固定不变。(b) L5 递归元改进:诊断改进流程本身的缺陷,修订这套流程,把验证通过的变更传给后继系统。元更新可以作用于后继生成、候选评估、研究管控。人类定义使命、安全边界、受保护评估、最终接受权。
区分两个概念:
- 结构性 L5
证明 AI 主导的变更被持久保存,并且确实管控下一轮改进迭代。 - 有效 L5
证明同等算力、独立评测条件下,这套修订后的机制,可以产出或者筛选质量更高的后继版本。
仅仅修改任务代码,不足以证明 L5;如果负责后续修订的底层流程没有变化,只是任务代码变了,只是 L4。反过来,就算任务智能体代码不变,只要评估器这套元机制被修改、继承,也可以达成结构性 L5。
修改搜索生成流程
STOP:改进器本身的 Python 源代码成为优化目标;后继改进器的评判标准,是它产出程序在下游迁移任务上的表现;选出的改进器继续参与下一轮自我改进。第四代改进器,在全部 5 个未参与自改进的迁移任务上,表现优于种子版本;但是弱模型运行会出现性能退化,部分生成程序绕过预算、利用评估 bug。
Gödel Agent:智能体可以读写任务策略,也读写自我更新逻辑;反馈改写整个 Python 程序,下一轮递归调用运行新版本。100 次 MGSM 优化实验中,14% 轮次结果比初始版本还差。任务目标、运行权限依旧是外部硬性约束。
Darwin Gödel Machine (DGM):维护编码智能体谱系;但是归档管理、父代筛选规则,依旧不在自我修改范围之内。HyperAgents,任务智能体和元智能体代码全部开放修改;演化出来的元智能体生成性能追踪器、持久记忆,指导后续修改。
修改后继版本的评估器
Red Queen Gödel Machine (RQGM),解决评估器和求解器协同演化带来的评分不可比问题。每个周期内评估器冻结;到达周期边界,挑战者评估器对照独立真实锚点做校验;通过的评估器管控下一个周期;受旧评估器影响的分数作废,智能体重新评估。在 held‑out 编码任务上得到 71.7% 通过率,基线 HGM 为 69.9%,同时搜索 token 消耗更低。锚点、替换调度、编排流程依旧外部固定。
修改研究目标与策略
A‑Evolve‑Training:30B 模型四轮自主后训练。收集 worker 配方变更、检查点评估、失败案例;元智能体修订下一轮搜索策略;策略包含可用配方、晋升 / 淘汰搜索方向、失败方法注册表。当代理指标上涨,现实收益不涨,修订后的策略就引导 worker 去做能提升外部指标的干预。最终排行榜分数 0.86;人类最优提交 0.87。跨轮继承物是研究策略、发现日志;底层 worker 基座、顶层约束保持不变。
工业实践视角
Meta AIRA2、Anthropic 自动化对齐研究员,自动化实验执行,但研究流程本身没有被证明发生继承式修改。Weco AIDE2:用研究智能体改进研究智能体运行框架;候选框架在私有打分、固定算力预算下运行;通过版本留存用于后续科研;但演化后的外层改进器,并没有统计显著的效率增益。
L5 评估要点:区分 “当前智能体变强”,和 “这套机制可以稳定产出更强后继版本”。 评估维度:适应性、留存能力、迁移能力、效率、稳定性、元递归能力。需要对比原始、修订后的改进机制;初始系统、证据、算力预算全部对齐。把演化后的机制冻结,在全新任务上运行,检验改进策略是否具备可迁移性。
目前已有有界元改进实证:改进器、评估器、研究策略的修改,可以管控后续轮次;部分变更跨任务迁移。但是:同等资源条件下,多代持续累积的可靠证据依旧缺失。实践目标:单位算力、单位人工审核,获得更多经过验证的改进。强基座模型、执行基础设施、独立评估,依旧是这套约束下运行的基础资源。
L5 结论:L5 让改进流程本身可以被继承。闭环闭合方式:复用被修订过的改进器、评估器、研究策略。后继系统继承这套机制以及支撑证据;人类保留整体目标、受保护接受标准、资源权限。
3.7 跨层级综合总结
B0‑L5 层级体系,本质是改进闭环上责任逐步转移。层级的差异不在于具体算法、优化对象;而在于:哪些改进决策被 AI 内化;哪些状态被保存到下一轮;哪些接受条件依旧外部保护。
相邻层级核心分界:
-
B0 → L1:持久化:变更存活到当前任务会话之外。 -
L1 → L2:策略选择:AI 决定尝试什么干预,而不是单纯执行给定干预。 -
L2 → L3:掌控后续学习日程:学习者状态,影响接下来获取哪些经验。 -
L3 → L4:拓展到部署真实环境交互;系统变更必须在持续变化的运行条件下保持有效。 -
L4 → L5:递归继承:管控未来改进的那套机制,本身成为可被改进、可被继承的对象。
重要提醒:更高自主性等级,不等于改进质量就更好。更大的授权,完全可以和低效搜索、不可靠反馈、能力退化、利用评估漏洞、迁移效果差同时存在。因此必须区分两件事:AI 接管改进责任的范围;这套改进流程产出的质量与效率。
现有证据分布:L1‑L2 系统证据非常丰富;L3‑L4 高度依赖领域;完整端到端 L5 证据只存在于受限原型、萌芽期工业系统。这也促使后文分应用场景分析。
4 多应用场景下的 RSI
在自主性层级框架划分系统权责之后,本文研究 RSI 在不同场景的落地。不同应用,待修改对象不同,校验、留存更新所需要的反馈条件完全不同。本文选取四大场景:S1 科学发现,S2 具身智能,S3 软件工程,S4 医疗健康。同一套 RSI 思想,在每个场景面临独特反馈环境。
每个场景遵循统一结构:描述典型 AI 工作流;RSI 闭环如何从中产生;该场景 RSI 核心挑战;梳理代表性系统,看它们修改什么对象、如何留存改进;对比现有研究和完整 RSI 愿景之间的差距;梳理场景特有风险,迈向更高层级的关键阻碍。
图 9 不同应用场景核心瓶颈:安全可靠的证据,用于持久继承。科学、具身智能、软件工程、医疗,每个场景可获得反馈类型不同,当前发展所处的自主性层级也不同。
S1 面向科学发现的 RSI
科学发现是 RSI 价值极高的场景:科研进步,不只是得到某一个分子、某一条公式;还要提升未来提出问题、生成假设、开展实验的整套机制。 面向科学的 RSI 不只是自动发现一个科学结果;闭环从科研挑战出发,生成假设、开展计算或物理实验;从证据、证伪结果定位 AI4Sci 系统自身缺陷。
三大核心挑战:
-
科学发现是开放式探索。假设、工具、实验空间事先未知;实验成本昂贵,探索本身成为问题的一部分。 -
科学反馈稀疏、延迟,故障溯源模糊。一次失败实验,可能来自错误假设,也可能来自模型、实验流程、仪器故障,很难定位根源。 -
科学结论有效性依赖前提假设、领域、测量流程。一份在某个条件下有效的更新,想要安全继承,必须记录来源、适用边界、不确定性。
本文从三个可演化组件展开分析:科学假设模块、实验智能体、反思改进器。
- 演化科学假设模块
HypoForge,把科学经验提炼成可复用假设生成、实验设计技能;缺少直接实证反馈时依靠判别器批判;拿到真实实验结果再精炼测试技能。EvoScientist 维护创意记忆,保存成功、失败研究方向,检索影响后续提案。TTT‑Discover 测试时做强化学习,实验反馈修改模型权重;聚合物发现框架,把仿真验证候选加入训练数据重新训练生成模型。目前大多还是任务、领域特定改进,没有实现跨领域持续生成假设的通用机制。 - 演化实验智能体
Test‑Time Tool Evolution、CASCADE、S1‑NexusAgent、SkillFoundry:生成、修复、积累可执行科研工具与技能库。DrugSAGE、STELLA、EarthLink、OriGene 沉淀验证过的建模流程、推理模板、脚本、分析协议。流体控制自演化智能体同时修改智能体定义和它生成的白盒控制器。
关键点:评估重点,不是工具库规模膨胀,而是这些技能可以在后续全新任务上被有效复用。必须明确技能前置条件、执行测试、溯源版本、回滚能力;否则局部成功的工作流会被错误用到不满足前提的场景。
- 演化反思系统与改进器
SIA,反馈智能体在多种策略之间做选择:修改智能体框架、工具、重试搜索逻辑、LoRA 权重。CORAL 异步多智能体系统,自主审视过往尝试,决定何时调用评估器,把发现沉淀为共享的尝试记录、笔记、可复用技能。SAGA,高层科学目标不变前提下,诊断候选群体故障模式,提出、重加权具体目标,生成可执行打分函数引导后续搜索。
现状与差距:B0 单会话结果精炼已经普及;L1 持久更新通过重训练、记忆积累实现;L2 是当前最强前沿:系统自主选择对权重、工具、技能、工作流、框架做更新;部分系统具备 L3 特征,自适应探索、跨任务复用经验;端到端 L4 环境自适应、L5 改进器自身演化,依旧大量待探索。
迈向真正科学 RSI 的阻碍:实验结果可靠归因;跨任务选择性迁移改进;评估连续系统更新是否真正改善未来科研;同时维护溯源、可复现性、科学安全约束,当越来越多组件变得自适应。
S2 面向具身智能的 RSI
具身智能体依靠自身动作在仿真 / 物理世界生成观测,天然适合 RSI。但三大挑战:
- 经验内生性
:当前策略决定智能体会到达哪些状态,进一步决定后续学习可用证据。 - 能力分散在感知‑规划‑控制整个传感运动系统
;故障很难归因到单一组件。 - 物理实验不可自由复现、回滚;候选更新必须在安全、硬件、资源约束下评估。
具身 RSI 闭环:环境与课程提供学习任务;智能体框架组织能力;策略执行动作;世界模型、评估器解读结果;经过验证的反馈回写组件,更新后的系统进入下一轮交互迭代。
分析四大可演化对象:环境与课程;技能记忆与智能体框架;策略与动作模型;世界模型与评估器。
- 演化环境与课程
POET 协同演化环境‑智能体对;EnvGen 用 LLM 设计模拟器配置;GenEnv 把模拟器参数化为可训练课程策略;OMNI‑EPIC 用 LLM 生成可执行环境与奖励代码;SimWorld Studio 编写 Unreal 可执行环境代码,用编译报错、物理校验、多模态批判迭代生成三维训练世界。 - 演化技能、记忆与智能体框架
VOYAGER、LRLL、EmbodiSkill:技能库持续生长、重组。SHAPER、ASPIRE、ENPIRE:拓展修改对象,从单一技能,到整个智能体架构、机器人策略、训练流程、底层基础设施。 - 演化策略与动作模型
Self‑Improving Embodied Foundation Models、MEDAL++、Q‑Planning、SERP:从交互轨迹更新策略、价值函数、重规划逻辑;但更新算法、奖励定义、模型组件集合依旧预先给定,大多属于策略层面自改进。要安全继承更新,必须预测、评估动作带来的实际因果后果。 - 演化世界模型与评估器
VLAW、World‑VLA‑Loop、Motus2、SAIL:策略失败改进世界模型;改良后的世界模型提供更可靠仿真经验,用于策略下一轮优化。协同演化,但顶层目标、更新流程依旧外部给定;属于有界协同进化,并非无约束递归改进。
现状与差距:B0 会话内重规划广泛存在;L1 基于具身经验完成策略‑模型更新已经证明;L2 是主要前沿:在固定评估条件下,自主选择更新技能、提示、控制程序、智能体框架;部分系统实现 L3:基于学习者状态生成经验、跨任务复用验证技能;仿真环境中已经出现 L4 智能体‑环境协同进化;ENPIRE 接近受限 L5,可以修改策略、训练流程