


7 个关键问题问答
Q1:FreeToken 解决什么核心痛点?
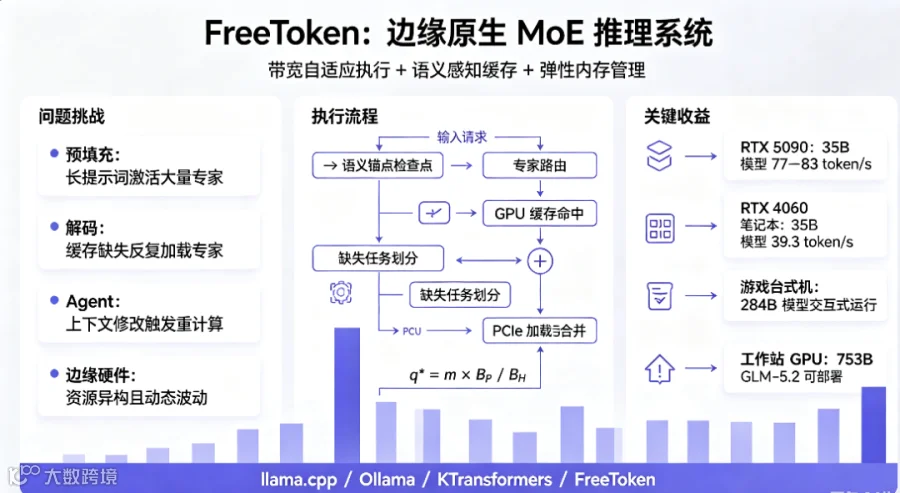
A:解决普通个人电脑、笔记本跑 MoE 大模型的难题。现有工具使用固定专家部署策略,无法适配边缘硬件资源动态变化,在 Agent 工具调用场景预填充开销高、解码慢、时延爆炸,大模型很难在消费设备流畅运行。
Q2:MoE 模型在边缘设备落地天然困难的根源是什么?
A:MoE 单 token 仅激活少量专家,但完整全部专家权重体积巨大远超显存;预填充阶段几乎激活全部专家,带来巨大数据搬运开销;边缘硬件带宽、算力差异大,且会被浏览器游戏抢占资源。
Q3:什么是带宽自适应 q * 策略?
A:实测得到 PCIe 传输带宽、主机内存带宽,定量划分缓存缺失专家:一部分通过 PCIe 加载到 GPU 执行,一部分直接在 CPU 执行,平衡两条并行路径耗时,充分利用整机带宽资源。
Q4:语义感知缓存 / 语义锚点起到什么作用?
A:在思考片段、工具调用边界保存循环状态检查点。Agent 修改上下文后,不需要从头重算全部上下文,仅重新计算新增后缀,大幅降低多轮 Agent 的预填充开销。
Q5:弹性内存管理和普通缓存的区别?
A:普通系统显存分配启动后固定;FreeToken 可运行时动态调整专家缓存与 KV 缓存显存占比,设备可用显存变化时无需重启推理引擎,同时优化模型启动加载速度。
Q6:FreeToken 相比其他 MoE 推理工具最大优势?
A1)精度无损,不对模型做修改;2)同时兼顾预填充、解码、多轮 Agent 场景;3)CPU‑GPU 任务动态分配,不是固定卸载;4)适配动态变化的边缘硬件资源。
Q7:实际硬件上能达到什么样的效果?
A:8G 笔记本可流畅跑 35B 模型;游戏台式机运行 284B 模型;单工作站显卡运行 753B GLM‑5.2;相比基线吞吐提升 1.3‑2.3 倍,Agent 场景性能衰减被控制在 12% 以内,最坏首 token 时延小于 44 秒。
附录 FreeToken:面向边缘原生 MoE 服务的带宽自适应执行系统
杨硕∗,范肖泽∗,Melissa Pan,奚浩程,王哲,孙善林,Kurt Keutzer,韩松,Matei Zaharia,徐晨峰†,Ion Stoica† ∗共同贡献,†共同指导
摘要:前沿开源权重模型不断涌现,但模型推理服务仍大多依赖数据中心基础设施。本文提出FreeToken,一套边缘原生的混合专家(MoE)推理服务系统。该系统不再将个人设备视作小型 GPU,而是把它作为一套统一、弹性的推理计算平台。FreeToken 围绕本地 AI 的两大现实约束,对整套服务栈进行协同设计,涵盖模型布局与加载、专家驻留策略、CPU‑GPU 协同执行、智能 Agent 状态复用以及运行时内存管理:Agent 业务的执行模式会持续动态变化;边缘硬件资源异构,不同设备之间资源配比差异巨大。FreeToken 不采用固定的卸载策略,而是持续将计算与模型状态映射到设备当前实际可用的硬件资源上。该系统可支持 20 余款 MoE 模型,可在从 8GB 显存笔记本 GPU 到单工作站 GPU 的各类硬件上,运行真实代码生成与工具调用 Agent 应用。更重要的是,它拓展了消费级硬件的实际服务能力:笔记本上可运行 35B 模型,游戏台式机可运行 284B 规模模型,单块工作站 GPU 能够部署 753B 参数的 GLM‑5.2。FreeToken 将开源模型权重转化为可直接部署的本地软件,让用户已有的硬件设备成为运行前沿大模型的实用平台。
通讯作者:杨硕 andy_yang@berkeley.edu;徐晨峰 xuchenfeng@utexas.edu 代码仓库:https://github.com/FlashML-org/FreeToken 项目主页:https://flashml.ai
1 引言
近年来的开源权重模型,例如 Kimi‑K3(Kimi 团队,2026)、GLM‑5.2(Z.ai,2026)、DeepSeek‑V4Flash‑0731(DeepSeek‑AI,2026),能力正在快速追赶闭源顶尖模型。然而,发布模型权重只解决 “谁可以获取模型”,并不能解决 “谁有能力运行模型” 的问题。前沿开源模型仍然依赖成本高达数百万美元的数据中心级 GPU 集群。虽然托管 API 的价格相比同类闭源服务更低,但长期使用成本依旧高昂。随着智能 Agent 应用大幅提升推理负载(Presenc AI Research,2026;Anthropic,2026),高昂开销对个人用户与小型团队带来沉重负担。因此,开源模型与闭源模型的能力差距正在快速缩小,但获取前沿模型和大规模实际使用模型之间的可使用性鸿沟,改善速度却慢得多。
乍看之下,这种可用性鸿沟属于硬件层面的问题。但如今数以亿计消费级设备已经搭载独立显卡,涵盖游戏台式机、工作站、高性能笔记本∗。这些设备汇聚起来,构成规模庞大但利用率不足的算力资源池。因此真正的短板并非硬件本身,而是缺少一套推理服务系统:能够把每一台异构消费级设备当作统一推理平台,自动调度 GPU、CPU、内存、互联总线资源,充分发挥硬件性能,高效运行最强规模的模型。
∗仅 Steam 平台月活用户就超 2 亿,调研设备中约 72% 搭载 NVIDIA 独立显卡(Simon Carless (GameDiscoverCo),gHacks 转载,2026;Valve Corporation,2026)
MoE(混合专家)架构为边缘设备运行前沿开源大模型开辟了新路径。MoE 层包含数百个专家,每个 token 仅路由到其中一小部分专家执行。以 DeepSeek‑V4‑Flash 为例,其 43 层网络中,每层仅激活 256 个路由专家中的 6 个。因此 284B 总参数中,单 token 仅会调用 13B 参数。在部署精度下,该激活参数量可以放入 RTX 5090 的 32GB 显存。 但是,稀疏激活只能降低单 token 计算量,并不会等比例缩减全部专家集合所占用的内存。完整模型参数量仍会远超 GPU 显存上限,未被激活的专家只能存放在主机内存或外存,需要时再调入执行。 因此 MoE 给个人硬件上的前沿推理同时带来机遇与系统层面的核心挑战:稀疏激活让计算变得可行,但海量专家集合给高效推理服务带来巨大难题。

已有不少推理服务系统尝试将强大的开源模型部署到个人硬件,典型包括 llama.cpp(Gerganov 等人,2023)、KTransformers(KVCache‑AI 团队,2025)、Ollama(Ollama 团队,2023)。但现有系统只解决边缘 MoE 推理的部分问题,存在三大短板,无法释放边缘硬件理论算力上限:
- 预填充阶段会破坏 MoE 的工作集稀疏性
虽然单个 token 只激活少量专家,但长提示词下所有 token 的路由集合合并后,几乎会覆盖每层绝大多数专家,专家工作集实际变为稠密。大量超出显存的专家需要反复从主机内存搬运,带来计算与内存拷贝双重压力。在 Agent 工具调用场景中,上下文持续变长,频繁触发预填充;而现有边缘推理系统几乎没有机制掩盖专家数据搬运开销,也无法在多轮对话间复用循环状态。 - 解码阶段问题恰恰相反
每个 token 仅激活稀疏的专家子集,但缓存缺失会造成专家反复加载、换出、或者直接在主机内存执行。现有系统缺少一套完备的调度策略处理缓存缺失。静态专家放置无法跟随 token 级路由动态变化;预测与预取可以降低缺失率,但无法决定不可避免的缓存缺失,应该如何在 PCIe 传输、GPU 执行、CPU 直接执行三者之间分配负载。 - 边缘硬件资源异构且动态变化,放大上述两类问题
和数据中心部署不同,消费级硬件的显存容量、PCIe 带宽、主机内存带宽、CPU 性能差异巨大。并且这些硬件资源很少专门供给模型推理:用户会同时运行浏览器、游戏等其他软件,可用内存与算力预算会随时间动态波动。因此不存在一套静态的放置与调度策略,可以适配不同设备、不同业务阶段、动态变化的运行环境。
本文提出 FreeToken,这套系统基于两条执行原则和一套弹性资源管理策略: (1) 带宽自适应执行:不再将边缘有限带宽视作固定瓶颈,而是作为运行时调度信号。预填充阶段,FreeToken 采用双缓冲将专家数据搬运与计算流水线重叠:GPU 计算当前层的同时,通过 PCIe 流式加载下一层专家。解码阶段需要更细粒度资源分配,PCIe 传输与 CPU 专家执行会争抢同一套主机内存带宽。FreeToken 采用\(q^*\)策略,把每一步的缓存缺失任务划分到 GPU 缓存加载与 CPU 直接执行(§3.2),匹配当前设备实际可提供的带宽。
(2) 语义感知缓存:决定稀缺内存中应当保留哪些数据。Agent 多轮交互中,框架会在语义边界修改上下文,例如思考片段、工具调用边界。预填充阶段,FreeToken 在这些语义边界保存循环状态检查点;上下文被修改后,仅需要重新计算新增后缀部分。解码阶段相邻 token 路由的专家经常重叠,FreeToken 利用共享 LRU 专家缓存捕获这种 token 间路由局部性,绝大多数路由请求直接命中显存,剩余的缓存缺失交给\(q^*\)策略处理。
(3) 弹性边缘资源管理:适配个人设备不断变化的内存条件。在调度安全点,FreeToken 可以在修改后的内存预算下动态调整、重建 GPU 专家缓存,不需要重启引擎,也不用重新加载主机侧专家权重。同时直接把专家加载到最终主机内存布局再锁定内存,降低启动时延。
FreeToken 可在多种消费级、工作站硬件上运行 20 余款 MoE 模型。实验选取 3 个代表性前沿模型:Qwen3.6‑35B‑A3B、DeepSeek‑V4‑Flash、GLM‑5.2;测试机器覆盖 8GB 显存 RTX4060 笔记本到单张 RTX PRO 6000 工作站显卡;使用 4 套真实 Agent 业务负载;对比 llama.cpp、Ollama、KTransformers、MoE‑Infinity。 在 RTX5090 上,FreeToken 运行 Qwen3.6‑35B‑A3B 可达 77‑83 token/s;DeepSeek‑V4‑Flash 可达 22‑25 token/s。在全部业务负载下,解码吞吐相比当前最优边缘推理系统提升 1.5‑2.3 倍。在 Agent 场景下性能依然稳定:解码速率相比单轮场景下降幅度不超过 12%;而对比系统性能大幅衰减。尾部时延优势更加明显:FreeToken 所有业务场景下最坏情况首 token 生成时间 TTFT 控制在 44 秒以内;而所有基线系统至少有一组实验超过 150 秒,足以触发真实 Agent 客户端超时。 在 5 台消费级设备上,解码吞吐提升 1.3‑2.1 倍。8GB RTX4060 笔记本上,可运行 35B 模型,达到 39.3 token/s,超过 Codex 生产环境中位数 33 token/s。32GB 游戏台式机可以交互式运行 284B 模型。单张 RTX PRO 6000 工作站显卡运行 753B GLM‑5.2,吞吐达到 llama.cpp 的两倍。 以上技术进步将开源权重真正转化为可访问能力,把前沿大模型从数据中心迁移到用户现有设备。FreeToken 拓展本地推理的速度与能力边界,让消费级硬件可以交互式运行以往只能部署在数据中心的超大模型。系统已开源发布于 flashml.ai。
2 边缘 MoE 推理面临的挑战
MoE 架构天然适合边缘推理。典型 MoE 层存储 E 个专家,每个 token 仅路由到远小于 E 的 k 个专家,单解码步访问的权重只是网络总参数的一小部分。 但现实中现有边缘推理引擎(Gerganov 等人,2023;KVCache‑AI 团队,2025;Xue 等人,2024)远无法发挥硬件理论上限,Agent 业务场景性能损失尤为突出:每次工具调用都会拉长首 token 生成时延 TTFT,解码吞吐远低于设备内存带宽上限。本节分析三大根源:预填充开销(§2.1)、解码开销(§2.2)、资源动态波动问题(§2.3)。§3 将依次给出对应的解决方案。
2.1 预填充阶段挑战:数据传输与重复计算开销
预填充决定 Agent 每一轮交互的首 token 时延 TTFT。边缘设备上预填充耗时主要分为两部分:专家传输开销(开销和完整模型规模相关,而非激活路径);上下文重计算开销,Agent 会话会高频触发该开销,现有系统难以承受。
每次预填充都会带来数秒的专家传输耗时。虽然解码阶段每个 token 仅路由 k 个专家,但预填充时每层会处理数千 token,激活几乎全部专家集合。预填充过程几乎要把全部专家权重通过 CPU‑GPU 互联链路搬运一遍,带来巨大 I/O 开销,而显存常驻部署完全不会产生这部分开销。 以 FP4 量化 DeepSeek‑V4‑Flash 举例:需要传输约 140GB 专家权重;RTX5090(PCIe5.0 x16,带宽约 60GB/s)增加约 2 秒时延;RTX4090/3090 台式机(PCIe4.0 x16,带宽约 25GB/s)增加约 5 秒;笔记本常见 x8 链路环境下耗时 10 秒以上。按需拉取专家的引擎会让 GPU 在这段时间完全空闲。数秒级时延对于 Agent 服务是不可接受的。
Agent 工具调用会频繁触发重新预填充。第二个挑战是重复执行已经计算过的上下文。很多前沿模型采用混合注意力架构:完整注意力与滑动窗口注意力交替(DeepSeek‑V4‑Flash(DeepSeek‑AI,2026)、GPT‑OSS(OpenAI,2025)),或者引入循环层(Qwen3.6‑35B‑A3B 的 Gated DeltaNet(Yang 等人,2024b)、Kimi‑K3 的 Kimi Delta Attention(Kimi 团队,2025))。 和标准注意力不同,这类层会把历史上下文压缩为单个状态,或者一小段 KV 缓存。每一份保存的状态占用内存等价于数百 token 的 KV 缓存,推理引擎只能保存少量检查点。Agent 业务几乎每轮都会修改上下文:工具调用会删除旧输出、抹除思考片段。一旦修改发生,修改位置之后所有检查点全部失效,引擎只能回退到修改之前最近的有效检查点。由于检查点稀疏,往往需要重新预填充数千 token。 消费级 GPU 算力远低于数据中心显卡:RTX5090 稠密 BF16 算力仅为 H100 的 1/5,B200 的 1/10。长上下文重复预填充会占用 GPU 数十秒时间。
2.2 解码阶段挑战:缓存缺失与 CPU 带宽瓶颈
解码时延取决于如何处理每一步专家缓存缺失。现有引擎性能下降来源于两点硬件特性与一条策略缺陷:静态专家放置无法命中大部分路由流量;消费级 CPU 带宽不足以单独承担全部缺失任务;缺失任务在两条执行路径之间的最优划分高度依赖硬件。
静态专家放置无法适配路由流量。现有混合推理引擎在加载或者预填充阶段固定专家部署位置:llama.cpp 加载模型时分配 MoE 张量设备(Gerganov 等人,2023);KTransformers 将一部分热专家常驻显存,其余专家交给 CPU 执行(KVCache‑AI 团队,2025)。但路由结果会随着 token、业务负载动态变化。预填充阶段固化的放置策略只能命中一小部分路由访问,大量专家计算落到 CPU,GPU 与 PCIe 链路大量空闲(§5.3)。
消费级 CPU 无法独立完成全部解码任务。解码小批量场景下专家执行属于内存受限型任务:每个 token 需要读取一次路由专家权重。消费平台 CPU 一般搭配双通道内存:DDR4 双通道峰值带宽约 50GB/s;DDR5 约 80‑90GB/s。对比 RTX4090/5090 芯片显存带宽 1‑1.8TB/s,差距巨大。带宽瓶颈导致,即便 CPU 核心再多,纯 CPU 专家路径解码速度远低于显存执行。
任务划分方案需要适配硬件。发生缓存缺失的专家有两种选择:通过 PCIe 传输到 GPU 执行;直接在 CPU 侧读取权重执行。两种方案没有绝对优劣。仅依赖传输,当主机内存吞吐高于 PCIe 链路上限时,主机带宽与 CPU 核心会闲置。仅依赖 CPU 执行,PCIe 链路空闲,同时失去缓存命中带来的后续收益。最优配比取决于硬件。例如搭载 LPDDR5 的 RTX4060 笔记本和 DDR5 平台 RTX5090 台式机,主机‑PCIe 带宽配比完全相反。该最优配比不能直接从硬件规格表获取,系统必须在实际运行设备上定量计算。
2.3 资源管理挑战:边缘硬件资源无法独占
数据中心环境中 GPU、CPU 资源完全专属于推理业务。但笔记本、个人电脑这类边缘设备,大模型推理只是众多并发应用之一,推理引擎可用资源高度动态变化。
推理过程中显存总预算以及显存划分会频繁变动。边缘设备 GPU 同时给桌面合成器、浏览器、游戏使用,这些程序随时会占用数 GB 显存。推理引擎可用显存,在每次启动时都不一样,运行过程中也会扩张或收缩。显存内部最优分配比例同样动态变化:Agent 会话不断累积上下文,KV 缓存需求持续上涨,专家工作集大小基本不变;第一轮设置的显存分配比例,经过多轮交互后就不再适用。因此运行时必须可以动态调整显存总大小,以及 KV 缓存与专家缓存之间的分配,且不能重启引擎。
引擎启动慢,且启动频繁。推理引擎启动资源开销巨大:完整专家集合需要从磁盘加载,GPU 预热之后才能处理请求。以 FP4 量化 DeepSeek‑V4‑Flash 为例,仅从 7GB/s NVMe 磁盘读取 140GB 专家权重就需要约 20 秒,还不包含预热阶段。边缘设备中该开销会反复出现:用户按需开启引擎,用完关闭释放资源;切换模型同样需要重启引擎。边缘推理引擎必须做到快速启动。
3 FreeToken 系统设计
FreeToken 基于两层专家内存层级构建边缘 MoE 推理(图 2)。CPU 侧保存全部路由专家权重,作为权威数据源;非专家权重常驻 GPU 显存。剩余 GPU 内存全部作为弹性专家缓存,被所有 MoE 层共享。每个缓存槽保存完整执行某一层‑专家组合需要的全部张量;驻留、查找、执行全部基于逻辑(层,专家)ID,而不是张量分片。
设计针对 §2 指出的两大性能瓶颈阶段。预填充阶段(§3.1),FreeToken 将大规模专家数据搬运隐藏在计算之后,同时维护可以抵抗 Agent 上下文编辑的前缀(包含循环状态)。解码阶段(§3.2)带宽自适应执行,基于设备实测的两类带宽,把缓存缺失任务分配给 PCIe 传输与 CPU 执行。底层弹性专家内存生命周期管理(§3.3)将 GPU 缓存容量作为运行时可调资源,而不是加载时固定常量。

3.1 预填充协同设计:流水线加载与语义感知状态缓存
§2.1 指出预填充开销来自大规模专家传输、冗余重计算。FreeToken 分别提供对应机制:全层双缓冲把传输开销隐藏在计算背后;语义感知状态缓存,保证循环状态等前缀信息在上下文编辑之后仍然有效,避免重复计算。
全层双缓冲,传输与计算重叠。预填充阶段每层几乎激活全部专家集合(§2.1),FreeToken 不再按需拉取专家。从全局缓存槽池中分配两份完整层缓冲区。GPU 使用其中一份缓冲区计算第l层路由专家的同时,专用传输流并行把第\(l+1\)层全部专家加载进第二块缓冲区。加载完整层不需要提前知道该层路由结果。保证权重数据在后台持续搬运,而不是逐层串行执行。两块缓冲区交替扮演两种角色。缓冲区复用解码缓存的槽池,没有独立预填充缓存,也不存在阶段切换开销;预填充结束后仍然驻留的缓存条目直接服务对时延敏感的解码阶段。当槽池不足以容纳完整两层时,FreeToken 回退到按需预填充加载,避免显存超配。
语义锚点:上下文编辑时保留循环状态。混合注意力模型除 KV 缓存之外,引入了第二类前缀资源。FreeToken 采用基数前缀树管理全注意力 KV 缓存,沿用已有推理系统的方案(Zheng 等人,2024)。循环层会把全部前缀压缩成一份持续演化的状态,无法部分复用;因此循环层前缀复用依赖预填充、解码过程保存的状态检查点。 为此 FreeToken 实现语义感知状态缓存:少量循环状态检查点挂载在前缀树节点上。收到新请求时,恢复到修改提示词之后仍然有效的最深检查点。因为每个检查点保存该类层完整循环状态,系统只能维护少量检查点,检查点放置位置直接决定收益。
FreeToken 把检查点预算分配到语义锚点:标记思考片段、工具调用、工具输出、对话轮次的特殊 token 边界。Agent 框架恰恰就在这些位置修改、截断上下文:OpenClaw 会抹除除最新一轮之外所有助手思考块(OpenClaw 贡献者,2026);OpenCode 会把超出滑动窗口的工具输出替换为占位符(OpenCode,2026);SWE‑agent 只保留最近 n 条观测记录(Yang 等人,2024a)。所有修改都是以特殊 token 标记的整块删除或替换。框架保留编辑点之前完整前缀,因此在这些语义边界保存的检查点,相比随机位置保存的检查点,存活概率高得多。 Agent 框架修改工具调用后的历史上下文时,有效前缀截止在该语义锚点。锚点处的检查点让全注意力层复用编辑点之前的 KV 缓存;循环层从锚点恢复执行,只需要重新预填充真正新增的后缀。检查点槽位使用 LRU 淘汰策略,和 KV 缓存池相互独立。
3.2 解码协同设计:语义感知专家缓存与\(q^*\)策略
解码阶段每个 MoE 层,路由模块与缓存查找在 GPU 上完成,识别已经驻留在缓存中的激活专家集合H,直接在 GPU 执行。剩下的核心问题:如何处理 m 个未命中的专家集合M。
语义感知专家缓存,捕捉模型计算局部性。解码阶段路由存在很强的时间局部性:连续步骤之间,同一 MoE 层反复路由到重叠、近期使用过的专家;多种 MoE 模型上都观测到该路由一致性(Liang 等人,2025)。FreeToken 利用该特性实现 GPU 驻留管理。 不在加载时设置与业务无关的静态专家放置,而是维护共享 LRU 驻留空间,缓存内容跟随路由模块选出的专家动态变化。缓存命中刷新专家最近访问时间;缓存填充加载新选中专家;淘汰访问时间最久的专家。稀缺 GPU 显存持续跟踪生成过程的当前工作集。§5.3 基于 Agent 轨迹验证该局部性,同等缓存容量下对比静态放置的收益。
缓存无法完全消除缺失:冷启动、工作集突变、缓存容量限制,总有部分专家不在显存。带宽自适应执行处理这些剩余缺失,决策哪些专家加载进缓存,哪些专家直接在 CPU 原地执行。
基于实测带宽决定缺失任务分配。FreeToken 带宽自适应执行,根据两项实测带宽:专家 PCIe 传输带宽\(B_P\),主机侧专家处理带宽\(B_H\),动态把 m 个缺失专家划分成缓存加载集合\(\mathcal{F}\)与 CPU 执行集合\(\mathcal{C}\):
\(\mathcal{M}=\mathcal{F} \cup \mathcal{C},\ q=|\mathcal{F}| \tag{1}\)
集合\(\mathcal{F}\)内专家拷贝进缓存槽,GPU 执行,后续可以复用;集合\(\mathcal{C}\)专家直接读取 CPU 驻留权重执行,不改变缓存状态。两组任务并行执行:缓存加载跑满 PCIe 速率;CPU 链路使用 PCIe 占满之后剩余的主机带宽,利用剩余带宽完成当前 token 计算,不会阻塞缓存更新。
最优分配比例由剩余带宽推导。S 代表单个专家字节大小。专家 DMA 传输与 CPU 专家执行读取同一套主机内存子系统。PCIe 跑满时剩余可用带宽:
\(B_R=\max(B_H-B_P,\ 0) \tag{2}\)
该剩余带宽即为可用于并行 CPU 专家执行的带宽。两条分支执行时间:
\(T_{fill}(q)\approx \frac{qS}{B_P},\ T_{cpu}(m-q)\approx \frac{(m-q)S}{B_H-B_P} \tag{3}\)
两条并行分支时间均衡,得到:
\(\frac{q}{m-q} \approx \frac{B_P}{B_H-B_P},\ q^{*} \approx m \frac{B_P}{B_H} \tag{4}\)
该统一公式适配全部硬件带宽配比。当\(B_H\)趋近\(B_P\),\(q^*\)趋近全部缺失数量 m,系统退化为纯按需缓存填充,不需要额外分支和策略。
实际实现中,FreeToken 将\(q^*\)取整;具体选择哪些专家进入\(\mathcal{F}\)交由缓存替换策略。保证至少保留 1 个加载任务,即使 CPU 处理大部分缺失,缓存仍然可以持续预热。\(B_H\)、\(B_P\)参数在部署硬件上通过实验采集得到。
运行时 CPU、GPU 分别计算部分输出,精确合并,MoE 输出结果无算法近似。执行顺序优先启动 CPU 分支;再运行 GPU 缺失路径:缓存更新、批量拷贝集合\(\mathcal{F}\)、合并 GPU 执行集合\(G=H \cup F\)做分组计算。CPU 工作线程同时处理集合\(\mathcal{C}\)。层最终时延由两条并行分支中耗时更长的那一条决定,也就是公式 (4) 平衡的目标。该每层控制流包含缺失检测、集合规模计算、淘汰对象选择、CPU 任务调度。整套逻辑封装进静态捕获的 CUDA Graph 是实现层面难点,§4.1 介绍兼容 Graph 的缓存与执行机制。
3.3 面向边缘原生运行时的弹性内存管理
和数据中心部署不同,边缘 GPU 资源很难独占给大模型推理。推理引擎可用显存会随应用启动、会话运行过程动态变化。并且随着上下文增长,专家缓存与 KV 缓存之间内存需求会发生偏移;引擎经常按需启停。 从磁盘构建 CPU 侧专家集合会带来用户可感知的开销。FreeToken 依靠两条机制应对这种动态变化,底层核心前提:CPU 侧专家集合是权威数据源,GPU 内存只影响性能,不影响计算正确性。
运行时缓存重配置。分配非专家权重、运行时状态之后,剩余显存预算划分给 KV 缓存页与完整专家槽。该划分不在启动时固定。在调度安全点,FreeToken 可以基于更新后的显存预算,重建 GPU 专家缓存。全程不需要重启引擎,不需要重新加载 CPU 侧专家权重,针对新缓存配置重新建立执行路径。
引擎快速启动。启动时延分为两部分:磁盘加载专家权重到主机内存;传统方案还需要 GPU 预热。FreeToken 缩短加载时间,消除预热步骤。加载流程直接把专家权重从磁盘读取到最终主机内存布局,完成数据填充之后再锁定内存;避免先锁定空缓冲区,再触发大量内存页分配清零。系统本身不需要预热:首次请求缓存冷启动,缺失交由 §3.2 普通解码路径处理;正常业务过程中缓存自动完成预热。
4 系统实现
FreeToken 沿用 SGLang、vLLM 等系统建立的 GPU 优先推理架构(Zheng 等人,2024;Kwon 等人,2023),结合分页 KV 缓存、基数前缀复用;在合适场景调用 FlashInfer(Ye 等人,2025)、Flash Linear Attention(Yang 和 Zhang,2024)社区内核库。在这套基座之上,§3 设计由两层实现组件落地:兼容 CUDA‑Graph 的 LRU 专家缓存(§4.1);底层存储与平台适配组件(§4.2)。
4.1 CUDA‑Graph 兼容 LRU 缓存
专家缓存行为高度动态:每次步骤缺失专家、拉取专家数量、淘汰槽位全部会变化。主机控制缓存会在每个 MoE 层引入昂贵的设备同步开销。FreeToken 将所有路由相关控制逻辑全部放在 GPU 侧,动态控制逻辑以数据形式保存在静态捕获的 Graph 内部,包括定长工作缓冲区、设备侧有效计数。
设备侧缓存控制。针对每个 MoE 层,单个 GPU 内核完成路由专家去重、驻留表状态判断、基于带宽的拉取数量q计算、选择淘汰受害者、把逻辑路由 ID 改写为物理槽 ID 或者 CPU 执行标记。 受害者选择规避传统 LRU 每次淘汰需要扫描全部缓存的缺陷。单遍内核一次性筛选 K 个最久未使用候选槽。缺失路径直接取用前\(q ≤ K\)个槽位。受害者查找开销固定为一次遍历,与实际缺失数量无关。生成拷贝任务列表驱动单次融合传输。所有专家 bank 使用同一套逻辑专家‑槽映射关系(§4.2),一份设备侧源 / 目标索引列表,可以一次性应用到全部 bank 的定长核调用。有效计数掩码屏蔽未使用任务。这套实现内核调用次数少,PCIe 利用率高,把路由相关决策开销从主机端移除。
Graph 内部封装 CPU 执行逻辑。带宽自适应执行的 CPU 分支同样被捕获进同一个 CUDA Graph。针对支持的解码批大小,提前分配固定锁定 IO 缓冲区、持久任务描述符。设备到主机拷贝、主机函数提交节点、并行 GPU 路径、同步节点、主机到设备结果拷贝全部封装。Graph 回放可以完整复现异构计算步骤,不需要每 token 执行 Python 调度逻辑。CPU 工作线程是绑定物理核心的持久 C++ 线程池;内核使用硬件 SIMD 指令,在内核中完成权重反量化,保证 CPU 路径受内存带宽限制。线程池输出 gate 加权的逐 token 部分计算结果。
4.2 专家存储与平台适配
专家 Bank 与 FTW 权重格式。FreeToken 把模型原始检查点布局归一化为少量专家 bank。每个 bank 以扁平化层‑专家编号\(lE+e\)作为第一维。所有 bank 内相同 ID 的行合并构成完整专家。GPU 内核、CPU 执行器使用同一套逻辑专家 ID,屏蔽底层物理存储格式差异。 为加速加载,FreeToken 定义 FTW(FreeToken Weight)格式:提前把专家权重合并为运行时 bank 布局。引擎启动时,跳过张量解析、重打包流程。使用并行直接 IO 读取对齐的数据块,直接写入主机 bank 内存;数据填充完成后再锁定内存(§3.3)。
平台适配。加载阶段,FreeToken 选择适配专家表示、GPU 架构、CUDA 环境的 GPU 内核。CPU 执行器调度到对应 SIMD 实现,匹配物理核心布局。 当完整专家集合无法完成内存锁定、DMA 注册(部分操作系统、驱动存在该限制),系统回退到纯 CPU MoE 后端。专家权重存放在可分页主机内存,全部路由专家交给 CPU 执行;非专家层依然运行在 GPU,CPU‑GPU 之间仅传输激活输入、路由元信息、聚合输出。该路径牺牲峰值传输带宽,换取更广的平台兼容性。
5 实验评估
我们在真实 Agent 业务负载下开展评估,测试完整专家集合超出显存的 MoE 模型;对比多款持续维护的边缘推理引擎,测试覆盖 6 台硬件设备。§5.1 介绍实验环境;§5.2 给出端到端主要结果;§5.3 拆解性能增益来源,验证跨硬件通用性。
5.1 实验设置
硬件:6 台独立 GPU 设备(表 1)。5 台消费级设备,覆盖当前边缘硬件主机带宽、PCIe 带宽区间;1 台工作站设备(单张 RTX PRO 6000 Blackwell,96GB 显存)用于超大模型演示。 RTX3090/4090/5090 为租用双路服务器,CPU 算力远超普通边缘主机。所有推理任务、带宽测量限制使用 6 个 CPU 线程,绑定 GPU 对应 NUMA 节点。限制后服务器主机带宽 56.7‑77.3GB/s,和真实边缘设备原生线程下带宽处于同一量级(台式机 16 核 53.8GB/s;笔记本 14 核 47.5GB/s)。台式机、笔记本无线程限制,验证仿真结果在真实硬件上有效性。表 1 中带宽全部基于实际张量测量,不是硬件规格参数。
模型:两款 MoE 模型。DeepSeek‑V4‑Flash(总参 284B,激活参 13B)(DeepSeek‑AI,2026),官方 MXFP4 量化路由专家权重。Qwen3.6‑35B‑A3B(Qwen 团队,2026)BF16 精度,保证不同引擎精度对齐;8GB 笔记本使用官方 NVFP4 版本。跨硬件对比增加 GLM‑5.2(Z.ai,2026),总参 753B,激活参 40B,NVFP4 量化专家,检查点大小 433GB,在 RTX PRO 6000 上运行。
业务负载:4 套 Agent 场景。 W1 数学推理:AIME 竞赛数学题,长思维链解码,无工具调用,单轮、解码主导。 W2 代码 Agent:基于 OpenCode 工具集解决 SWE‑bench 仓库问题,三段脚本用户轮次,真实工具执行。 W3 代码 Agent 原生协议:同样 SWE 问题,调用各引擎兼容 Claude 的接口,产生并发子 Agent,会话 token 规模 56‑65k。 W4 邮件 / 日历 Agent:OpenClaw 执行 13 轮用户交互,关闭 120s 空闲看门狗,系统上下文基线约 24.5k token。 所有引擎接收完全相同请求;代码任务必须输出标准参考补丁;W4 必须完成全部 13 轮交互。
基线系统:llama.cpp、Ollama、KTransformers、MoE‑Infinity(Xue 等人,2024),在其支持的配置下测试。权重格式严格对齐:Qwen3.6 全部引擎使用 BF16;DSV4‑Flash 全部引擎使用原生 MXFP4 专家块,比特级完全一致。
评价指标:解码吞吐(单请求平均 token/s),平均 TTFT(首 token 生成时延)。不同引擎 Agent 执行轨迹会发生分化,因此不对比端到端总墙钟时间。
表 1 测试设备。\(B_P\):PCIe 实测主机‑设备专家传输带宽;\(B_H\):CPU 侧 MoE 专家内核有效实测带宽。三台租用服务器 CPU 线程、DRAM 列为容器配额。 | 系统 | GPU (显存)|PCIe|\(B_P\)(GB/s)|CPU (线程)|DRAM|\(B_H\)(GB/s)| |---|---|---|---|---|---|---| |5090 服务器 | RTX 5090 (32 GB)|5.0 ×16|52.7|2 × Xeon Gold 6459C (32)|DDR5 180|77.3| |4090 服务器 | RTX 4090 (24 GB)|4.0 ×16|25.1|2 × Xeon Platinum 8358P (32)|DDR4 240|63.2| |3090 服务器 | RTX 3090 (24 GB)|4.0 ×16|25.3|2 × Xeon Gold 6330 (28)|DDR4 180|56.7| |5090 台式机 | RTX 5090 (32 GB)|5.0 ×16|49.0|Ryzen 9 9950X3D (32)|DDR5 192|53.8| |4060 笔记本 | RTX 4060 Laptop (8 GB)|4.0 ×8|11.8|Core i9‑13900H (20)|LPDDR5 32|47.5| |PRO 6000 工作站 | RTX PRO 6000 (96 GB)|5.0 ×16|51.5|Xeon Platinum 8559C (48)|DDR5 512|178|
5.2 主要实验结果
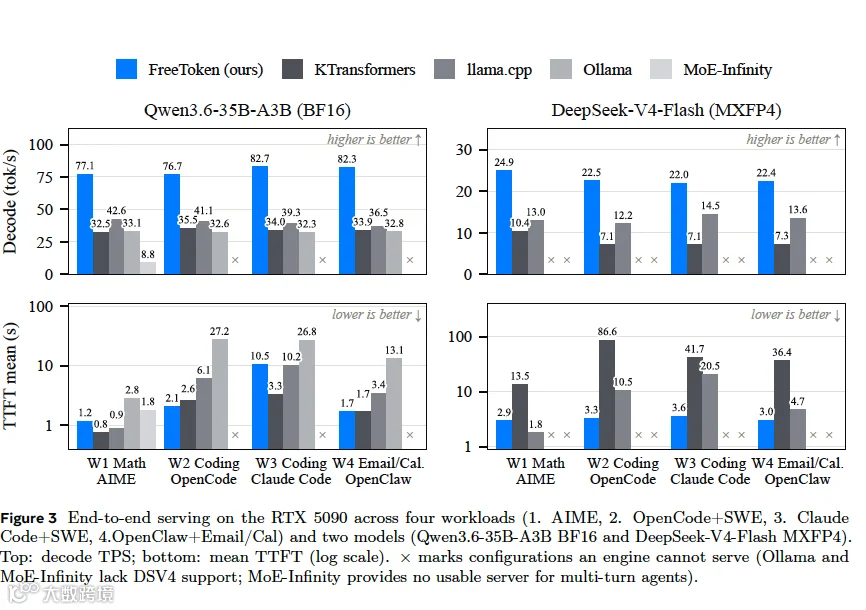
图 3 给出 RTX5090 平台上,两款模型在 4 套负载下,各引擎解码吞吐与平均 TTFT。Qwen3.6 限定 6CPU 线程;DSV4‑Flash 限定 8CPU 线程。
解码吞吐:FreeToken 运行 Qwen3.6 达到 77‑83 token/s;DSV4‑Flash 达到 22‑25 token/s。各业务负载下,对比最优基线分别提升 1.8‑2.3 倍、1.5‑1.9 倍。Agent 场景性能稳定:3 个 Agent 负载下吞吐相比单轮 W1 下降不超过 12%。基线中对上下文最敏感的 KTransformers 运行 DSV4‑Flash,W2 负载相比 W1 吞吐下降 31%。单流基准测试会高估基线在 Agent 业务的实际性能。MoE‑Infinity 仅可运行 W1(8.8 token/s);其专家预填充分段限制无法处理长提示词负载,并且服务端不会跨请求保留 KV 缓存。
首 token 生成时延 TTFT。6 组多轮实验中 5 组 FreeToken 平均 TTFT 最低(Qwen3.6 × W3 场景 KTransformers 的 GPU 预填充模块占优);W1 短独立提示词场景 llama.cpp 平均时延更低。 尾部时延差距远大于均值:FreeToken 所有实验最坏轮次时延低于 44s;每个基线系统至少一组实验超过 150s:llama.cpp 最高 232s,Ollama179s,KTransformers 高达 946s。该时延已经超过真实客户端放弃请求阈值:OpenClaw 看门狗 120s 超时,Claude Code 默认请求超时约 10 分钟。尾部 TTFT 属于可用性边界,不只是统计时延指标。
5.3 性能拆解与跨硬件分析
三组分析将端到端收益归因到 FreeToken 各项机制,验证通用性:流水线预填充(图 4a);专家缓存局部性(图 4b);全硬件范围的推理表现(图 5)。
流水线预填充。全层双缓冲让预填充阶段瓶颈变为传输带宽。开启重叠,8192token 预填充块耗时 1.19‑1.22s,等于在 52.7GB/s 带宽下完整传输 64.4GB 专家集合耗时,也就是 PCIe5.0 x16 理论上限;专家计算完全被传输掩盖,16k token 预填充吞吐达到 6.7k token/s(图 4a)。关闭第二块缓冲区,传输计算串行;4k token 吞吐下降 19%;8k token 下降 25%;16k token 下降 26%;提示词越长,被掩盖的计算占比越高,性能损失越大。
专家局部性。解码路由具备充分短程局部性。同等缓存容量,基于缺失的 LRU 策略优于预填充阶段确定的静态放置,这是 §3.2 设计的基础。图 4b 回放 4 套负载完全相同的路由轨迹,对比三套引擎放置策略。RTX5090 可用缓存容量(Qwen3.6 专家池 37%;DSV4‑Flash 专家池 11%),FreeToken 全局 LRU 解码专家读取缺失率分别为 16%、39%;KTransformers 预填充更新放置策略缺失率 41%、59%;llama.cpp 无路由感知静态划分缺失率 62%、89%。只要缓存容量达不到完整专家池,该优劣顺序在全部业务负载下均成立。
跨硬件推理效果。FreeToken 在全部测试机器上都取得优势。图 5 为 W2 业务在 5 台消费设备结果:对比最强基线,RTX3090/4090 提升 1.3 倍;5090 服务器提升 1.9 倍;5090 台式机提升 2.1 倍;RTX4060 笔记本提升 1.8 倍。8GB、PCIe×8 笔记本 NVFP4 版本达到 39.3 token/s,达到 RTX4090 性能的 92%。 两台 5090GPU 芯片完全相同,主机配置不同:服务器切换成双通道消费台式主机,FreeToken 解码吞吐仅下降 4%;llama.cpp 吞吐损失 20%,CPU 侧专家受限于双通道 DDR5 带宽。 超大模型场景:RTX PRO 6000 工作站运行 GLM‑5.2,FreeToken 吞吐 14.9 token/s,llama.cpp 为 7.3 token/s(2 倍提升);专家权重比特完全一致,平均 TTFT 接近(7.5s 对比 7.8s)。KTransformers 无法在该机器运行 GLM‑5.2:其方案要求主机内存 753GB‑1.5TB,而机器主机内存仅 512GiB;并且 CPU 内核不支持 GLM‑5.2 的 NVFP4 权重格式。

6 相关工作
专家卸载与缓存。当专家集合超出 GPU 显存,主流架构和 FreeToken 思路一致:完整专家集合保存在主机内存或者磁盘,部分专家缓存到 GPU。EdgeMoE(Yi 等人,2023)最早把该架构用于端侧推理。Mixtral‑offloading(Eliseev 和 Mazur,2023)结合 LRU 专家缓存与投机预取。MoE‑Infinity(Xue 等人,2024)分析请求级激活模式指导预取缓存。ProMoE(Song 等人,2024)、ExpertFlow(He 等人,2024)、FineMoE(Fan 等人,2025)优化路由预测器。多篇工作观测 MoE 模型家族路由存在一致性(Liang 等人,2025;Lin 等人,2025),证明缓存方案具备可行性。 上述系统专注降低缺失预测失误,但处理缺失手段只有 PCIe 传输。无论预测准确率多高,解码时延被链路带宽限制,主机算力闲置。另一类工作牺牲精度降低传输开销:HOBBIT(Tang 等人,2024)拉取低精度专家副本;SiDA(Du 等人,2024)、SMoE(Zhu 等人,2025)替换、跳过低分专家,带宽换精度;Pre‑gated MoE(Hwang 等人,2024)重构微调路由模块。FreeToken 保持路由计算精确、模型权重不修改;优化缺失任务处理方式,而不是改进预测。

CPU‑GPU 混合执行。另一类研究方向把 CPU 作为计算资源,而不只是权重存储介质。稠密模型场景:FlexGen(Sheng 等人,2023)、DeepSpeed‑Inference(Aminabadi 等人,2022)按层粒度流式加载权重面向批处理高吞吐;PowerInfer(Song 等人,2023)依靠激活统计拆分神经元,依赖 ReLU 稀疏与预测器;llama.cpp、Ollama(Gerganov 等人,2023;Ollama 团队,2023)加载时静态分配完整层到设备。 MoE 场景:Fiddler(Kamahori 等人,2024)提出缺失专家可以交给 CPU 计算,而不是仅当作待搬运数据。KTransformers(KVCache‑AI 团队,2025)通过 AMX 优化内核实现高速 CPU 专家原地执行。HybriMoE(Zhong 等人,2025)仿真每步调度重新平衡 CPU/GPU 队列。SMoE(Zhu 等人,2025)贪心双指针权衡加载与 CPU 计算耗时。也有系统将全部缺失交给 CPU(Huang 等人,2025),或者流水线 CPU/GPU/IO 面向离线吞吐(Cao 等人,2024;Fang 等人,2025)。 该方向现有系统任务划分要么启动时固定(KTransformers 即便 PCIe 空闲、缓存有空间,仍然将部分路由专家交给 CPU);要么依靠主机侧启发式算法,调度开销与层同步开销无法封装进 CUDA Graph;llama.cpp 混合模式同样无法维持 Graph 执行。并且大多针对单轮短提示词推理开展设计与评测,经常使用非量化权重;缺少多轮 Agent 工具调用场景下跨请求前缀复用机制。FreeToken 基于两项实测带宽解析计算分配比例,计算开销足够低,可以放在设备侧 Graph 内部;作为完整推理运行时,而不是单次请求工具。
推理基础设施与分层内存。FreeToken 建立在 vLLM(Kwon 等人,2023)、SGLang(Zheng 等人,2024)GPU 优先推理基座之上,借鉴 FlashInfer(Ye 等人,2025),其注意力调度开创 CUDA Graph 内部动态行为先例。 内存管理方向:SGLang HiCache(SGLang 团队,2025)将 KV 缓存在 GPU、主机、远端存储分层,保障长多轮会话前缀复用。WiSP(WiSP 作者,2026)基于边际时延,在专家权重与 KV 缓存之间划分显存。eLLM(eLLM 作者,2025)运行时重平衡弹性内存池。FluxMoE(FluxMoE 作者,2026)专家分页优先保障 KV 缓存容量。 上述内存管理器只处理被动数据;页面或者专家缺失只能执行拉取。WiSP 分析指出,无论预测精度如何,单流解码瓶颈经常是 PCIe 带宽,单纯内存分配策略无法突破该上限。专家权重多出一条自由度:缺失专家可以直接在存储位置完成计算。FreeToken 同时利用两套手段:分层内存思想用于专家集合;统一预填充‑解码驻留的弹性完整专家缓存;在同一推理基座之上叠加带宽自适应 CPU 协同执行。本文贡献在于整套集成运行时,以及协调缓存、传输、CPU 执行的实测带宽模型。
7 结论
本文提出 FreeToken,面向个人硬件运行前沿 MoE 模型的边缘原生推理服务系统。FreeToken 基于简单的观察:稀疏激活让模型计算变得可行之后,本地推理的核心矛盾不再是模型能否完整放进 GPU 显存,而是系统如何高效调度整机硬件资源。FreeToken 将 GPU、CPU、主机内存、互联总线视作统一推理平台,根据 Agent 业务动态变化、底层硬件特性,自适应调整模型状态与执行策略。 FreeToken 支持 20 余款 MoE 模型,硬件覆盖 8GB 笔记本 GPU 到工作站 GPU,可部署 35B‑753B 参数模型,持续优于现有边缘推理系统。更广层面,实验证明本地 AI 的边界,不只取决于硬件能力,同样取决于如何调度已有资源的推理软件。FreeToken 向着开源权重真正普惠使用迈出一步,让个人设备成为运行前沿大模型的实用平台。
致谢
感谢唐家明、杨淦翔参与系统测试;感谢夏天搭建实验使用的 RTX5090 台式机。
(参考文献部分省略,为论文标准引用列表)
图表说明
图 1 FreeToken 在消费级硬件上以交互速度运行成本‑能力帕累托前沿上的模型。(a) 托管模型混合 API 标价(输入输出 9:1 配比,参考真实 Agent trace 统计 token 开销(Zhu 等人,2026))与 Code Arena Elo 分数(LMArena,2026)。蓝色方块代表 FreeToken 支持模型,标注运行所需消费级 GPU;DeepSeek‑V4‑Flash 到 GLM‑5.2 这条前沿曲线全部由该系统覆盖。Kimi‑K3 虽然开源权重,但需要 594GB 内存,消费硬件无法承载;Qwen3.5‑35B 代表其继任版本 Qwen3.6‑35B,后者暂无 Arena 评分。(b) 各硬件档位最强模型在真实 Agent 负载下平均解码吞吐(前两者代码 Agent,第三个数学 Agent),和主流边缘推理引擎对比。虚线为 Codex 生产 trace 中位数 33 token/s(Zhu 等人,2026);× 标记该引擎无法部署的配置。
图 2 FreeToken 总览。(1) 预填充:全层粒度双缓冲专家加载;GPU 计算第l层,PCIe 同时流式加载\(l+1\)层;循环状态检查点锚定特殊 token 边界。上下文编辑之后,从最近有效锚点恢复,只重新预填充新增后缀。(2) 解码:绝大多数路由专家命中共享 LRU 专家缓存(示例 12 个中有 8 个命中,利用时间局部性)。\(m=4\)次缺失,通过\(q^*=m B_P/B_H\)划分任务:1 个专家通过 PCIe 拷贝进缓存;3 个专家直接在 CPU 原地执行。\(B_P、B_H\)为部署机器实测带宽。GPU、CPU 分别输出部分结果精确合并。主机侧专家集合全程作为权威数据源。
图 3 RTX5090 四套负载下端到端推理结果(1.AIME 数学;2.OpenCode+SWE;3.Claude Code+SWE;4.OpenClaw 邮件日历);两个模型 Qwen3.6‑35B‑A3B BF16,DeepSeek‑V4‑Flash MXFP4。上图解码 token/s;下图平均 TTFT(对数坐标)。× 代表引擎无法运行该配置(Ollama、MoE‑Infinity 不支持 DSV4;MoE‑Infinity 没有可用多轮 Agent 服务)。
图 4 (a) 预填充吞吐随提示词长度变化(RTX5090,Qwen3.6‑35B BF16),对比开启 / 关闭 FreeToken 流水线全层加载。(b) 解码专家缺失率随缓存大小(占专家池百分比)变化;回放完全相同路由轨迹,三套引擎放置策略对比;线条为 W1‑W4 均值,填充区间最大最小值。
图 5 消费级 GPU 上代码 Agent 解码吞吐(OpenCode 运行 SWE 问题,Qwen3.6‑35B‑A3B)。4060 笔记本 NVFP4 量化,其余 Qwen3.6 使用 BF16。RTX PRO 6000 列为独立演示,GLM‑5.2(753B‑A40B,NVFP4)运行数学负载,未运行 Ollama。× 标记无法运行配置。