

我现在觉得,WorkBuddy 里最贵的四个字可能是:“全部重做。”
模型选错了,重做;需求没说清,重做;聊了几十轮才发现方向歪了,还是重做。一套下来,活没多干多少,积分先完成了自由落体。
所以想把 WorkBuddy 用得省,先别研究怎么薅。把下面这些容易烧分的习惯改掉,效果直接拉满。
01
处理小事,先别急着把 WorkBuddy 搬出来
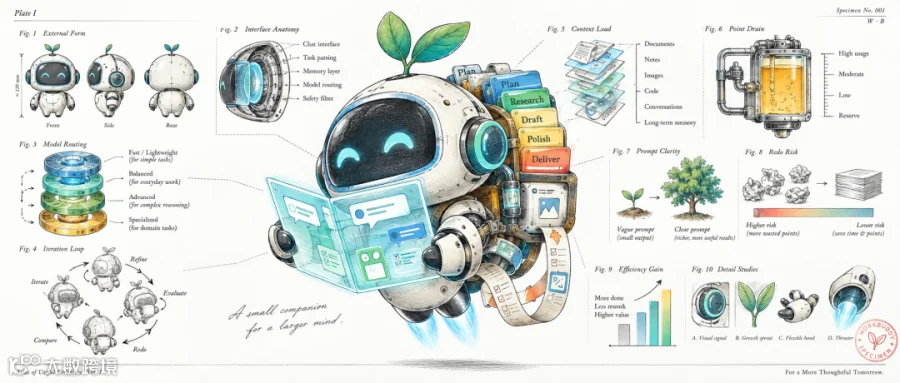
我现在打开 WorkBuddy 之前,都会先想一下:这件事到底要不要派 Agent 出场?比如“帮我改个标题”“把这句话润色一下”“翻译一句英文”,这种活,我一般不会专门叫 WorkBuddy。
毕竟让 Agent 跑一套流程,只为了改一句话,多少有点像:为了下楼拿快递,叫了一辆货拉拉。
自己 3 分钟左右能干完的,先别叫 WorkBuddy。
等任务开始涉及搜索、读取、分析、整理、输出好几步,再让它上。这种任务一旦交给 WorkBuddy,才有“这钱花得值”的感觉。光这一条,就能少烧不少冤枉积分。
02
Max 一直开着,积分哗啦啦的就扣完了
WorkBuddy 里有个很容易被忽略的东西:Max。它开着以后,会尽量保留更完整的上下文。听起来很香:“太好了,AI 什么都记得。”
但你聊着聊着就会发现,它确实什么都记得。包括上午已经废掉的方案、中午顺口问的闲话、下午那份早就不用的 PDF。然后晚上你只说一句“把第三段改短一点”,它可能还背着前面那一大包历史继续跑。
很像你让同事改一句文案,他先把今天八小时会议纪要重新读了一遍。累不累不知道,积分肯定累。所以日常写文案、整理资料、简单问答时,我一般建议 Max 关着就行。
但 Max 也不是摆设。一个复杂任务已经进行了很多轮,前面确定了大量条件、限制和中间结论,后面的步骤又高度依赖这些信息,这时候如果上下文压缩得太狠,某个关键条件被压没了,后面整条任务就可能开始跑偏。
日常杂活 → 关。
复杂长任务,而且前面的关键条件不能丢 → 开。
如果你自己都说不清“为什么这次必须保留完整上下文”,那大概率就没必要开。Max 更像一个重型模式,平时别背着跑,真遇到硬仗,再把它打开。

03
一个窗口聊到底,最后谁都累
这个坑特别常见。上午“帮我整理会议纪要”,中午“顺便查一下这家公司”,下午“我再传你个 PDF”,晚上“对了,上午那份周报再帮我改改”。一天下来,一个聊天窗口成功进化成了:项目群 + 文件夹 + 备忘录 + 垃圾桶。
问题是,前面那些已经没用的东西,很可能还挂在上下文里。所以我现在基本坚持一个习惯:一个任务,一个对话。活干完,直接新开。
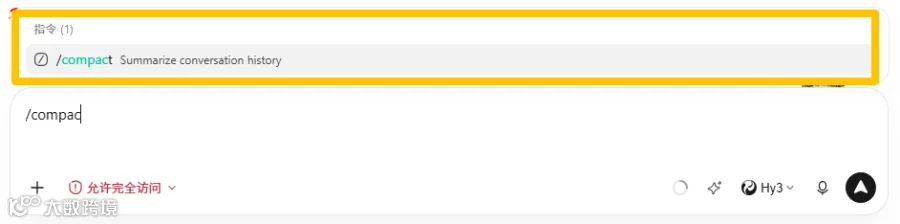
当前任务还没结束,但上下文越来越肥,可以先输入 /compact,把前面的内容压一下。如果已经聊歪了,前面的东西都不想要了,那就输入 /clear,重新来。
50% 左右,正常用。超过 70%,开始留意。奔着 90% 去了,就别恋战了。
该压缩压缩,该换窗口换窗口。聊天记录又不给你发年终奖,真没必要舍不得。
这里凡尔赛一下,因为我平时很注意这类问题,所以没有实例截图可以给到大家,这里就不做展示了。
04
别逮着一个模型往死里用
WorkBuddy 现在模型很多。最省脑子的方式,就是随便挑一个,然后永远不换。这也是最快把积分用出“玄学感”的方式之一。写一段祝福和写几十页的分析报告,显然不是一个量级。
我现在选模型,基本按任务分。普通文案、内容提炼、会议纪要、简单问答,先看 Hy3,这段时间 DeepSeek V4.1 Flash 在 WorkBuddy 还有独家优惠,纯文本、高频、小任务也很适合拿它跑。
到底便宜多少、当前倍率是多少,直接看客户端最靠谱。这些活动变化挺快,今天香,过阵子可能又换人上场。
如果任务开始变复杂,多步研究、逻辑分析、多份资料交叉比对,可以考虑 GLM-5.3 或 Kimi-K2.8-Preview。
然后还有一个最近很值得薅的:Hy4 Preview。它现在属于限时、限量免费。这种免费额度别拿去干“帮我把这句话改得高级一点”,太浪费。
长文档分析、跨文件检索、多份资料整理、复杂推理,这些本来就是积分大户。免费额度优先留给重活。
如果碰到排队,也别跟它死磕。早上十点前后、午休刚结束这类时间段容易挤。不着急就换个时间,着急就切别的模型。薅羊毛可以,别把工作也一起薅停了。
还有个小坑:Hy4 Preview 不适合拿来免费生图、生视频。这类任务可能被转给别的模型处理,该扣的积分还是会扣。

05
有些模型真看不懂你那张图
这个坑特别容易让人上火。你截了一张 Excel 报错图,往 WorkBuddy 一扔:“看看哪里错了。”过了一会儿,模型回你:“请描述一下错误信息。”你看着截图,截图看着你,气氛一度非常融洽。
普通截图、表格照片、图表、产品界面,我更倾向先用 MiniMax M3。如果已经升级到设计稿转代码、根据网页截图排查 UI Bug、GUI 自动化,或者需要看懂界面以后继续操作,再考虑 Kimi-K2.8-Preview。
模型没有这双眼睛,你硬逼它看,最后只会多花一轮积分,再自己把图里的字敲一遍。
现在看不到转其他模型或者调用MCP的过程了,所以会有种错觉,每个模型都可以理解图片,其实并不是这样的。
06
提示词多说几句,能少很多“重来一遍”
很多人为了省 Token,提示词写得跟电报一样:“整理一下。”“优化。”“做个竞品分析。”WorkBuddy 一看:行,那我猜。
然后第一版出来,你说“方向不对”;第二版“再详细一点”;第三版“换成表格”;第四版“算了,全部重做”。恭喜,最贵的四个字终于出现了。
所以我现在只要任务稍微复杂一点,第一轮就尽量把事情讲完整。至少说清楚:我要干什么、你看哪些资料、最后交什么、多长、必须有什么、什么情况下算完成。
请处理这个单次任务。
目标:生成本周工作周报。
输入资料:本周腾讯文档中的会议纪要。
资料范围:周一到周五。
最终交付物:一份 800 字以内的 Markdown 周报。
包含本周完成事项、延期事项及原因、下周计划、需要协调的资源。
不修改原始文档。
如果缺少关键信息,请开始前一次问完。
先展示执行计划,我确认后再运行。
缺什么,一次问完。先给我计划,确认以后再跑。
看着比“帮我写个周报”长多了,但它真正省掉的是后面三四轮返工。很多跑了十分钟才发现方向错了的事故,都能提前拦下来。
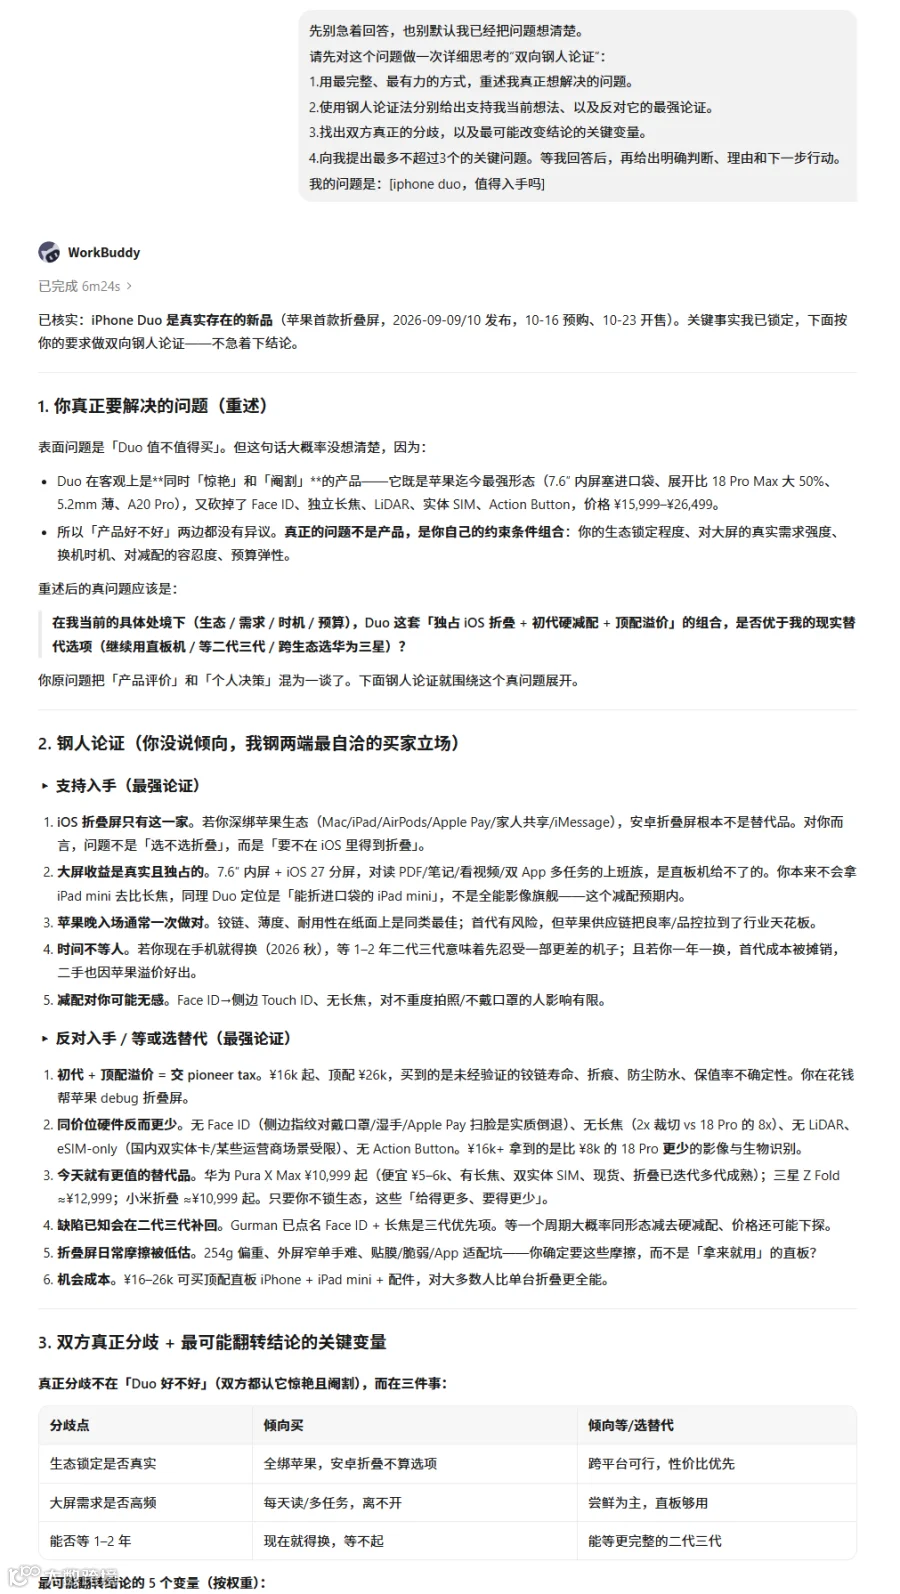
这里我分享一个经常用的提示词供大家使用参考:
···
07
大文件直接扔,多少有点肉疼
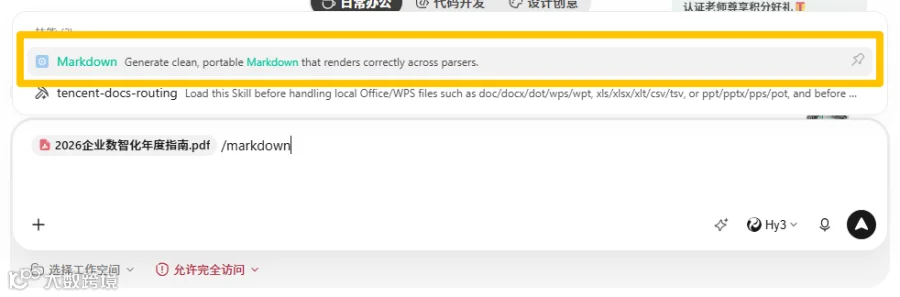
这个技巧比较隐蔽。平时要给 WorkBuddy 丢本地文件,我现在会多试一步:先输入 /,调出 Markdown Skill,再上传文件。尤其是文件比较大的时候。
这样可以让内容用更适合模型读取的方式处理,减少一部分无效上下文。文件小的时候,可能感觉不明显;文件一大,差别就容易出来。
如果你天天往 WorkBuddy 里塞长会议纪要、资料包、行业报告、一堆文字文档,这招值得试。
它属于那种操作只多两秒,长期下来却可能挺省的设置。
08
Skill 装得太满,WorkBuddy 也得先喘口气
刚开始玩 WorkBuddy,特别容易手痒。这个 Skill 看着有用,装;那个以后可能会用,装;这个虽然不知道干嘛,但名字很厉害,也装。过几天回头一看,十几个、二十几个,非常有成就感。
问题是,很多 Skill 自己都带着说明和调用规则。每次任务开始,这些内容可能一起进上下文。你今天明明只想写个周报,AI 上班第一件事却是:先阅读旁边 18 位同事的岗位说明书。它能不累吗。
只留真正高频的几个 Skill。一周都碰不到一次的,关;哪天需要,再开。那些压根不知道干嘛用的直接卸载就好。
别把 Skill 列表搞成收藏夹。收藏夹塞满了通常没人看,Skill 塞满了,模型倒是真的烧积分在看。

你看我这里就有很多,原因是每次升级后,会自动加载默认的配置,这里就要注意了,记得及时批量清理就好了,点几下完事儿
09
想换模型?先把前面的烂摊子收一收
长任务做到一半,发现当前模型不太给力,换模型很正常。但我一般不会直接切。因为新模型进来以后,也得先搞明白前面做了什么、哪些结论已经确认、哪些方案被否掉、现在还剩什么。
如果上下文已经很长,你直接切模型,相当于项目中途换人以后,给新同事发了一份“三个月群聊记录.zip”,然后说:“你自己看,下午继续。”
所以我一般先输入 /compact,把当前进度、关键结论、剩余任务压缩一下,再换模型。新模型接到的就是一份浓缩版交接文档,舒服很多。
还有一点:结果不满意时,别条件反射点“重新生成”。先找问题。缺资料,就补资料;范围太大,就缩范围;格式不对,就改格式;第三段有问题,就只改第三段。
能局部修,千万别整栋拆。
因为“全部重做”这几个字,真的很容易让前面的积分集体白干。
最后:记住谁最适合干什么活(如果忘了,就翻出来看下)
WorkBuddy 里的模型和优惠变化挺快,今天这个免费,明天那个打折。普通用户真没必要天天背价格表,我现在基本就记下面这套。
简单文案、邮件、内容提炼、会议纪要 → Hy3 / DeepSeek V4.1 Flash
最近纯文本任务比较多,顺手看看 DeepSeek V4.1 Flash 的 WorkBuddy 独家优惠。
长文档、跨文件分析 → Hy4 Preview 有限免就先薅
免费额度有限,优先留给重活。
普通截图、表格、图表 → MiniMax M3
设计稿、UI、复杂视觉 → Kimi-K2.8-Preview
复杂推理、竞品研究 → DeepSeek V4 Pro / Hy4 Preview
代码、Debug → Kimi K2.7-Code
中文正式报告 → GLM-5.3
超长文档、大型项目 → Kimi K3
一个任务一个窗口。长了就 /compact。Max 平时关,重任务再开。Skill 留常用的。复杂任务先 Plan。
做到这些以后,你会发现 WorkBuddy 的积分其实没那么玄学。真正让积分消失得最快的剧情,通常都差不多:需求没说清,先跑一遍;模型选错,再跑一遍;窗口太长,继续背着历史跑。
最后你盯着结果沉默三秒,说:“算了,全部重做。”
然后积分也沉默了。