

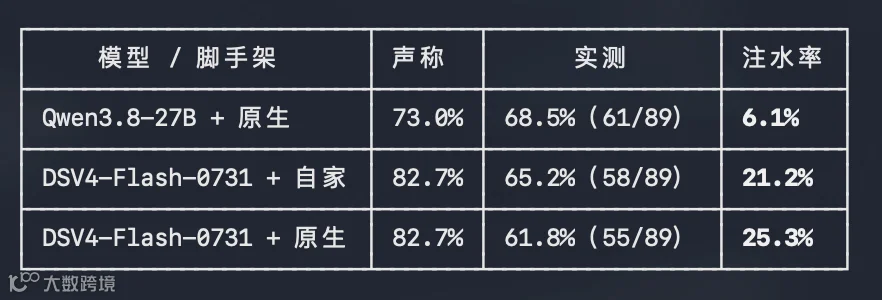
DeepSeek 和 Qwen 都在拿 Terminal-Bench 成绩做宣传。我们把 89 道题原样跑了一遍——两个模型都低于官方数字,但缩水幅度差了三倍多。所有原始记录已公开,欢迎来查。
342 次任务运行 · 7.34 亿 token · 76.6 小时 · 8×A800 80GB
01 / 结论:实测成绩与注水率
89 道题,每题跑一次,全部轨迹公开可查。
|
|
|
|
|---|---|---|
| Qwen3.8-27B
|
68.5%/73.0% |
|
| DeepSeek-V4-Flash-0731
|
|
21.2% |
| DeepSeek-V4-Flash-0731
|
|
|
注水率 =(声称 − 实测)÷ 声称。Qwen 缩水 4.5 个百分点,DeepSeek 缩水 17.5 个百分点。哪怕让 DeepSeek 用自己家的 harness,它离 82.7 也还差得远。
两条必须说在前面的限制
一、我们只跑一次,官方通常跑多次取平均。单次采样有真实波动。同一道 configure-git-webserver,同一个模型、同一个 harness,我们在冒烟测试里跑通过了,主跑里却失败了。所以「注水率」应理解为「我们这一次没能复现出来的差距」,不是精确的虚报幅度。
二、两个模型之间的差距不显著。68.5% 和 65.2% 配对检验只净胜 3 题(p=0.68),落在噪声里。这张表能说明的是「两个模型都没到宣称水平」,不能说明 Qwen 比 DeepSeek 强。
但有一个差别是稳的:同一个 DeepSeek 模型,换个脚手架差 3 题(65.2% vs 61.8%)。脚手架对分数的影响,和模型之间的差距是同一个量级。以后看到任何 Terminal-Bench 成绩,先问一句:用的什么 harness。
02 / 方法:我们怎么判对错
判分权不在我们手里。每道题自带测试脚本,跑完由它说了算。我们不改测试、不人工判断"做得对不对"。
唯一需要我们定规则的地方,是哪些失败不该算到模型头上。三条线用同一把尺子:
基础设施故障 → 不算失败,重跑镜像挂了、容器没起来、客户端超时——这些跟模型能力无关。修好环境后真重跑一遍,以重跑结果为准。不估算、不推测。
产物正确 → 算过有些题要求起一个服务。如果 agent 把服务建对了、自己也验证通过了,只是进程没活到测试那一刻,算它过——真实场景里用户会自己把服务启起来。但必须在它自己的日志里找到证据。
90 分钟用完没做完 → 算失败这条不通融。做得慢也是能力问题。
第二条最容易被质疑"放水",所以说清楚它的实际效果:这条规则只有 DeepSeek 自家 harness 涨了 3 分,另外两条线一分没涨。原因很实在——只有它会在收尾时杀掉后台进程。
被这条规则判过的三道,证据是日志里的具体某一行:
pypi-server         seq 46
  Successfully installed vectorops-0.1.0
  ← 正是测试脚本要执行的那条命令

kv-store-grpc       seq 41
  SetVal: val: 42
  GetVal: val: 42

hf-model-inference  seq 89
  200 {"sentiment":"POSITIVE"}
同样这条规则下判不过的两道:
-
mailman——服务活着,但它自己的测试显示退订没生效( member before leave? True→t+2s member=True)。产物就是错的。 -
install-windows——虚拟机检测项通过了,证明进程活得好好的;真正挂的是按键之后画面没变化,Windows 根本没进图形界面。
两条 terminus-2 线的"服务类"失败题,没有一道是进程死掉导致的,全是老实答错:虚拟机执行结果不对、棋步走错、起跳帧算成 242(正确区间 219–223)。所以它们一分没涨不是被区别对待,是确实没有符合条件的题。
03 / 错题分析:Qwen3.8-27B 错的 28 道
修完所有环境问题之后,Qwen 仍然失败 28 题。按错法分四类。
一类:压根没写出文件(6 道)
不是做错,是做到时间用完都没产出结果。测试脚本第一步就找不到文件。
|
|
|
|
|---|---|---|
| extract-moves-from-video |
|
File /app/solution.txt does not exist |
| write-compressor |
|
File /app/data.comp does not exist |
| path-tracing-reverse |
|
File /app/mystery.c does not exist |
| dna-assembly |
|
File /app/primers.fasta does not exist |
| feal-linear-cryptanalysis |
|
FileNotFoundError: '/app/plaintexts.txt' |
| winning-average-corewar |
|
my_warrior.red file not found |
二类:做到一半超时(4 道)
有产出,但没做完,卡在最后一步。
|
|
|
|
|---|---|---|
| gpt2-codegolf |
|
Compilation failed: /app/gpt2.c |
| install-windows-3.11 |
|
nginx not listening on port 80 |
| make-doom-for-mips |
|
Timeout waiting for frame.bmp |
| make-mips-interpreter |
|
Timeout waiting for frame.bmp |
三类:做完了,但算错(16 道)
这类最值得看——东西都交了,就是答案不对。
|
|
|
|---|---|
| raman-fitting |
|
| extract-elf |
|
| video-processing |
|
| model-extraction |
|
| protein-assembly |
|
| dna-insert |
|
| db-wal-recovery |
|
| regex-chess |
|
| sanitize-git-repo |
|
| cancel-async-tasks |
|
| pytorch-model-cli |
|
| mteb-retrieve |
|
| chess-best-move |
|
| configure-git-webserver |
|
| query-optimize |
|
| filter-js-from-html |
|
四类:库的 API 记错了(2 道)
这两道单独拎出来,因为它暴露的问题和"不会做"不一样。
torch-pipeline-parallelism——调 transformers 的函数时传错了参数名。报错里 Python 甚至直接提示了正确拼法:
TypeError: create_causal_mask() got an unexpected keyword
argument 'inputs_embeds'. Did you mean 'input_embeds'?
模型对高频库的 API 有很强的记忆,但记忆会过期,而它没有在环境里先查一下签名就直接写。
torch-tensor-parallelism——张量并行的切分维度算错,24 和 48 对不上,十三项测试挂了八项:
RuntimeError: The size of tensor a (24) must match
the size of tensor b (48)
另外:有一道不怪模型
filter-js-from-html 三条线全都失败,测试脚本自己报 Connection refused,是环境问题,我们没能修好。它对三边同等扣 1 分,不影响对比,但那 68.5% / 65.2% / 61.8% 里各自都缺着这一分。
04 / 两边各有所长
总分接近,但错的不是同一批题。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
Qwen 更擅长编译构建和数值工程:build-cython-ext、caffe-cifar-10、sqlite-with-gcov、train-fasttext、largest-eigenvalue、tune-mjcf。
DeepSeek 更擅长长程状态维护和精确复现:configure-git-webserver、feal-linear-cryptanalysis、query-optimize、torch-tensor-parallelism、write-compressor。
05 / 附录:我们修了哪些环境问题
这一节给想复现的人。上面所有分数都是修完这些之后的结果——如果不修,三条线一共会被环境问题吃掉 8 道题,全都跟模型能力无关。
装一个 tmux 要 293 秒,而 harness 只等 120 秒
原生 harness 在每一个容器里都要装 tmux 和 asciinema。这台机器出网只有 8–70 KB/s,装一次 293 秒,而代码里写死了 120 秒上限——模型还没被问任何问题,这道题就已经判死。
调大超时参数没用,那个 120 秒是常量。解法是做本地缓存:89 道题装的是同一个包,只需下载一次。
apt install tmux asciinema
  直连上游     293 秒
  经本地缓存    17 秒    ← 17 倍
客户端 600 秒放弃,而模型要生成 1801 秒
LiteLLM 默认请求超时 600 秒。并发跑的时候一次长生成会超时,整个回合被丢掉。regex-chess 一道题上连续触发 4 次。改成 3600 秒后再没犯过。
litellm.Timeout: APITimeoutError
  timeout value=600.0, time taken=1801.38 seconds
我们自己少给了一半 GPU
这是我们的失误,写出来留个记录。给 Qwen 起服务时只用了 4 张卡,另外 4 张全程闲着,而 DeepSeek 基线当初是 8 张跑满。对超时敏感的题,这等于单方面扣 Qwen 的分。
最难看的一次:model-extraction 有一个回合花了 79 分钟生成 17,816 个 token,合 3.8 tok/s,吃掉了 88% 的时间预算。
改成占满 8 卡后,4 路并发下单请求从约 22 tok/s 升到 76 tok/s。发现时已经跑了 36 题,我们把那轮整个作废,89 题全部重跑——混着两种硬件配置的成绩没有意义。
Debian 镜像的索引和仓库对不上
这个最隐蔽,因为它打死的不是模型,是测试脚本自己。qemu-alpine-ssh 的测试第一步要装 curl:
Err:6  curl amd64 7.74.0-1.3+deb11u16
  404  Not Found
/tests/test.sh: line 8: curl: command not found
我们先怀疑是自己的缓存代理搞坏了 URL,结果直连也是 404——deb.debian.org 的索引声明了一个它仓库里根本没有的包。换 security.debian.org 就有,好好的。
加上镜像回退之后,qemu-alpine-ssh 和 qemu-startup 直接从 0 分变满分。这两题不是模型突然变强,是测试脚本终于能跑起来了。
还有一个修正:别人的"重放"估高了 DeepSeek
此前有一份分析用重放的办法估算 DeepSeek 自家 harness 的成绩:把命令在干净环境里重跑一遍,估出 61/89。我们这次把那些题真的重跑——13 道只救回 1 道,真值是 55/89。
重放去掉了那个 harness 自己的约束,所以它估的是"没有这些约束的它",不是它本身。真实测量更低,但那才是这个版本实际交付的东西。
这次复测烧了多少
包括中途作废重跑的那一轮在内,全部账单:
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 合计 | 342 | 710.7 M | 23.6 M | 76.6 |
输入 token 远大于输出,是 agent 类任务的常态:每走一步,之前所有的终端输出都要重新喂给模型。DeepSeek 自家 harness 的输入量(3.89 亿)是原生 harness(1.77 亿)的两倍多,因为它把完整命令输出送回上下文,而原生 harness 只送 160×40 的终端窗口截图。
06 / 原始数据
三轮完整跑(每轮 89 题)外加 25 道补救重跑的全部原始轨迹已公开,没有删改:每个回合的模型输出(含思考过程)、每道题测试脚本的原始输出、以及本文用到的全部记分脚本。上文每一条声明都能在里面查到对应文件。
数据集https://huggingface.co/datasets/openguardrails/tb21-qwen3.8-27b-terminus2
测试环境:8×A800-80GB,vLLM 部署。Qwen3.8-27B 用 bf16(tp=4×dp=2,262k 上下文,MTP 投机解码),DeepSeek-V4-Flash-0731 用 fp8(tp=8)。两个模型都开到各自最高思考档位,每轮开跑前用 /tokenize 断言确认生效。每题跑一次。