


先说个真事 上周我拿刚做好的这个Skill,跑了一下润本电热蚊香液的234条竞品评价。
跑出来一份30页的报告,里面最让我意外的一个发现是:
宠物友好,是整个品类的最大蓝海。
不是"驱蚊效果",不是"无味",不是"安全"——这些所有人都知道。而是"我家猫闻了没事""狗子可以放心待"这类评价反复出现,但没有任何竞品把这个当主推卖点。
这种发现,你让豆包分析100次评价,它大概率告诉你的还是:"用户在意效果、安全和价格"。
正确的废话。
📌 说白了,竞品评价分析其实就是"听用户说真话然后找到打仗的地图"
核心就3点:
① 不是所有评价同等重要,得加权筛选
② 不是所有痛点同等值钱,得算商业优先级
③ 分析完得能落地,不能停在PPT上
搞懂这3个,剩下的都是变种。我这个Skill就是把这三件事固化成了一套自动跑的流程。
这个Skill到底是什么?
一句话:把竞品的用户评价,变成你可以直接用的差异化策略和落地文案。
它不是一个简单的"词频统计工具"——词频统计就像数一堆散落的乐高积木,你知道每种颜色有多少块,但拼不出一个完整模型。这个Skill是帮你把积木拼成成品的那张图纸。
它的完整工作流长这样:

从原始数据到可执行方案,一条龙,全自动。
它能解决的6个真问题
问题1:评价看完了,不知道该干什么
这是最普遍的痛点。运营人导出几百条竞品评价,翻了一遍,记了几条笔记,然后……就没有然后了。
这个Skill的解法:四象限战略地图。
每条评价提取出来的洞察,自动归入四个区域:
|
|
|
|
|---|---|---|
|
|
|
在这个点做得比竞品好,文案突出 |
|
|
|
新卖点来源 |
|
|
|
必须做到,不做亮点但不能掉队 |
|
|
|
提前避开 |
不是给你一堆标签让你自己想,而是直接告诉你:这里攻击,那里补齐,这里别碰。
问题2:知道用户在意"安全",但不知道哪个"安全"场景更值钱
所有做母婴品类的都说"安全"。但:
○ "宝妈+夜间+儿童房+怕孩子被咬+期待安睡" 这个场景
○ "学生党+宿舍+便宜+能用一夏天" 这个场景
这两个都跟"安全/效果"有关,但它们的商业价值天差地别。
这个Skill的解法:RecGPT + HEPO算法映射。
这是整个Skill最核心的差异化的地方。
简单说——这两个东西是啥:
○ RecGPT(就像淘宝的"猜你喜欢"引擎):评估这个场景在淘宝的生成式推荐里,有没有机会拿到高意图流量?
○ HEPO(就像餐厅排队时老板给VIP客人优先安排座位):评估这个场景匹配后,平台会不会给你的商品更高的排序权重?
两个评分加权,得出优先级排序:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
不是所有痛点同等重要。先打价值最高的那个。
问题3:分析报告很漂亮,但落地还是要自己写
传统做法:找AI帮忙分析评价 → 得到一堆结论 → 然后呢?好评怎么写?Q&A怎么埋?详情页文案怎么改?又回到原点了。
这个Skill的解法:双层输出。
○ Layer1 分析报告:数据、维度、象限、排位——给老板看、给团队同步
○ Layer2 落地行动包:直接给你做好
Layer2包含什么:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
不是"建议你怎么做",而是"给你做好了"。
问题4:刷单评价和真实评价混在一起,分析结果不准
竞品评价里有多少水分,大家都知道。但如果一刀切全不看,又可能漏掉真实信号。
这个Skill的解法:五维可信度加权。
每条评价打5个维度分:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
最后加权汇总,低可信度的评价保留但不让它拉偏结论。
问题5:不同SKU表现不一样,但混在一起看了
一个链接下面有3个规格、5个颜色、2个套餐。用户的反馈可能完全不同。"大瓶装说不够用"和"旅行装说太少了"是两个完全不同的信号,混在一起就抵消了。
这个Skill的解法:SKU交叉对比矩阵。
自动按SKU拆分,每个SKU独立评分:
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
一眼看出哪个SKU该主推、哪个该优化、哪个可能要下架。
问题6:每次分析都要重新教AI,结果还不一致
用通用AI(豆包/ChatGPT/DeepSeek)做评价分析,最大的问题是:
○ 每次prompt都不一样 → 结果不可比
○ 没有固定框架 → 这次分析了维度A,下次忘了
○ 输出格式随机 → 没法跨产品对比
○ 没有行业方法论 → 给出的都是"正确废话"
这个Skill的解法:方法论固化。
整套分析框架(五维打标→四象限→六要素映射→双层输出)全部写在SKILL.md里。每次运行,执行的是同一套标准流程。不同产品、不同时间的分析结果,完全可以横向对比。
大多数人研究"怎么让AI帮我分析",少数人在想"怎么让AI每次分析的结果都能对得上"——后者才是真正的效率。
8个适用场景
|
|
|
|
|---|---|---|
|
|
新品上架前 |
|
|
|
链接没起量 |
|
|
|
要做主图文案 |
|
|
|
详情页优化 |
|
|
|
标题SEO诊断 |
|
|
|
问大家运营 |
|
|
|
差评危机处理 |
|
|
|
选品决策 |
|
核心问题:为什么比直接问豆包更好?
说实话,豆包很强,ChatGPT很强,DeepSeek也很强。但它们是通用AI,不是电商领域专家。
具体差距在这张表里:
|
|
|
|
|---|---|---|
| 输入理解 |
|
|
| 分析方法 |
|
|
| 战略框架 |
|
|
| 算法视角 |
|
|
| 输出深度 |
|
|
| 一致性 |
|
|
| SKU维度 |
|
|
| 可信度处理 |
|
|
| 最终交付 |
|
|
| 使用成本 |
|
|
打个比方:
直接问豆包,像是找一个很聪明的通才帮你看看评价——他什么都懂一点,但不懂电商的深层逻辑,也不懂平台的算法规则。
用这个Skill,像是找一个做了10年电商运营的老兵——他不但知道怎么看评价,还知道看完之后该怎么打仗,哪个战场先打,用什么武器,连弹药都给你准备好了。
我在电商圈摸爬滚打了10年,带过数千家商家,这个Skill就是把这些年积累的分析方法论,全部固化成了可重复执行的流程。AI生成的是草稿,你的经验才是灵魂——但反过来,没有这套流程承载,经验也只是一些零散的"感觉",没法规模化。
真实案例: 蚊香液分析跑了什么出来?
上面说了,234条评价,跑完之后这几个关键发现:
发现1:护城河是"无味+安全",但竞品都没说透
○ 98.7%好评率(231好评/2中评/1差评),说明产品本身没问题
○ 用户最高频提及的正向词:无味(67条) > 安全(54条) > 效果(48条) > 宝宝可用(31条)
○ 但竞品详情页里,这些词基本都是一句带过,没有场景化展开
→ 攻击方向:把"无味"做成场景故事,而不是产品参数
发现2:宠物友好 = 品类最大蓝海
○ 12条评价提到猫/狗/宠物,全部正向
○ 原声摘录:"家里两只猫,用了这个不用担心""狗子闻着没问题"
○ 但查看市面主流竞品,没有一个把宠物友好当主推卖点
→ 蓝海机会P0级,立刻布局"养宠家庭"场景文案
发现3:用户核心顾虑是"效果确认焦虑"
即使在98.7%好评率下,仍有用户表达不确定:"应该有用吧?""还没到夏天不知道"
这不是产品问题,是信任传递问题——用户不知道怎么判断"有没有用"。
→ Q&A预埋方向:教用户自检方法(如"插上后蚊子明显少了=有效")
发现4:追评率极低(0.4%) = 长期效果缺乏社交证明
○ 234条评价只有1条追评
○ 意味着"一瓶能用多久""持续效果怎么样"缺乏真实用户证言
→ 行动:主动引导老客户追评,用积分/小礼品换取长期使用反馈
怎么用?
三步:
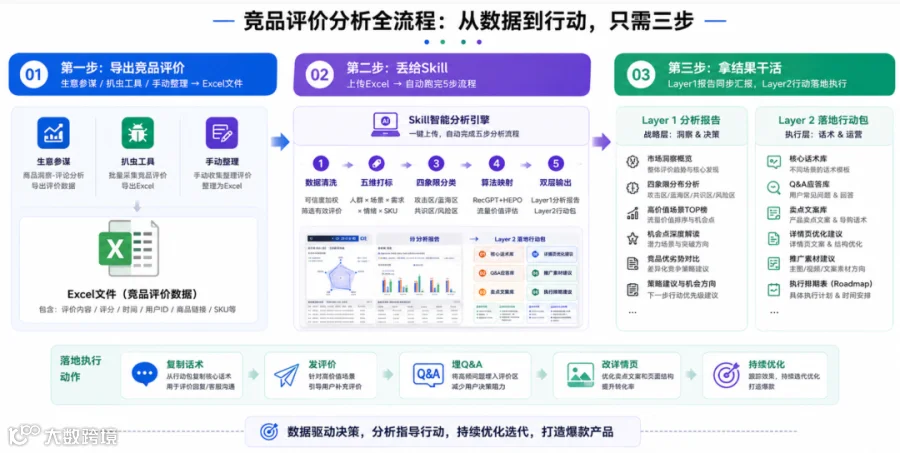
对,就这么简单。复杂的逻辑都在Skill里面封装好了,你不需要懂。
最后说句实在话
这个 Skill 不是万能的。
○ 如果你的评价数据只有10几条,它能做的不多——样本太少,啥方法都不灵
○ 如果竞品全是刷单假评价,它会标注"可信度低"——但它不能变魔术把假数据变成真洞察
○ 如果你的产品本身就硬伤累累,分析竞品评价救不了你——那得先解决产品问题
但在"有足够多的真实评价数据 + 需要从里面挖出可执行的差异化策略" 这个场景下,它比任何通用AI都能给你更有价值的输出。
因为它不只是"更聪明的AI"——它是把10年电商运营的方法论,固化成了一套可重复执行的分析流程。
方法论 > 算力。 这一直是我的信条。
如果你也在做电商或者对AI感兴趣,点个关注不迷路,我们下期继续聊~