


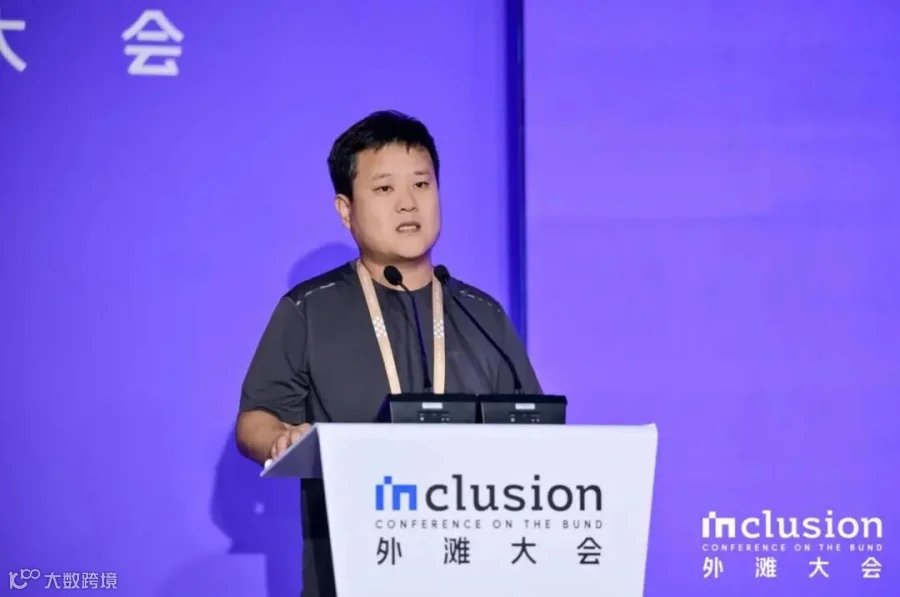
具身智能行业当前最显著的竞争焦点是数据规模。各类发布会与融资稿中,“数十万小时”乃至“百万小时”的真实数据量级被频繁提及,市场似乎普遍认为数据量的堆砌将直接催生机器人的"ChatGPT 时刻”。
然而,蚂蚁灵波科技 CEO 朱兴对此持不同观点。他认为,相较于单纯的数据数量,数据的分布与质量才是模型厂商的核心壁垒。面对行业对“千万小时、亿小时”数据的焦虑,他指出这并非解决问题的关键答案。
蚂蚁灵波成立于 2024 年 12 月,今年 7 月发布全栈大脑 2.0,8 月启动首轮融资。尽管公司在国内行事低调,但在海外技术社区已备受瞩目:其项目 LingBot 不仅入选 Hugging Face 趋势论文、获全球最大 AI Newsletter 推荐,还被 Reddit 列为知名开源 AI 项目,并得到毕马威及招银国际 WAIC 研报的高度关注,被视为 AI 从数字世界迈向物理世界的代表性案例。
这种国际关注度源于蚂蚁灵波独特的技术路线。当行业普遍为数据量和落地速度焦虑时,该公司专注于模型的原生能力,坚持从物理世界出发设计基模,而非简单嫁接数字世界模型。朱兴表示,这条路径虽更艰难,但发展上限更高。
具身智能的“百模大战”刚刚开始
具身智能赛道的热度可通过融资数据窥见一斑。过去一年多,国内该领域融资总额超 1100 亿元,日均投入达 3 亿元;2026 年上半年融资额同比增长 3.5 倍,单笔纪录不断刷新,超六成初创公司完成天使轮或 Pre-A 轮融资。
面对市场繁荣,业内也不禁发问:市场是否需要如此多的具身智能公司?投资人究竟在押注什么?朱兴认为,该行业终将像大语言模型一样走向收敛,但存在路线之分。回顾大模型的“百模大战”,最终留在主桌上的仅剩四五家,且多为选择预训练路线的企业,仅靠微调路线的玩家难以突围。
这也解释了蚂蚁灵波为何自成立之初便坚定选择预训练基模路线。尽管这意味着高投入与高风险,但也预示着更高的上限。朱兴指出,从产业格局看,具身智能最终将形成以几家基座公司为主的收敛格局,这将更有利于产业高效发展。
选择预训练路线必然要求 massive 的数据投入。灵波公布的数据显示:LingBot-VLA 2.0 在预训练阶段使用了 6 万小时高质量真实物理数据,覆盖 17 个主流机器人品牌的 20 种构型;LingBot-Depth 2.0 的训练数据规模从 300 万扩充至 1.5 亿;LingBot-Vision 的预训练语料达 1.6 亿张图像,虽比 DINOv3 小一个数量级,但深度估计精度更优。
针对研发成本,朱兴坦言“挺费钱”,但未透露具体数字。他透露,公司启动首轮融资并非因资金短缺,而是出于两大考量:一是建立核心人才与增量高级人才的激励机制,二是提升作为独立公司的治理水平,以便更好地遵循董事会和 CEO 负责制,应对行业长周期发展。
数据不是越多越好
在交流中,数据是被提及最高频的词汇。针对当下的“数据焦虑”,朱兴提出了犀利观点:当前数据采集的核心问题并非总量不足,而是场景过度重复导致无效数据泛滥。
朱兴以自动驾驶为例指出,大量采集的数据往往沦为存储成本,真正有价值的 Corner Case(极端案例)稀缺。数据过剩后,挑战在于如何获取所需的高质量数据,而非盲目追求数量。因此,灵波早已停止购买成品数据,转而采用定制化采集策略:由模型训练需求定义数据类型和分布,对高难度场景先试采并生成标准作业程序(SOP),再交由供应商规模化生产。
通过这一策略,灵波将数据从原始采集到进入模型训练的可用率从约 15% 提升至 90% 以上。朱兴强调:“数据的 Know-how 是模型厂商最核心的壁垒之一,不能将此责任推给数据采集方。”
此外,朱兴详细区分了不同数据源的价值:仿真数据适用于中后训练及特定任务强化,但在预训练阶段价值有限;Ego 数据(第一人称视角)虽理念先进,但受限于轨迹精度;互联网视频数据可用于预训练阶段的场景泛化,而真机数据则用于后训练阶段以提升具体场景成功率。
关于数据配比,朱兴表示无法简单按比例混合。由于互联网视频操作数据量巨大,若与少量的真机数据硬行混合,真机信号极易被淹没。因此,灵波采取分阶段投喂策略,在不同训练阶段使用不同类型的数据,而非将所有数据混为一谈。
撞了南墙,才知回头
蚂蚁灵波全栈大脑 2.0 的核心主张是“面向物理世界原生设计”,这一理念源自 1.0 版本的失败教训。朱兴透露,1.0 系列曾尝试基于数字世界的通用视频生成模型(如 Wan)进行微调以适应机器人,结果发现不仅上限不高,还破坏了原有模型的先验知识,导致泛化性降低。
此次挫折直接促成了行业首个具身原生世界动作模型 LingBot-VA 2.0 的诞生。该模型从动态建模、因果预测、实时执行等物理交互需求出发,基于自回归架构从头预训练,并通过语义视觉 - 动作分词器、严格因果预训练、MoE 架构及异步推理机制四大核心设计,实现了单卡 150Hz 的实时推理效率。
“机器人首要遵循的是物理规律。”朱兴比喻道,矿泉水在空中跳舞虽好看但不符合物理规律,对机器人而言毫无意义。机器人需要的是合理、高性能且实时的操作。
这一技术路线在 benchmarks 上表现优异:LingBot-Video 作为全球首个基于 MoE 架构的具身智能开源视频生成基础模型,在北大联合字节发布的 RBench 基准上总分达 0.620,超越 Wan2.6、Seedance1.5Pro 及 Cosmos3Super;LingBot-World 2.0 支持小时级实时生成及 720p/60fps 高清输出,并首次引入 Agent 机制。
朱兴指出,数字世界模型(如可灵、万相、Sora)侧重于内容的丰富性、特效与画质,可接受延迟;而机器人应用场景对物理真实性与实时性的要求截然不同。
先别急着谈颠覆
目前,蚂蚁灵波与国大药房联合打造的机器人智慧药房已在上海正式上线,这是全栈大脑在真实商业环境中的首次常态化作业。搭载灵波通用大脑的机器人能在不改变门店布局的前提下,自主完成接单、规划、移动、识别、抓取及送回药品等全流程任务。
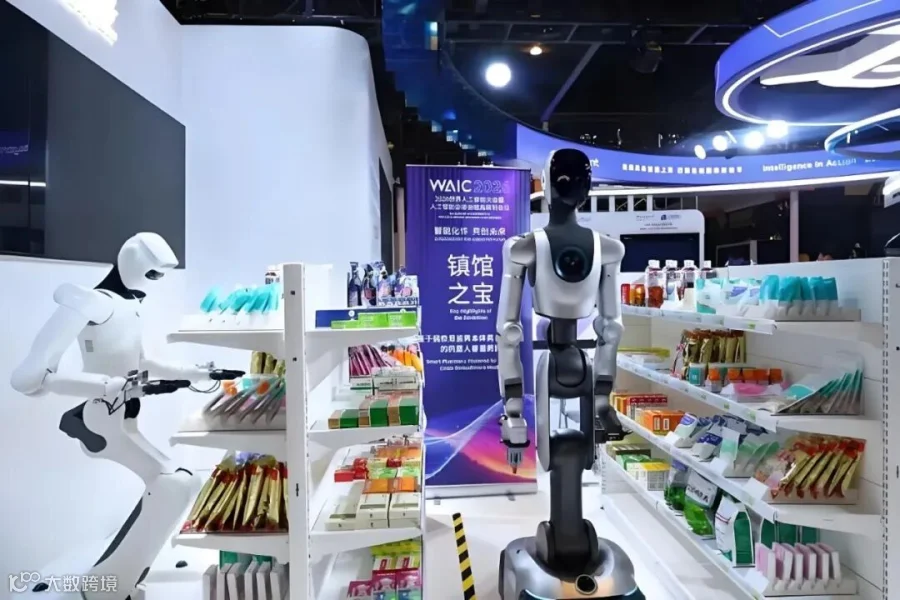
单次取药任务平均耗时不到 3 分钟,可处理超过 150 种常见药品及不同形态的包装。朱兴解释选择药房场景的逻辑:一是白天高峰期能分担药师压力,二是解决夜间订单量大且人力不足的痛点。该场景典型地涉及人机接触,需重点解决安全与 SKU 泛化问题。
尽管如此,蚂蚁灵波对商业化保持克制。朱兴表示,不会为了短期收入过度推进商业化,以免浪费团队精力,得不偿失。他将当前具身智能阶段比作自动驾驶早期,认为行业需要耐心。
对于落地条件,朱兴给出两个判断:必要条件是能力达标,即场景不能太开放、环境不能太复杂、任务不能太长程;充分条件是成本可控。目前主流可落地产品多基于模仿学习,难以应对未见过的异常情况。他预测,未来一两年内,在任务复杂度适中的场景下,商业账目将逐渐算平,生产力应用有望迎来快速增长。
一脑多机
“一脑多机”是蚂蚁灵波全栈大脑的核心能力。LingBot-VLA 2.0 已适配宇树、智元、银河通用、乐聚等 17 个品牌、20 种机器人构型,并将控制范围扩展至头部、腰部及底盘等全身自由度。
朱兴解释重视跨构型泛化的原因:中国拥有全球顶尖的硬件供应链与机电自动化人才,相比硬件,市场更需要通用大脑来适配多样化的硬件。此外,不同生产力场景(如重载作业与轻分拣)及家庭场景的需求各异,构型泛化是长期存在的刚需。
基于此,蚂蚁灵波确立了生态合作战略:核心输出智能,提供闭源版基模及工具链,帮助厂商解决后训练、数据清洗、端侧部署及真机强化学习等问题。公司明确表示不涉足工业、物流等本体制造领域,专注于基模与工具链的研发。
对于自研 R 系列机器人,朱兴说明主要出于两方面考虑:一是承载研发需求,模型训练依赖硬件产生的数据;二是服务于蚂蚁集团核心的生活服务业务,需构建合适的本体平台以探索复杂的生活服务场景(如通行、避障及安全力控),这些场景并非当前产业主流的出货方向。
慢慢来,比较快
采访最后,朱兴描绘了具身智能真正的“数据飞轮”:当前处于冷启动阶段,依赖强制采集数据;随着应用规模扩大,异常数据飞轮将自然转动。他认为,每个人在日常工作和生活中都在为机器人生产数据,但目前的模型尚无法“消化”这些未经处理的“粗粮”。
这句话精准概括了当前行业的瓶颈:数据无处不在,但如何让模型有效利用这些数据才是真正的壁垒。从全栈大脑 1.0 到 2.0,从数字模型微调到具身原生预训练,从购买成品数据到定制化采集,蚂蚁灵波正走一条艰难但上限更高的道路。
朱兴坚信,物理智能必须基于物理真实数据训练出 0-1 的基模,而非数字智能的简单嫁接。这条路的终点,是蚂蚁集团在生活服务领域积累的用户、场景、数据与具身智能的深度融合。在生活服务迈向物理智能时代的过程中,具身智能将是不可或缺的桥梁。
在外滩大会的聚光灯下,朱兴及其团队保持着难得的清醒。他们深知具身智能的"ChatGPT 时刻”尚未到来,通往未来的道路需用高质量数据一寸寸铺就。
免责声明:本文基于已公开资料及受访人提供信息撰写,不保证信息的完整性与准确性。文中内容不构成任何投资建议。