


很多独立站不会把"归因不准"当成一项成本去算,毕竟它不像广告花费有明确数额,也很少会体现在财务报表上。影响却是实实在在的:同一个 TikTok 广告系列,Ads Manager 后台显示这周 ROAS 涨了,Shopify 订单量却没什么变化,团队讨论半天,也不好判断这波增长是广告拉动的,还是本来就有的自然流量。
这类问题不会直接让店铺亏钱,但会拖慢节奏——应该加投的渠道迟迟不敢加,本该砍的渠道又留着观望。面对这种情况,独立站卖家常见的应对方式大致有两类:
1)自己动手:给每条投放链接手动加 UTM 参数,各渠道数据导出来放进一张表格里人工核对,这种方式成本低,但投放渠道一多、活动一密集,核对工作量易失控,也很难做到实时更新。
2)接入第三方的归因分析工具,把各平台的数据按统一口径采集、计算,省掉人工对表这一步。而且随着独立站投放渠道越来越分散,这种方式这两年被很多卖家接入。
不过归因只解决了"钱花在哪"这一层问题。同样容易被忽略的,是那些进店逛了一圈却没留下任何信息、看似已经流失的访客——这批人里,有多少原本还有机会被找回、转化为实际订单。归因和挽回,某种程度上是同一套数据能力需要一起解决的两侧问题。
一、为什么 ROAS,永远比订单多?
ROAS 和订单的差距,其实是数据的不统一导致的。那么数据为什么打架?
1、归因口径的结构性差异。Meta/Google/TikTok 各算各的
Meta、Google、TikTok 这些广告平台各自使用独立的归因窗口和归因逻辑计算转化,而且都倾向于将转化功劳计入自身平台。多个平台报出的转化数相加,通常会高于 Shopify 后台的实际订单数。这也不是某个平台的数据造假,而是归因口径不统一的结构性结果。
2、技术架构的演进。Shopify Web Pixel 技术
Shopify 近年将跟踪能力收拢进官方的 Web Pixels API,取代此前商家直接向 checkout 页面注入 JS 代码的做法。这套沙盒机制提升了安全性和合规性——脚本无法随意读取页面上的其他脚本或 Cookie,但代价是跟踪工具能够获取的数据被限定为一份标准事件清单(页面浏览、商品查看、加购、开始结账、完成结账等)。超出这份清单的能力,例如服务端事件转发、跨设备去重、面向 Meta CAPI 和 Google Ads 的客户匹配,需要额外的技术方案补齐。

3、隐私政策的持续收紧。iOS 隐私政策 + 浏览器反追踪
iOS 隐私新规叠加浏览器端日益增强的反追踪机制,使纯前端像素的数据丢失率逐年上升。这也是"服务端追踪"这一概念近两年在独立站行业内被频繁提及的背景。
多平台、多口径的数据要凑到一起看懂,靠人工核对基本跟不上节奏,这也是归因分析类工具这几年被越来越多独立站卖家青睐的原因。Attribuly 是这类工具里的 Shopify 精选工具之一,以它为例,拆解 Attribuly 在功能设计上,具体针对了哪几层数据问题,以及如何来帮助商家找回弃购收入和优化决策成本的。
(以下涉及的界面截图来自 Attribuly 官方演示环境,用于拆解功能逻辑,图中数据为示例数据。)
二、Attribuly 归因模型
Attribuly 的"营销分析 Marketing Analytics"可以做什么?
1) Reports Library 多合一报表库
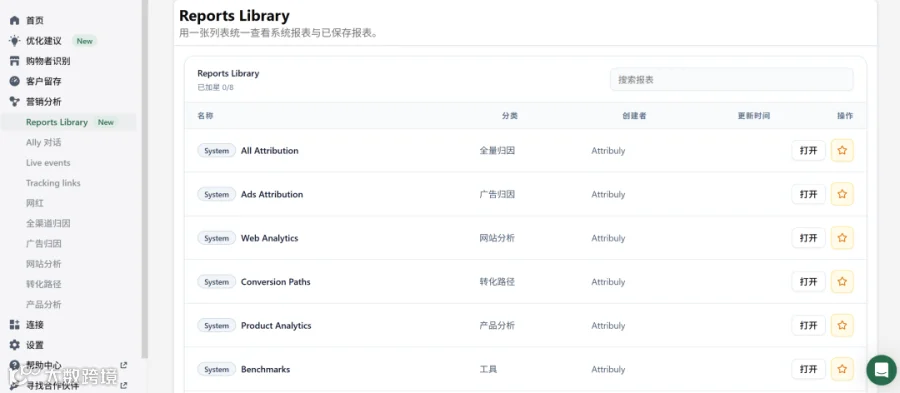
Attribuly 将全量归因、广告归因、网站分析、转化路径、产品分析等报表统一归类,原本需要在 GA、Shopify 后台、各广告平台 manager 之间切换比对的信息,可以整合进同一个报表库。这在一定程度上降低了信息核对的操作成本。
2) "广告归因"和"转化路径"完整路径
要知道广告花了钱,用户到底走了哪条路径才转化?"广告归因"和"转化路径"这两类报表使转化路径可以被完整看到。广告归因回答资金流向和渠道转化量的关系;转化路径回答了用户经过多少触点、通过哪条路径最终完成转化。从 Attribuly 两大归因功能结合来看,比单独观察某一渠道的 ROAS 更有参考价值:一个渠道 ROAS 偏低,未必代表该渠道无效,也可能是其在转化链路中承担的是认知曝光角色,如果只是采用末次点击归因,这类渠道的实际贡献会被低估。

广告归因把十余个广告渠道放进同一张表格,每个渠道下能同时看到"追踪""purchase 转化数"等等指标,不需要再逐个打开各平台后台去核对。底部"渠道重叠"也可以看不同渠道触达的用户群体之间有多少重合——这两项设计延续的是同一个思路:不只是把数据摆出来,还提示数据本身是否可靠、渠道之间是否存在打架的情况。
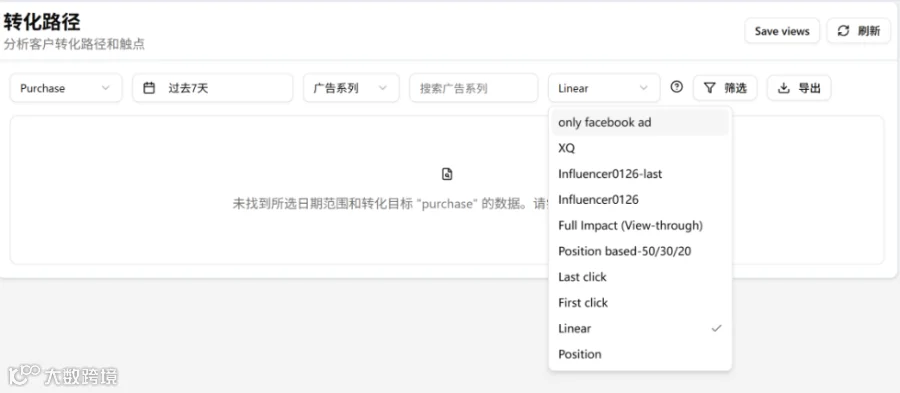
转化路径的归因模型也能切换,支持基于历史筛选条件保存成自定义视图,反复调用。同一批转化数据,换一个归因模型再看一遍,结果可能会有明显差异——一个渠道在末次点击模型里 ROAS 偏低,换成线性或位置加权模型,可能会因为承担了更多前期触点的权重而排名靠前。这也是为什么只用单一归因模型下结论,容易低估某些渠道在转化链路里实际承担的角色。
3) 工具类报表:比如 Benchmarks
Benchmarks 是一份对标报表。可以查看行业对标数据,以作为评估自身数据是否处于合理区间的参考:

查看自己店铺在同 AOV 区间店铺中的相对位置,强调数据是匿名聚合处理的,不会暴露具体某一家店铺的数据。目前已上线指标"新客 CPA",用百分位区间(Top 25%/Middle 50%/Bottom 25%)标出自己所在的位置,并能按 Google Ads、Meta、TikTok、Bing 分渠道对比;查看点击率、千次曝光成本、转化率、ROAS、营销效率等。(页尾做了方法论说明:本期对标基于多少家活跃店铺(AOV 在多少美元区间),归因口径统一用 Attribuly 的 Full Impact 模型(30 天点击 +1 天展示),输出的是经过匿名处理的百分位数据。如上图,该基准数据反映的是 Attribuly 的样本和口径,可参考。)
4) 其它细分工具:Tracking Links & Influencers
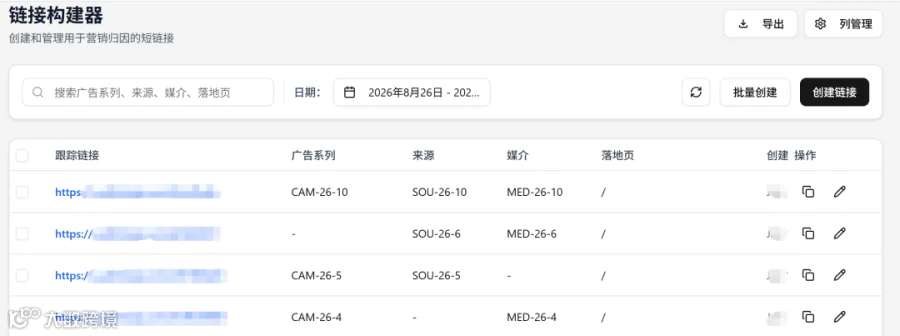
独立站与网红或 KOC 合作时,效果归因是常见的难点——多数情况下双方仅通过折扣码完成合作,后续很难追踪链路带来的实际转化。这些细分工具可以生成带追踪参数的链接,减少了手动配置 UTM 参数的操作环节,对经常开展网红投放的商家有一定实用价值。

三、从消费者身份找回到自动化触发
身份捕获 Capture 和找回 Recapture,是这类工具中功能设计相对完整的一个环节,通过提升身份覆盖率可以挽回更多收入。
广告投流本质上是广撒网式的流量获取——多数访客浏览后就离开,传统归因工具只能将其记为"流失",缺乏进一步的处理路径。这一环节存在明确的缺口:广撒网带来的流量中,有多少能够被识别并留存。
"购物者识别 Shopper Identification"下的线索捕获(Capture)功能针对的正是这一缺口——在访客未留下邮箱、未登录、未主动提交任何信息之前,尽可能捕捉这批访客的身份线索,原本会被记为匿名流失的流量,可以转化为可持续运营的名单资产。
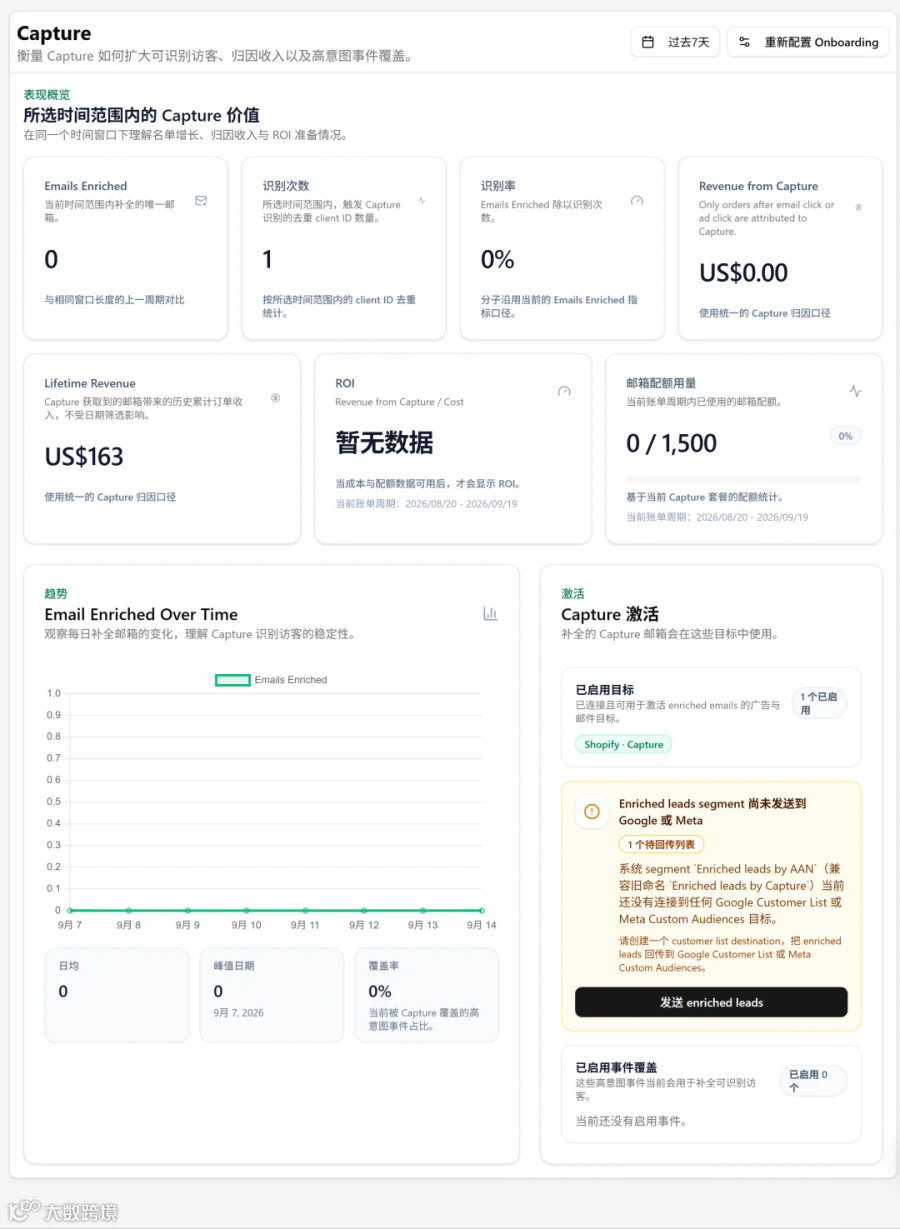
身份被捕获只是第一步,后续能不能转化为复购,取决于捕获之后是否有配套的触达机制。"身份找回"(Recapture)将 Capture 捕获到的身份信息接入 Klaviyo、CartSee、Omnisend 等自动化流程,进行重复触达,不是仅仅完成一次性识别。这也是这个模块被命名为"Re-capture"的原因——捕获是起点,持续触达与留存才是目标。

值得一提的是 Action Center 诊断功能是这一环节中设计相对完整的部分。它没有单纯展示弃购数据量,而是对配置状态进行了主动检测。如上图提示为例:"Checkout Started Attribuly SS 还没有对应的下游 Flow"——即"开始结账"事件已被采集,但缺少承接该事件的自动化流程,这条数据还未被转化为实际的挽回动作。这具有一定普遍参考价值:归因或识别类工具在实际使用中,容易出现"配置完成即视为生效"的情况——工具本身在正常采集数据,但数据链路中间某一环节缺失(如身份已识别,但未配置对应触达流程),较难被自行完整发现的隐性损耗。Action Center"主动检测 + 提示行动"的机制,相当于对数据链路进行一次结构性核查,帮助用户先完成 setup 主路径,再进入分析细节。
Ally 对话和 Live Events
同属这一逻辑范畴的其它两项功能。Ally 对话支持用自然语言直接查询数据;Live events 提供实时事件流,可以用于验证像素是否正常工作——查看访客的一次加购动作是否被即时记录,是排查追踪链路是否正常的直接方式。
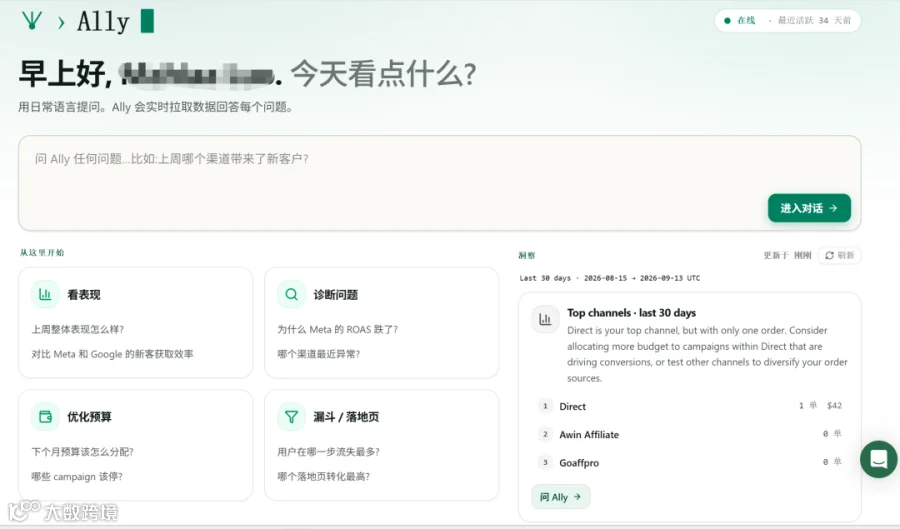
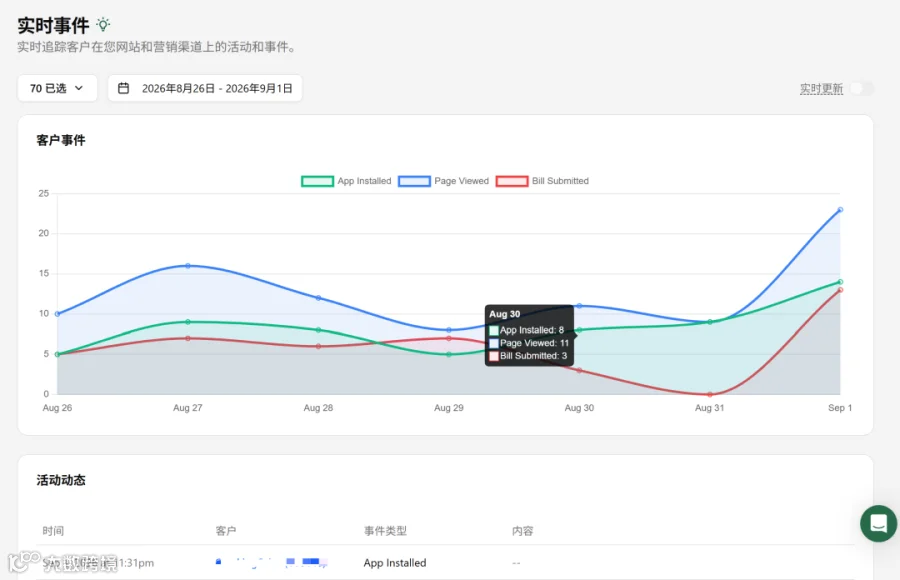
"主动诊断 + 行动建议"的设计思路,反映出归因类工具正从单纯的展示型看板,向具备主动判断能力的方向演进,补齐漏斗里的每一个缺口。
四、客户分群:谁该被重点投放?
人群价值如何被利用?Attribuly 的"客户分群"(Segments)功能,处理了归因和识别之后的内容,创造和挽回订单。
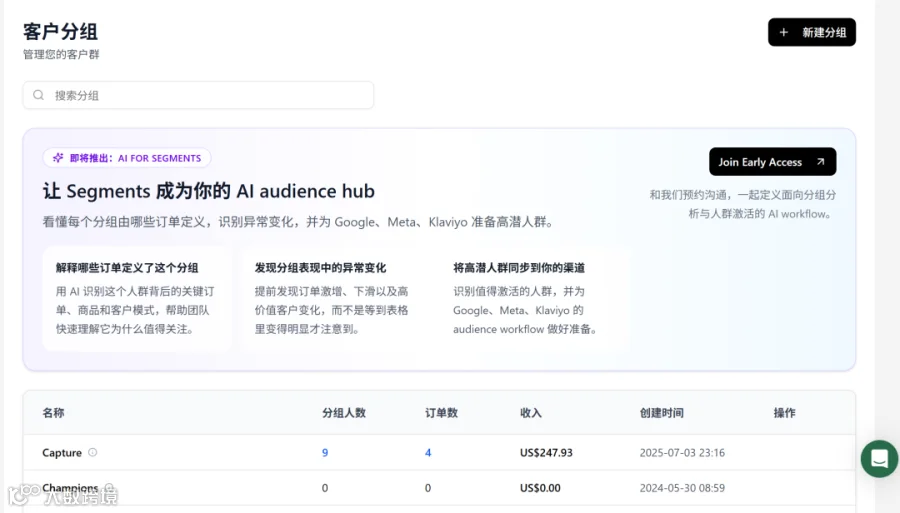
传统客户分群多采用静态规则,例如"下单 3 次以上视为高价值客户",规则在设定后较少调整。Segments 计划实现的方向是通过 AI 解释某个分组背后的订单、商品及客户行为模式,并能够提前识别分组表现的异常变化——例如订单量激增、下滑,或高价值客户流失趋势。
它的实际价值取决于分群结果能否被投放端使用。支持将客户分组同步至 Google、Meta、Klaviyo 用于广告投放——当高价值人群的特征能够被清晰定义,并同步给广告平台用于寻找相似受众,投放决策便从广撒网式的尝试,转变为基于已验证特征的定向扩量。归因解决的是资金流向的问题,分群解决的是投放对象的问题。
五、数据闭环,打通认知路径
结合以上,逻辑链条可以这么梳理:
Reports Library 将分散在多个平台的归因数据统一到同一视角;身份找回、Ally 对话、Live events 补齐可能中断的数据链路,提升识别数据的可信度;客户分群将人群价值反馈至广告投放端,减少投入决策中的盲目性;三者结合后,预算决策不用依赖经验判断,可以有相对完整的数据支撑和参考。衡量曝光点击的贡献,还可以用 AI 个性化邮件高效挽回流失订单。

1)同一批广告数据,如果把归因模型从末次点击换成线性或位置加权,ROAS 排名会不会跟着变?如果没试过,可能说明目前的渠道判断只信了一个模型的结论。
2)逛过店铺却没留下任何信息的访客,店里有没有办法把这批人识别出来,还是默认都算流失、没有后续动作?
3)识别到的这批人,后面有没有配置自动化流程去触达(比如接入 Klaviyo),还是身份找回了没能真正用起来?
从归因到挽回,中间的关键在于:资金流向能否说清楚,流失订单能否被接住。两者都理清楚,才具备把它们转化为实际收入的基础。
