


上一篇从179家竞对走到1000条差评,我们对黑人、非裔女性假发用户的理解具体了很多。
我们原来以为,她需要的是“更容易戴”。
后来才发现,她需要的是“容易戴,而且长期表现可靠”。她还担心掉发、密度不足、打结,以及寿命与页面承诺不一致。
那么,知道这些以后,独立站应该改什么?
在回答这个问题以前,先讲清楚这1000条数据是怎么来的。
这1000条差评,不是从一个平台随手抓来的
这次研究覆盖417个品牌或卖家,评价日期从2014年12月5日到2026年8月28日。
其中Amazon US有636条,占63.6%;Trustpilot有211条,占21.1%;Walmart有97条,占9.7%;Reddit的r/blackladies和r/BlackHair合计56条,占5.6%。
不同平台承担的作用并不一样。
Amazon样本来自1—3星验证购买,并且商品标题明确写有"Black women"等受众信息,用来建立产品问题基准。Trustpilot补充品牌体验,Walmart用于零售平台交叉验证,Reddit补充佩戴、清洗和长期使用场景。

图1 1000条差评样本来源结构
所有记录都要过三道门槛:产品或品牌明确面向黑人、非裔女性;讨论对象必须是假发系统产品;评论必须描述具体产品问题。
发油、洗护、胶水、工具及纯物流、支付或客服投诉全部排除。Amazon通过评论哈希去重,其他平台用来源链接、品牌、日期和摘要组合键去重。G2是B2B软件评价平台,也不纳入。
这一步看起来麻烦,却决定了后面的数字能不能解释。
这些数字代表什么,又不代表什么?
1000条样本的作用,是识别问题结构,不是计算整个假发市场的投诉率。
Amazon占63.6%,只表示样本中有63.6%来自Amazon,不能理解成市场上63.6%的差评都发生在Amazon。417个品牌或卖家,也不意味着可以直接做品牌质量排名,因为每个品牌的样本量和发言机制并不相同。
分类时,每条记录只选择一个最主要的问题,用于汇总和排序;同时保留其他问题标签。比如一条评论既提到掉发,也提到打结,汇总表只把最影响使用的一个问题记为一级问题,明细里仍保留另一个标签。
这样做,是为了让九类一级问题加起来正好等于1000,避免一条评论被重复计算;同时又不丢掉真实使用中的复合问题。
不同平台的问题结构也不完全一样。Amazon的密度、掉发和打结比较集中;Trustpilot中掉发与寿命占29.4%;Walmart的材质问题占25.8%,蕾丝问题占23.7%;Reddit样本里,掉发和蕾丝问题都占23.2%。

图2 不同平台的问题结构
这不说明哪个平台更严重,只说明各平台照见了不同体验切面,因此需要交叉验证。
很多人第一反应是改文案。
用户抱怨掉发,就写“不易掉发”;用户抱怨蕾丝不自然,就写“隐形蕾丝”;用户抱怨密度不足,就把“高密度”几个字放大。
看起来用了VOC,实际上只是把差评反过来说了一遍。
差评不能直接变成卖点
假设一条差评写着:“戴了两次就开始掉发。”
如果把它改成“持久耐用,不易掉发”,页面只是多了一个卖点。用户依然不知道:测试条件是什么?清洗以后会怎样?所谓“持久”,究竟是几次佩戴,还是几个月?
一句没有证据的正面承诺,很可能只是下一条差评的起点。
所以,差评研究做完以后,第一步不是找文案,而是识别购买风险。
掉发背后,是担心产品只能在开箱时好看;密度不足,是担心实物和模特图不一样;蕾丝明显,是担心需要大量二次处理;打结和干涩,是担心洗过一次就无法继续使用。
用户说出来的是产品问题,真正影响下单的却是对结果的不确定。
这就是差评进入DTC独立站之前,必须先完成的一次翻译。
从一句抱怨到一个页面模块,中间有五步
我把这个过程拆成五步:
用户原话—具体问题—购买风险—产品标准—页面证据。
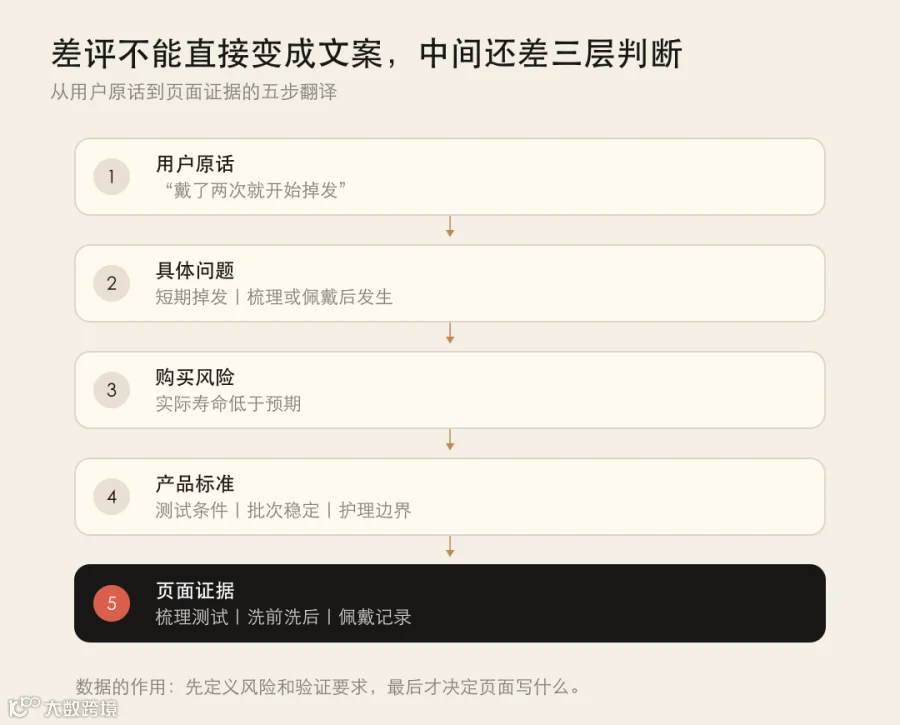
图3 差评到页面证据的五步翻译
仍然以“戴了两次就开始掉发”为例。
第一步,保留用户原话。动作、时间和结果,比“质量不好”更有价值。
第二步,识别具体问题。掉发发生在佩戴、梳理还是清洗以后?只有拆具体,才知道验证什么。
第三步,还原购买风险。消费者真正担心的是,产品只能短期使用,实际寿命低于预期。
第四步,形成产品标准。掉发怎样检测?批次表现是否稳定?哪些护理动作会加速掉发?
第五步,才是页面证据。完成验证后,再展示梳理测试、清洗对比、佩戴记录和护理边界。
注意,走到最后一步,我们得到的不是一句更漂亮的形容词,而是一组能够降低购买不确定性的证据。
1000条差评,会怎样改变一个假发产品页?
上一篇的1000条有效差评中,排在前三位的是掉发与寿命,密度与做工,以及打结、毛躁和干涩,合计占56.9%。
页面不需要写上56.9%,也不需要把所有痛点堆进首屏。先选择与产品能力直接相关、能够提供证据的问题。
第一,掉发和使用寿命,不要只靠一句"Long-lasting"
很多页面只展示刚拆箱时的柔顺效果,消费者担心的却是戴过、梳过、洗过以后还剩下什么。
如果企业做过测试,页面可以展示测试条件、清洗前后状态和护理边界。没有数据,就不要先给出确定性很强的承诺。先补验证,再补页面。
第二,密度问题,需要减少“模特图”和实物之间的想象误差
用户说“太薄”“能看到发帘”,更可能说明页面没有让她看清自己会收到什么。
除了正面造型图,还要展示顶部、侧面和背面,说明模特佩戴的长度、密度和规格,并用自然光呈现实物。参数的价值,是让消费者在下单前少想错一次。
第三,蕾丝自然不自然,不能只有一个肤色答案
对黑人、非裔女性来说,“自然”不是统一效果。蕾丝颜色、结点、发际线和肤色都会影响呈现。
页面不能只写"invisible lace",还要展示不同肤色下的近距离效果,并说明是否需要修剪、漂结或二次处理,新手能否独立完成。边界说清楚,才能帮助适合的人做出正确选择。
DTC产品页,不是卖点集合
传统产品页往往只有几张图片、几个参数、四五个卖点和购买按钮。
VOC驱动的页面要回答:用户想获得什么结果?下单前担心什么?产品怎样降低风险?企业能拿出什么证据?哪些边界必须提前说明?
所以,独立站的价值并不是比平台多写几段品牌故事。
它真正提供的空间,是把产品、证据和用户决策连在一起,回答一句话:
我为什么可以相信你?
这也回到了这个系列第一篇讲的那句话:DTC独立站,不是换一个渠道继续卖货。
如果平台和独立站都只写“高密度”“自然蕾丝”,你拥有的只是另一个商品页面,不是一套更接近用户的经营系统。
不是每条差评,都要变成一句文案
1000条差评研究完成以后,真正应该留下的不是1000句文案,而是三张表:用户购买风险表、产品验证标准表、页面证据需求表。
差评告诉你用户在哪里失望,产品标准决定你能不能减少失望,页面证据让用户在下单前看懂你做到了什么。
顺序不能反。
下一步,我们还要继续追问:如果页面上要证明低掉发、密度稳定、洗后不易打结,那么这些要求怎样进入选品、打样、质检和供应链?
如果产品端做不到,页面说得越满,风险越大。
下一篇,我们继续拆:怎样把1000条差评,反向变成产品标准和供应链要求。
哦了,这篇分享就到这儿。
数据说明 本文沿用上一篇1000条去重有效差评的分类结果,案例用于演示VOC的应用方法,不代表所有差评均对应同一款产品,也不构成对单一品牌的质量判断。