照着高分评论挑对标,翻开瑜伽垫类目切片:销量第一的垫子评分仅 3.9 分。「评分越好看越值得对标」的常识在此失效——分最低的,反而月销最凶。
「需求先行」的核心逻辑正是处理这种矛盾:别急着看产品表象,先从差评中挖掘用户真正的痛点。
切片数据显示:评论数最多的 KEEP(84 条、4.3 分),月销仅 117;而评分压至 3.9 的 Bala,月销高达 317。同样 4.8 分的两款产品中,READAEER 月销 213,BetterMe 仅 119。
面对评分、评论数、销量这三张“对不上号”的化验单,先信哪一张,决定了你接下来分析谁的差评、挤哪条赛道。锚点选错,后续功夫全白费。
CROSSBORDER NOTES先挖 84 条评论的 KEEP,还是 3.9 分的 Bala?
在瑜伽垫类目中,评分、评论数与销量往往并不正相关:
-
低分高销:评分 3.9 的那款,恰恰是类目销量第一。选对标时,需将这页切片摊开细看。 -
Bala 的反常:作为有评论款中分数最低(3.9 分)的产品,它却占据了月销榜首(317 单),且单价高达 89 美元,月销售额达 28,213 美元。
单一维度无法锁定需求:同样 4.8 分,销量相差近一倍;评论数最多的 KEEP,销量远不及 Bala。三张单子各执一词,首选问诊对象应是 Bala——卖得动却分最低,其差评与中评里才藏着用户“一边掏钱一边不满”的真实缺口。
数据仅揭示了矛盾:3.9 分拦不住 317 的销量。那么起量的关键卡在哪?对于无广告预算的新店,对标此类低分款,受阻的是评分还是流量?
CROSSBORDER NOTES新店无广告预算,对标 19.99 美元的 4.1 分款能起量吗?
既然锁定了 Bala 作为问诊对象,接下来要解决的是实操问题:新店无预算,对标切片中那款 19.99 美元、4.1 分的产品能否起量?这取决于竞争密度而非单纯评分。
数据显示,两款低分产品均能起量,说明评分并非绝对门槛。关键在于“队伍”有多长。查看大词"yoga mat"数据:建议竞价 1.55 美元,近期月排队人数高达 967,168。旺季月月百万号的“大科室”,无预算硬挤大概率陪跑。
旺季虽过,但竞争水位反升:该词搜索量从 5 月的 176 万降至 8 月的 96 万(跌幅约 45%),但建议竞价却从 0.92 美元涨至 1.55 美元(涨幅约 68%)。队列短了,参考价反而更贵,意味着剩余曝光更为金贵。
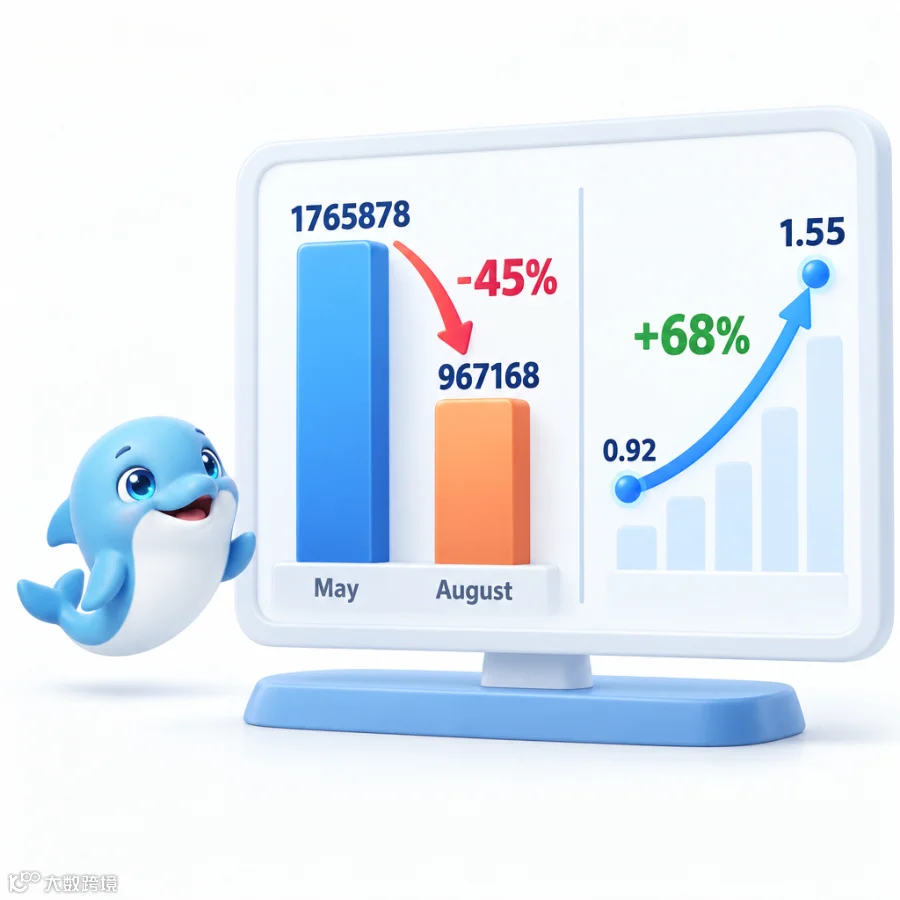
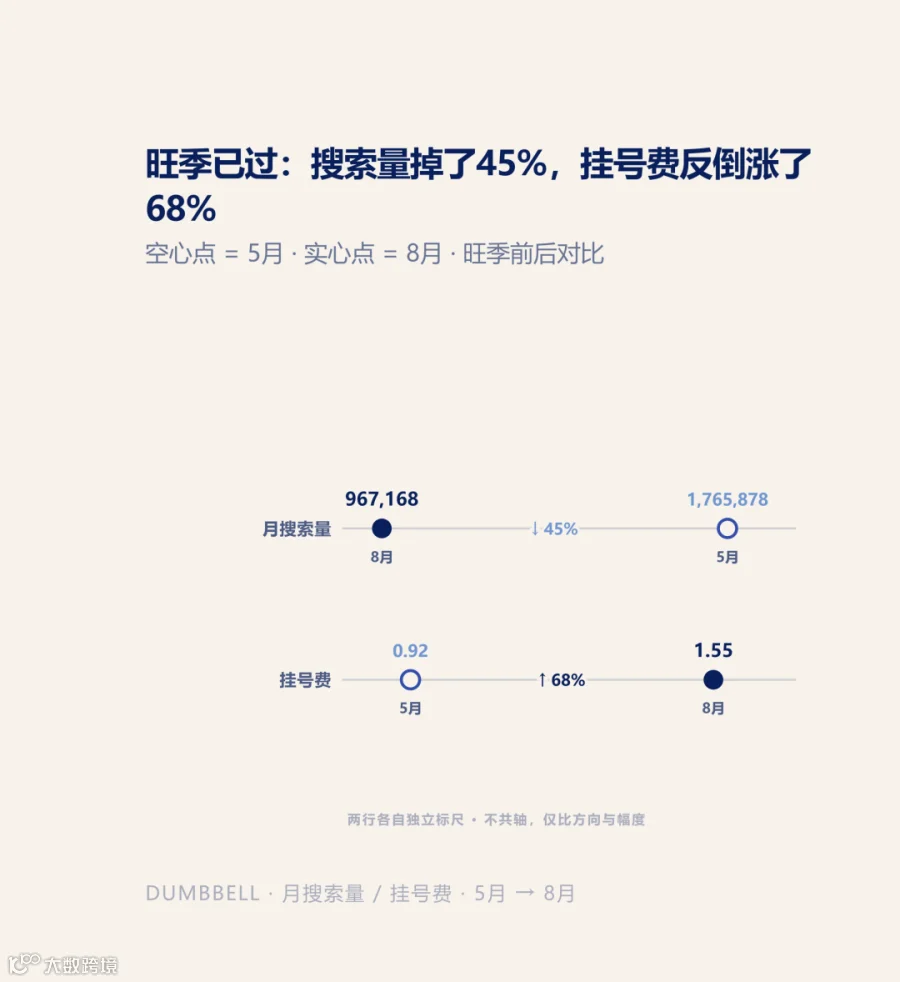
机制推测:旺季过后剩余曝光更显珍贵,导致出价被抬升。此时进场等于排最长的队,且成本并未显著降低(1.55 美元 vs 小词的 1.43 美元)。
反观“小科室”:长尾词"cork yoga mat"(软木瑜伽垫)近期月排队数稳定在 2.7 万左右,建议竞价 1.43 美元。对于无预算新店,此处或许是更好的切入点。
因此,19.99 美元的 4.1 分款能否带动起量,不看评分,先看赛道。大词竞争量级是长尾词的 35 倍,差异巨大。需进一步补查两词的竞争 ASIN 数与实际 CPC,方能判断小词是否挂得上号。
评分未拦住低分款,竞争密度才是关键。流量账只标出拥挤程度,不揭示用户需求。光看评分选品,哪些维度是数据无法回答的?
CROSSBORDER NOTES光看评分选品,哪些维度数据无法回答?
选定赛道后,下一步是“进病房”听用户声音。按流量账挑好队,回头去调取那位“挂号满员”病人的记录。他一边掏钱一边不满,缺口压在差评里,但窗口往往只递出几张好评便签。
当前数据页面无法提供差评和中评原文。借用病历却发现,窗口仅展示 5 条 5.0 星好评(如"Love it"、"Great Value"),毫无抱怨。
数据盲区不仅于此:需求滞后性无法量化,单子只记录已成交购买,从抱怨产生到转化为销量的空窗期不可见;高搜低转需搜索量对销量的转化数据验证,此页切片缺失;未满足需求的具体点,纸面上同样空白。
数据的极限在于:它能指出评分与销量脱钩时的“问诊对象”,但将脱钩翻译为可执行的需求点,这最后一步无人能代劳。
三张化验单依旧各说各话,单子只负责指引去哪个病房,病人的主诉还得亲自去听。
CROSSBORDER NOTES5 张好评、3.9 的平均分:低星评论去哪了?
有一条线索藏在数据中:3.9 的平均分本身就是低星评论存在的铁证。星级取整后平均分为 3.9,说明必有低分拉低均值,但具体数量与占比无法倒推。
这只能证明低星评论存在,无法揭示其内容。可见样本仅有 5 条好评,缺乏星级分布和差评占比,切勿拿 3.9 分强行倒推比例下结论。
评分不是品质结论,而是差评存在的收据——同一类目中,分数越低、销量越高的款,越值得优先深查其差评。
CROSSBORDER NOTES将此工作流描述发给 AI
最后一步:将以下描述原样发送给 AI(将 [品类词] 替换为你想分析的品类),它将基于 Sorftime MCP/CLI 自动搭建一套全自动化工作流:
请基于 sorftime-seller-agent (MCP) 和 sorftime-cli (CLI) 这两个 skill,
为我搭建一套「[品类词] 推新可行性」全自动化工作流。这套工作流要长这样:
一、工作流形态:
输入一个品类词,全程自动完成五件事——判断问题类型、规划数据、拉取真实数据、校验完整性、输出结论。无需手动干预每一步。
二、必要组成部分 (缺一不可):
1. 问题分类器: 先判断是选品、关键词还是运营机制问题,决定查证方向。
2. 数据规划器: 根据问题类型规划所需数据(类目报告、搜索量、竞品列表、历史趋势等)。
3. 数据获取层: 用 MCP 工具逐个拉取真实数据。
- product_search 搜竞品、keyword_extends 拉长尾词、category_trend 拉类目走势、product_customers_say 拉买家之声;CLI 工具同理。每个调用需明确参数和用途。
4. 数据完整性校验: 每轮拉取后检查关键数据(必须有真实 ASIN、趋势数据)。缺项自动补拉,循环直至数据齐全,严禁在数据缺失时输出结论。
5. 结论生成器: 数据齐全后,基于真实数字输出「推/不推」判断。
- 附 3 条核心风险 + 第 1 个月广告预算建议,每个结论必须溯源到具体数据。
三、运行规则:
- 全程自动循环: 规划 → 取数 → 校验 → 补数 → 再校验,直到数据齐备才进入结论阶段。
- 过程记录: 每轮取数结果需记录(工具名、数据类型、成功条数),最后统一汇报。
- 工具名铁律: 第一步先列出所有可用 skill 工具清单(MCP 和 CLI 各一份),后续调用仅限清单内名称,禁止自造或使用清单外工具名。
CROSSBORDER NOTES写在最后
所谓“需求先行”,并非寻找一张更灵验的数据单子,而是承认没有哪张单子直接写着产品答案——需求不长在数据里,而长在那些已经掏钱、却还皱着眉的人身上。
化验单明天照样会“打架”,随它去——挂上号只是分诊,病房的门得你自己推。下次打开后台,将类目销量榜前 20 款分别按评分、评论数、销量排序,圈出三个名次差最大的款,点开其中月销最高那款的一星、二星评论原文,认真读十条。
Sorftime MCP Skill: https://github.com/DannylydST/sorftime-seller-agent
Sorftime CLI API: https://open.sorftime.com/api
星标我们🌟,喜欢就点亮小爱心哦!
题图来源:知无不言帖子《我不再急着找产品,而是先弄清用户需要什么——需求先行型 AI 选品日报》
- END -