


GPT-6 Astra 把大模型的能力边界,又向 3D 世界推了一步。它可以操作 Blender、编写代码,直接生成 3D 模型和场景。当通用模型开始学会建模,专门做 3D 生成的创业公司会被吃掉吗?
胡渊鸣是 Meshy.ai 创始人兼 CEO,清华姚班毕业、MIT 计算机图形学博士。Meshy.ai 用生成式 AI 帮助开发者、创作者生成可直接使用的 3D 模型,是正面感受这轮能力冲击的公司之一。
他的答案很明确,Astra 会吞掉部分 3D 建模任务,但精细、可控的 3D 生成仍然需要专门的模型。在这篇文章里,胡渊鸣具体拆解了哪些场景将被通用模型覆盖、专业 3D 生成模型的价值在哪里,以及 3D AI 创业者和研究者接下来还能做什么。
本文授权转载自「胡渊鸣 Ethan」。
这几天硅谷这里大家聊得最多的问题就是 GPT-6 Astra 和 AI 攻破千禧年难题。毫无疑问,我们离 AGI 又近了一步。我自己也去系统性地玩了一下 Astra,顺便写篇短文讨论下 Astra 对我们这个行业的影响。
一句话总结:Astra 的 3D 建模能力和现在 Meshy 等产品在做的 AI 3D 建模能力是互补的,对 Mora 也是很好的基础设施。所以 Astra 能出来让我们很开心,看到了很多新机会。
本文主要讨论四个问题:
Astra 最大的突破是什么?
Astra 会取代 Meshy 等 3D 生成产品吗?
Astra 和 Meshy 在做的 Mora 有何关系?
我是在校做图形学、3D 方向科研的同学,Astra 来了以后我还有哪些能做的?
以下是关于四个问题的讨论,一家之言,仅供参考。
⬆️关注 Founder Park,最及时最干货的创业分享
我们将通过「AI 产品市集」、内容报道、社群分发等方式,帮你触达早期用户、获得真实反馈,以及建立关键连接。
如果你正在做 AI 相关的事,欢迎和我们聊聊。
01 Astra 最大的突破是什么?
如果说 Claude Code 等 Coding Agent 正在取代所有用 CLI 可以进行的操作,Astra 等 Computer Use Agent 将会更进一步把所有在计算机图形界面(GUI)上可以进行的操作都自动化。
CLI 能够进行的操作包括软件开发、运维、文档撰写、测试、信息安全攻防等。GUI 能进行的操作更加广泛,包括餐馆订餐、填税表、使用 PowerPoint、Excel 等操作。
举例来说,写代码当然很重要,但是生活中的很多事情是必须通过图形界面解决的。在美国由于外卖行业不发达,在这里漂泊的同学往往面临一些基本的生存问题。比如,不提前规划就吃不上饭,得饿肚子,要么就选择吃「草」。我的选择是宁可饿肚子也不吃草,但是又没有时间去规划,所以如果 AI 能够帮我规划,那将本质上提高我的生活质量。
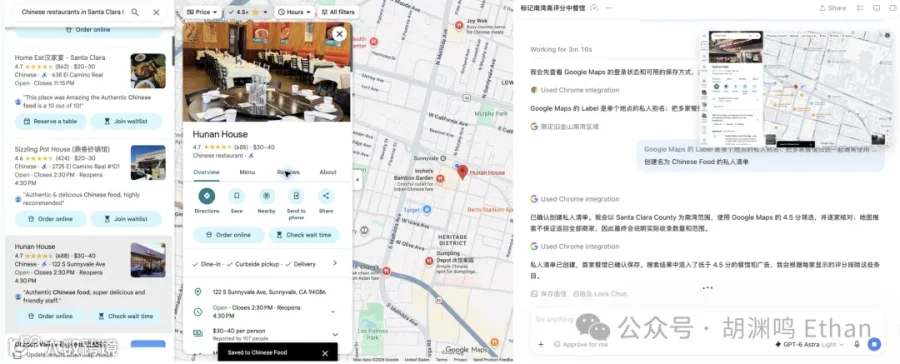
对我来说的 Astra Computer Use killer 场景:在 Google Map 里标记湾区所有中餐馆...
其他使用场景,如填税表、DMV(车管所)预约等等,我想不用多说了,这些都是痛苦来源,Astra 能解决掉,真是太好了。
除了 Computer Use 之外,Astra 在 Coding、空间理解等基础能力方面都有很大提升。我们正处于一个激动人心的时刻。所有能想到的解放生产力的东西,最终都会被做出来。
02 Astra 会取代 Meshy 等 3D 生成产品吗?
简单的回答是,不会,因为 Astra 和 Meshy 等产品的能力是两种能力。下面是比较详细的分析。
由于 Astra 在 Computer Use、Coding、空间理解能力三方面的加强,使得一部分 3D 建模的场景能够直接被 Astra 解决。我们可以分解 Astra 的能力:
Computer Use 能力,让 Astra 可以操作 Blender 等软件,并且通过屏幕的截图评估现状,对下一步做出规划;
Coding 能力,让它可以直接通过写代码生成一些基本的模型,比如说楼房、汽车、飞机等工业制品;
空间理解能力,顾名思义,可以让他写的代码、对 Blender 等软件的操作更加科学、符合 3D 空间的规律。
其实对于每天在做 3D 生成相关的同学来说,这三方面的能力并不是新鲜事,技术发展反而是非常渐进的,Astra 发布之前玩 Fable 其实也能感受到其中的一些能力。
对前沿比较了解的同学,估计早就把自己在做的方向根据「Astra 这样的模型迟早要出来,我的工作不能被吞噬」这样的约束规划过了。
那么,是不是有一些 3D 建模的场景已经被 Astra 吞噬了?肯定的。3D 场景生成、参数化建模、CAD(工业)零件生成、一部分低模生成(特别是建筑、机械类资产)、一部分程序化生成,基本上会被 Astra 和 Astra 的后继模型在能力上吞噬。
不过,这些任务需要的本质上是 Coding 或者 Agent 的能力,并不是 Meshy 等公司现在在做的精准还原的能力。为什么外界会觉得 Astra 能够取代现在的 3D 生成公司?主要原因就是外界有点把 a) Astra 的 Coding 和空间理解能力 和 b)3D 细节的建模和生成 混为一谈了。
换句话说,Astra 的能力和 Meshy 的能力是两种能力。Astra 擅长大体结构,所以相对简单的机械元件 Astra 完全没问题,给他一个图建一个简单的火箭模型也没问题。Meshy 在做的事是精准还原用户想要的输入。
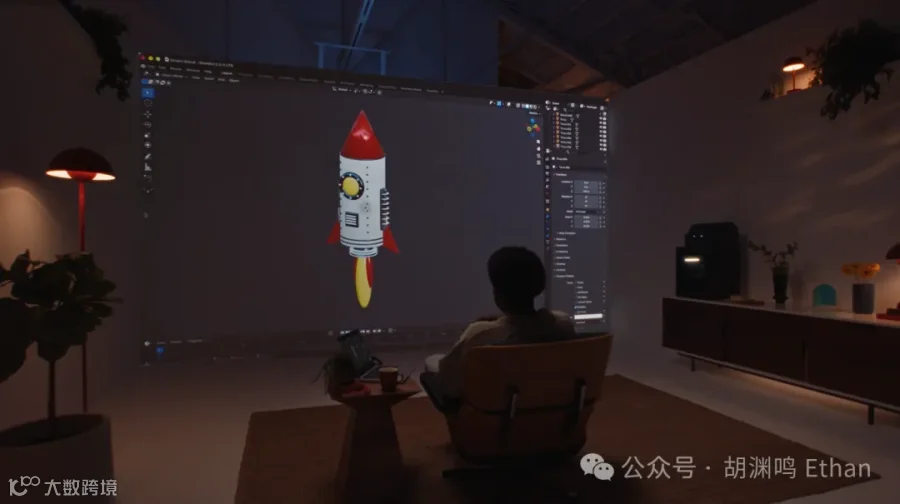
OpenAI Astra 宣传片里面的火箭其实属于简单的机械元件,也不需要和输入图像精准还原,其实几个月前的模型如 Opus 4.5 和 Fable 就能建出来了,只是 Astra 能力更强了。

Meshy 等工具要做的是精准还原图片里的内容。Meshy 7.1 的 4K mesh 输出甚至能够还原布料上的纹理:Meshy 7.1:极致细节,目之所及
我如果硬用 Astra 去解决 Meshy 等产品在解决的精细模型生成问题,会怎么样?可以试一下,一定会遇到质量问题和成本问题。

输入图

两种路线取得的结果
质量问题 是因为 Astra 等 VLM 很擅长理解「人脸上面有两个眼睛、一个鼻子、一张嘴巴」,也能够识别出来图片里面的角色手上拿着一把剑,但是并不擅长描绘「眼睛有多大?」、「剑是被什么角度拿着?」。这些都不是 Astra 的训练目标。所以你给他一张照片,他能还原出一个人,但是往往很难辨认到底是谁。还原度和美学都会成为很大的问题,导致结果不可用。下面是一个例子。
成本问题 是因为基于 Diffusion / Flow Model 的多模态生成算法客观上是比基于 AR 的生成训练更加高效、推理更快的方法。Astra 建一个模型需要十几分钟甚至更长,基于 Diffusion 的生成模型只需要一分钟以内。
未来 Astra 会不会吞噬 Meshy 7.1 这样的高模?在已有的技术范式下,还看不到。就像 LLM 短期不会吞噬 Image generation 和 Video generation 一样。从学术一些的角度看,这里本质上在讨论的是,理解能力和生成能力是两码事儿。LLM、VLM 做的是理解(Understanding);Text to Image、Image to Video 等基于 Diffusion models 的多模态生成的模型的能力是(Generation)。
目前有很多工作(Emu、Uni-1、Reve 等)在尝试进行理解生成的统一以及多模态生成的统一。对于「理解能够帮助生成」这一点大家有共识,但是反过来「生成对理解是否有帮助」大家尚未有共识。所以实际上,工业界主要采取的做法还是通过理解模型(LLM/VLM)去做 Prompt expansion,再用生成模型基于这个 prompt 去生成。主流图像生成模型、视频模型都是这么做的。
那么,为什么 Astra 没有显得冲击了图像生成和视频生成公司,但是外界会认为 Astra 对 3D 生成公司有影响?我觉得主要是两个原因:
用 Coding agent 相关能力做 Image Gen(比如 GPT Images 2 能出的 Infographics)或者 Video Gen 其实是这俩行业里面司空见惯的事情了,基于 LLM 的 Image/Video Prompt expansion 大家已经很熟悉了。但是 3D 生成发展慢 6-12 个月,所以一些 3D 行业里面的同学也会觉得 Astra 来的比较突然,因为 LLM / Agent 还不是广泛被用于驱动 3D 生成的前置系统。
3D 生成确实有一些使用场景,不需要太多细节,甚至几何复杂度越低越好、越参数化越好。比如低多边形这种风格就非常容易被 coding 来实现,一些游戏由于三角形面数的限制,也会使用较为简单的模型。Astra 已经能够生成这些模型并且在一些场景上满足用户需求。
实际上 Astra 的空间理解能力对 3D 生成是很好的助力。比如,可以用 Astra 驱动 Meshy 的 T2 模型的 API,给定一张图生成完整的场景:

03 Astra 和 Meshy 在做的 Mora 有何关系?
Astra 对 Mora 在需求和技术方面是很好的消息。具体来说:
从需求角度,我一直是比较相信 2027 年底之前 AGI 能被实现的,也就是 400 天以后,人们的很多枯燥的工作都可以交给 AI。这使得解决「人类不需要工作以后从哪里获得快乐和意义感」变得无比重要。这会让 Meshy 的使命「AI for Fun」变得尤其重要。Astra 在 Computer Use 方面的进展无疑让我更相信这一点。
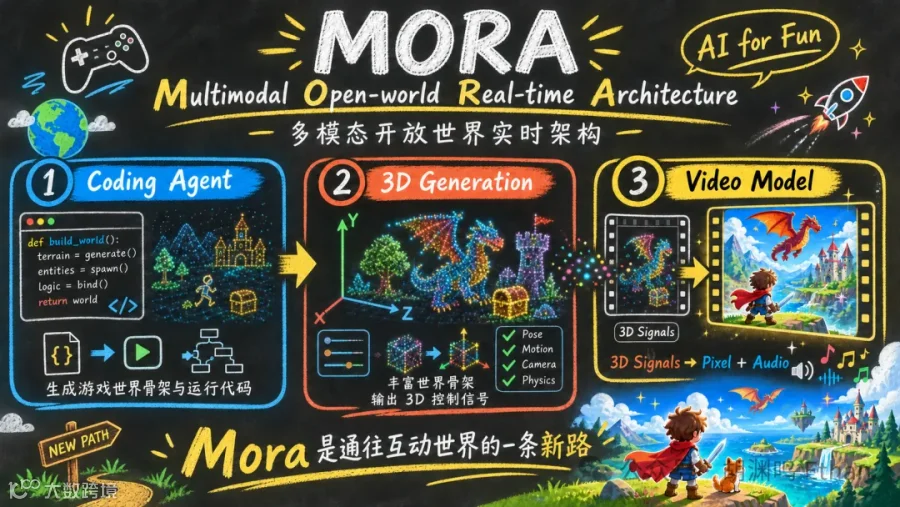
技术方面,Mora 架构设计之初的一个动机就是「Mora 的能力要随着市场上 coding agent 的能力水涨船高」。Astra 在 coding、空间理解方面的能力可以帮助 Mora 产出更好的 3D 关卡和机制。
关于 Mora 的更多细节请移步胡渊鸣 | Mora:超越「世界模型」
04 我是在校做图形学、3D 方向科研的同学,Astra 来了以后我还有哪些能做的?
其实有意思的方向还有很多,我一直觉得做图形学方向优秀的同学基本功大多是很好的,能做非常多的事情:
GPU/AI infra。图形学的同学对 GPU 的理解能够支撑很多有意思的研究,AI Infra 领域,特别是基于 Agent 的 Infra 开发,如 Kernel Design Agent,是很重要的话题,也是今天 Recursive Self Improvement 的重要的一环。无论智能如何演进,Infra 本身总是需要的。Hopper / Blackwell 等新的 GPU 架构能够给 graphics 和 3D 带来哪些帮助?当然,这个方向有个好处就是对算力消耗不大,消费级显卡上也能做不少事情。
Real-time video model 和 Neural rendering。参考 Mora 的架构设计,低延迟、高可控的 Video model 网络架构应该是什么样的?这可能是下一代图形管线。随着 AI for Fun 这件事情推进越来越深入、应用场景被不断解锁,这方面能做的事情会被不断打开,至少是一个比以前「Real-time rendering」更大的大话题。
Coding 与 Agent 的理解能力如何与图形学想实现的「创造一个生动的虚拟世界」结合?比如说,3D 场景生成基本上就被 Astra 解决了,但是低延迟、实时生成的开放世界如何做?如何衡量 AI 生成的游戏机制是否好玩?
面向 3D 打印的 3D 设计算法。3D 打印依然是一个出货量每年增长 20% 的大市场,全球有 3000 万台 3D 打印机,但是可打印的内容依然是稀缺的。如何让大众也能创作出独一无二的 3D 打印设计?
一些能够带来新的 insight 的基础性方向,如几何、仿真、渲染的一些底层话题。在有了强力 agent 的时代,这里面的很多问题可能会有全新的解法,让我们对一些问题的理解更加深入。这类方向的研究很多时候不能产生直接的影响力,但是乐观来看至少是一种对能力的锻炼。从找工作角度来说,不见得是最优解。(如果你在做这些硬核的方向,锻炼了扎实的数理或者编程基本功,别的地方找不到好工作,那欢迎考虑一下 Meshy。我们很喜欢基本功扎实的同学。)有的时候,更深入的理解本身比取得问题的答案更重要,这一点上我一部分同意 Terence Tao 牵头的联名信《A Severe Misalignment of AI in Mathematics》。(但另一方面,我也尊重用 AI「暴力」搜索底层新解法的尝试,能解决问题的方法就是好方法。)
...
一点浅见。前三个问题是我们在做的 Mora 方向里面比较关键的问题,如果大家对这些问题有兴趣,也欢迎和我们联系。
另外,具身智能方向我没仔细思考过,等我和周围做这个事情的朋友聊过一圈下来再发表意见吧。这个方向的研究一定是有意义的,只是有个 timing 的问题。
总结下来,其实 Astra 并不像外界认为的那样,会对 3D 行业有啥大的影响。因为对于在 3D 行业里面的人来说,Fable 等模型一路看下来,coding 能够解决 3D 简单模型的建模和参数化建模是迟早的事情,Astra 也不是突变。而对于部分古法图形学的话题来说,不管有没有 Astra,这些话题都已经不再是能做出大影响力工作的关键研究话题了。(当然,图形学社区依然可以用这些问题来培养人才...)
05 「智能」和「体验」需要不同的模型
最后,表达一个观点,也就是「智能和体验需要不同的模型」。也是为什么我们 Meshy 今天在做 AI for Fun 的原因。
AI for Work 和 AI for Fun 是两个不同的东西。前者 optimize for intelligence,后者 optimize for experience。
这就好像科学和艺术是两码事,科学主要追问「世界如何运作」,艺术主要探索「我们如何体验和表达世界」。
Astra 无疑朝着 AI for Work 这个方向又近了一步,接下来的 400 天,一定还会有更多激动人心的进展,AI for Fun 会更加重要。
Meshy 追求的「用 AI 实现快乐的无限供给」这个使命,不但没有受到 Astra 影响,还得到的了需求的进一步加强、可用工具的进一步扩展。


对话 xLean 薛轲翰:扫地机产品远没有到头,清洁机器人可以是 Family Agent 的起点