大数跨境

横扫四榜,DM0.5 凭什么面面俱到?

横扫四榜,DM0.5 凭什么面面俱到? AI科技评论
2026-09-15
6
导读:单科冠军不够,具身智能落地需要没有结构性短板的底座
单科冠军不足恃,具身智能落地需无结构性短板的通用底座

    作者丨邓哲敏

    编辑丨齐铖湧

单一模型同时斩获四个能力子榜单榜首,在具身智能行业极为罕见。RoboColiseum 是由智元机器人发起,联合高校、科研机构及企业共建的评测平台,将评测拆解为指令跟随、空间理解、扰动适应、通用操作四个维度。参评模型若在任一维度存在结构性短板,排名便会大幅下滑。
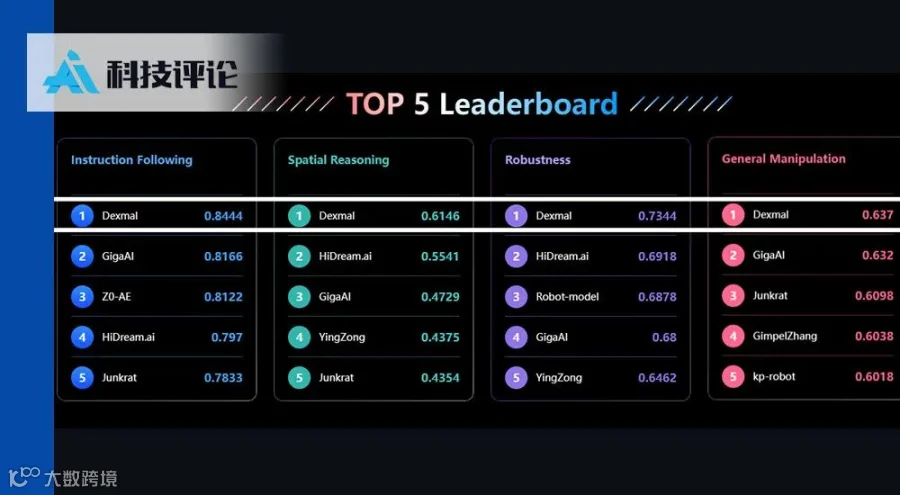
原力灵机发布的通用具身基础模型 DM0.5,在上述四个子榜中均位列第一,也是目前唯一达成此成就的模型。
这张成绩单的可信度如何?DM0.5 霸榜背后的技术逻辑又是什么?

01


一把可信的标尺:解决行业三大痛点

演示效果与真实场景的差距是机器人行业的顽疾。模型越层出不穷,行业越需要可信赖、细颗粒度的公共标尺。然而,当前具身评测行业长期存在三大痛点,导致分数可信度存疑。
痛点一:仿真跑分高,真机落地差。仿真环境与真实世界在物理参数和视觉渲染上差异巨大。针对 Sim2Real 一致性问题,RoboColiseum 通过空间智能技术高保真重建真实世界,配合激光雷达还原几何信息,并对物体质量、摩擦力及机器人本体参数逐项校准。验证结果显示,仿真与真机表现一致性达 89.5%,单任务成功率差异小于 10%。
痛点二:评测基准生命周期短。具身模型迭代迅速,旧榜单易被“刷穿”。RoboColiseum 现有 78 个评测任务、超 3000 个泛化案例,训练集与评测集完全隔离,且对每个任务做了充分的泛化配置,有效杜绝了轨迹回放类方案的作弊可能。
痛点三:单点能力强不代表真实场景好用。传统评测往往聚焦单一原子能力,但真实场景任务复杂,需同时具备指令理解、空间判断及抗干扰能力。RoboColiseum 围绕指令(基础)、空间(认知)、扰动(鲁棒)、操作(落地)四个维度构建完整考察链条,从语义到物理,从感知到执行,全面评估模型综合能力。

02


四榜同时第一:全能型底座的硬核实力

原力灵机 DM0.5 在指令跟随(0.8444)、空间理解(0.6146)、扰动适应(0.7344)、通用操作(0.6370)四项子榜中全部排名第一。这四个维度考核不同层次能力,互不加持,任何短板都会直接暴露。DM0.5 能在多维度维持领先,得益于其架构与数据源的坚实支撑。
指令跟随:DM0.5 在预训练阶段引入具身思维链。动作生成前,模型先完成内部推理流程(目标定位、步骤规划、后果预判等),覆盖 11 项推理任务。这种机制迫使模型理解“指令×本体×环境”关系,而非死记硬背,从而展现出 Zero-shot 级别的泛化能力。
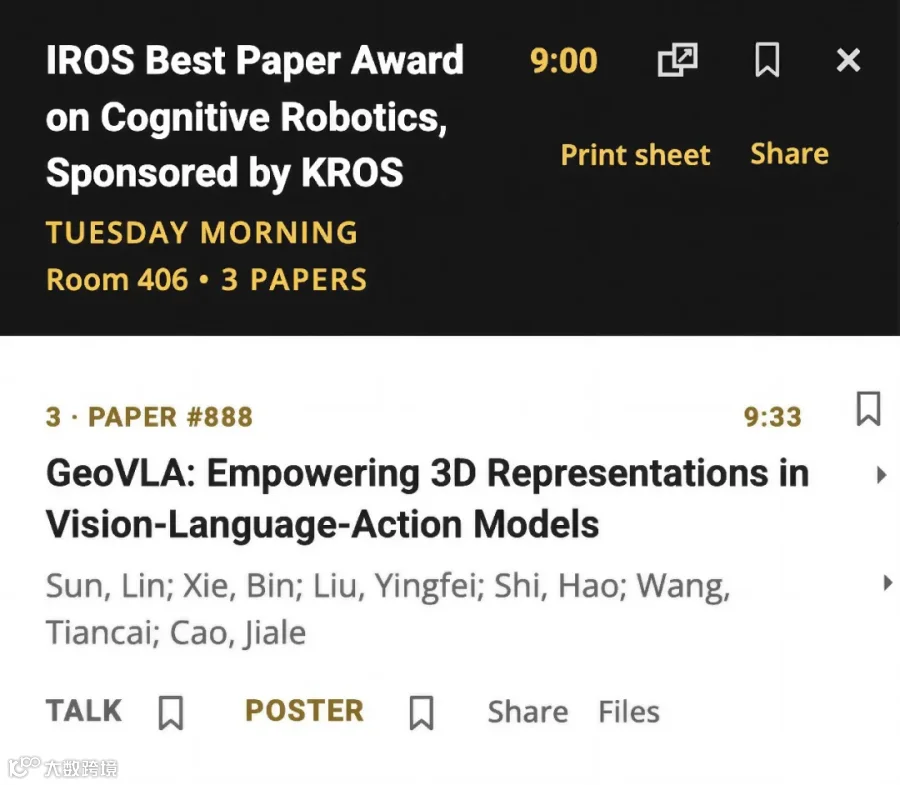
空间理解:DM0.5 预训练数据包含10 万小时第一视角(Egocentric)视频,支持毫米级精度的 3D 空间标注生成。此外,其与天津大学、清华大学合作的论文《GeoVLA》入选 IROS 2026 最佳论文提名,核心成果是将三维几何表征显式引入 VLA 模型决策过程,使模型能在具有深度和几何关系的三维世界中理解场景。
扰动适应:该能力直接关乎工业落地。DM0.5 通过工程优化将核心延迟从 534 毫秒压至 57.49 毫秒,加速 9.29 倍,且在 LIBERO 测试中成功率几乎无损。其“感知 - 思考 - 出手”全流程快于人眼眨眼速度,能在干扰发生瞬间完成重决策。此外,模型具备原生 60 秒记忆,任务中断后可续接而非重置。
通用操作:考验原子技能组合能力。在物流分拣场景中,DM0.5 纯靠实时视觉决策,平均 3 秒一件,准确率超 99%;在亚毫米积木拼装中,能自主感知失败并半秒内纠错;在灵巧手场景下,配合后训练控制 58 自由度灵巧手完成切黄瓜等柔性物体操作,突破了传统预设轨迹的限制。

03


非针对性优化:底座能力的真实检验

DM0.5 在 RoboColiseum 上的优异表现,并非针对评测任务进行专项优化的结果,而是通过常规监督微调(SFT)将强大的预训练底座能力迁移至特定构型和任务上。这意味着该成绩更接近对底座模型真实通用能力的测量。
定向优化虽在特定场景有效,但易导致泛化能力下降。DM0.5 仅靠 SFT 即可登顶,证明其在指令理解、空间感知、历史记忆和动作生成上已形成坚实的通用基础,这是其跨评测框架保持领先的根本原因。

04


多维佐证:从学术认可到全球基准验证

DM0.5 的实力在其他权威评测中也得到反复验证。上月,其在由港大、UC 伯克利等机构发起的 RoboDojo 评测中,记忆维度得分及成功率均超出第二名近 4 倍。
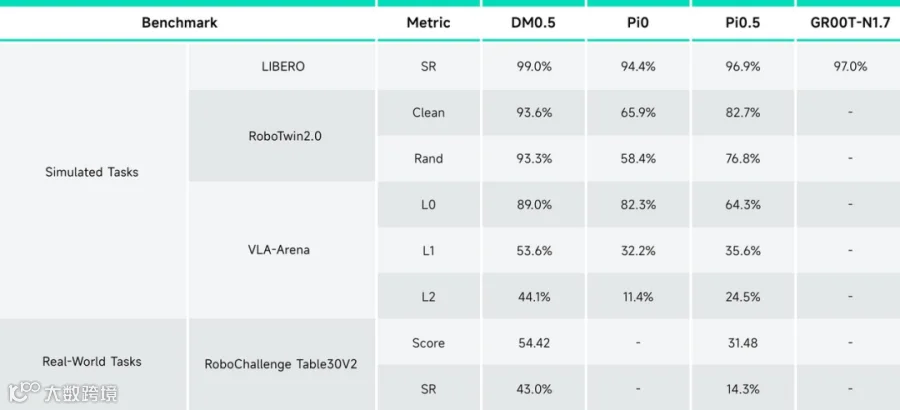
纵向对比显示,DM0.5 在 LIBERO、RoboTwin 2.0、VLA-Arena 等多个基准中均取得显著优势。在真机评测 RoboChallenge Table30 V2 中,面对四种异构机型和 30 个复杂任务,DM0.5 以 43.0% 的整体成功率位列第一。
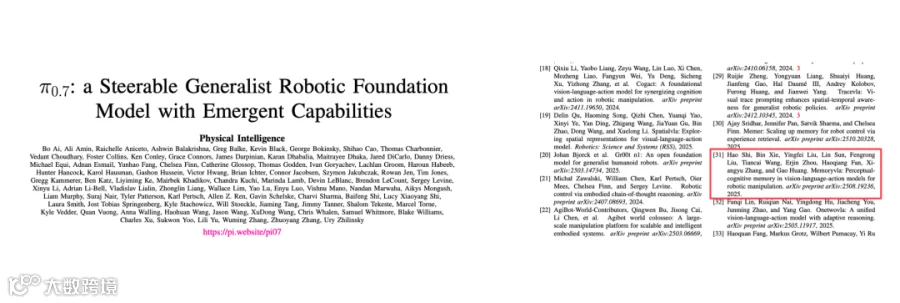
国际同行 Physical Intelligence(π)也在其关键论文及产品π0.7 中,两次引用原力灵机的 MemoryVLA 架构作为学术参照,肯定了其在具身记忆机制上的探索价值。

05


进阶状态:实时推理、全面开源与真机落地

推理提速:通过 Vision TensorRT、FP8 等多项联合优化,DM0.5 核心延迟降至 57.49 毫秒,API 响应控制在 70 毫秒内,累计加速 9.29 倍。大模型的智力首次跑进实时控制的时间窗口。
全面开源:DM0.5 模型权重、训练框架及多个下游任务工作流已在 GitHub 和 Hugging Face 开放,核心代码提交至 LeRobot 社区。原力灵机亦当选国际电信联盟(ITU)具身智能焦点组“开源生态”工作组组长单位,旨在推动行业公共底座建设。
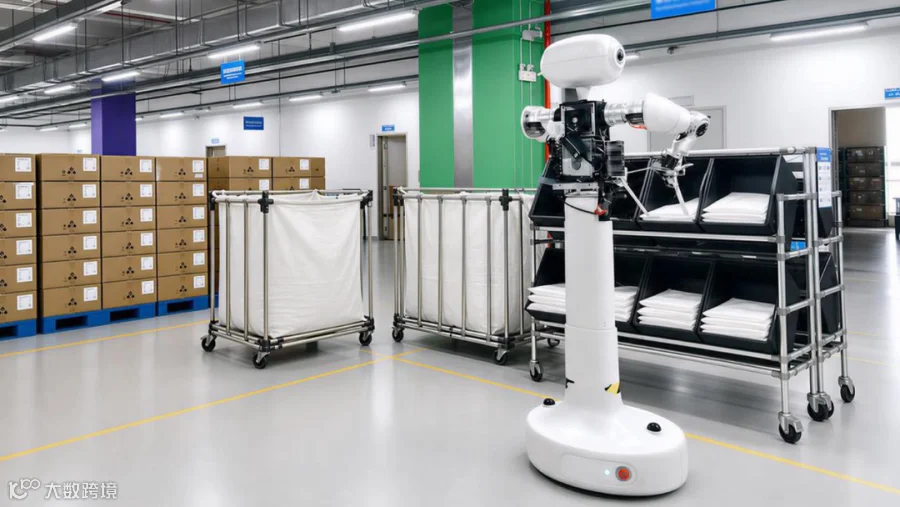
真机落地:原力灵机已在多个真实场景部署测试:包括大型国际零售商仓储的商品搬运分拣,以及 3C 制造工厂的包装与废料回收。从榜单到工厂,评测成绩正逐步转化为实际生产力。

06


结语:全科优秀才是落地的通行证

RoboDojo 侧重记忆与长程执行,RoboColiseum 侧重指令、空间与鲁棒性。DM0.5 在两套逻辑迥异的评测体系中均稳居榜首,证明了其能力的均衡性与普适性。
在具身智能评测标准尚未收敛的当下,能在多个严格评测中保持领先,含金量远超“刷穿”单一榜单。真实场景——无论是工厂的鲁棒性要求,还是家庭的语义理解需求——都不会迁就模型的短板。
物理世界的智能,单科状元不足以应对。行业最终需要的,是经得起不同考场、不同考题检验的长期答题者。只有能力谱系足够宽且均衡,才能承接真实世界多样的任务要求。
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8954
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读244.9k
粉丝0
内容9.0k