


编辑丨岑峰
在 3D 视觉与场景生成领域,核心难题在于如何将局部生成结果组织成全局一致的 3D 世界。现有大模型常出现跨视角结构不一致、物体布局不合理等现象。例如,提示词为“卧室”时可能生成多张床,或虚拟相机长距离漫游时建筑结构扭曲。这表明模型虽具备强局部先验,但缺乏全局 3D 结构约束。
引入显式 3D 几何可为局部预测提供跨视角结构约束,构建更一致的全局结果。在今年的欧洲计算机视觉国际会议(ECCV)上,香港科技大学谭平教授分享了团队在 3D 重建与场景生成方面的最新成果:利用学习方法提供强大局部先验,结合 3D 几何进行组织与约束,从而提升大规模场景的全局一致性与可扩展性。
谭平教授师从 3D 视觉权威权龙教授,长期深耕该领域。本次演讲重点探讨如何将学习方法的表达能力与多视图几何、全局优化等经典方法相结合。无论是从图像重建 3D 世界,还是生成可漫游的 3D 场景,学习模型提供局部先验,而几何结构与全局优化则负责将其组织成全局一致的 3D 表示。
在重建任务中,团队借鉴视觉 SLAM/SfM 的关键帧思想,结合集束调整(Bundle Adjustment)进行全局优化,解决前馈网络在大规模输入下的计算与一致性问题;在生成任务中,通过显式 3D 布局或代理提供结构约束,再利用生成模型补充外观细节,改善大场景漫游的空间一致性。
演讲核心观点并非在学习方法与几何方法间二选一,而是强调二者的互补性:学习模型擅长从大数据获取局部先验,3D 几何则为跨视角、长距离场景提供全局结构约束。这种“学习先验 + 几何约束”的模式对于空间计算、世界模型和具身智能具有重要探索价值。

▎演讲标题:《几何的反攻:规模化 3D 重建与结构化 3D 场景生成》
近年来,以 VGGSfM 或 DUSt3R 类前馈网络为代表的基于大型 Transformer 的方法在 3D 视觉领域取得显著进展。其基本思路直观:接收一组输入图像,提取特征后通过大型 Transformer 直接估计相机位姿、深度图和点云,实现高效的局部 3D 重建。

01
大规模 SfM 方法:用“神经场景表示”缓解 Transformer 显存瓶颈
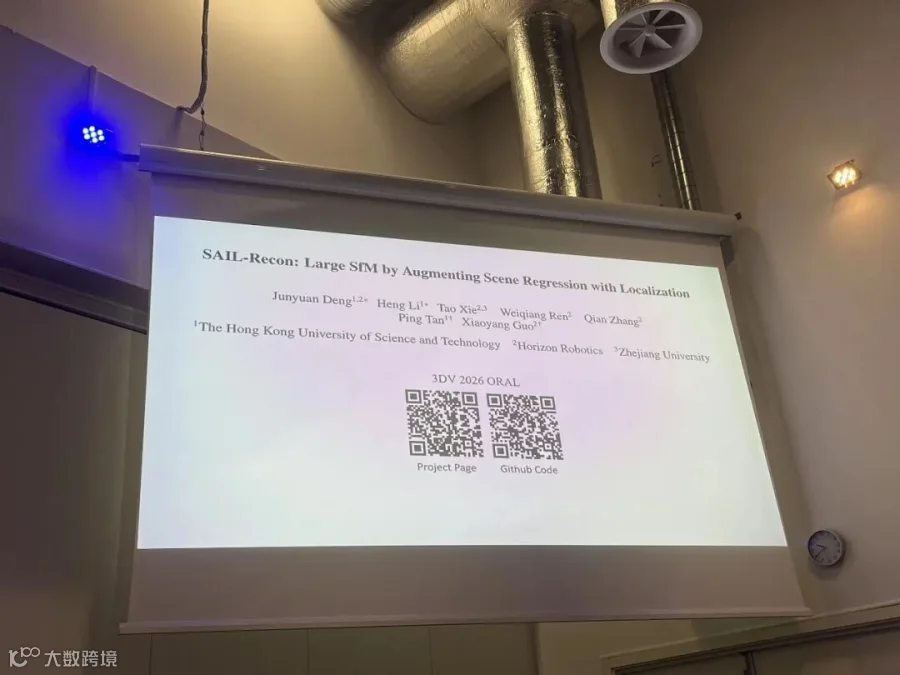

这一轻量化设计显著降低了全局建模的显存开销,使方法能够扩展至更大规模的输入图像。
该方法能处理更大规模图像,生成稠密合理的 3D 点云与相机轨迹,显著减少因位姿不准导致的“重影”伪影。在 Tanks and Temples 等复杂数据集测试中,约 70% 的情况下,相对旋转和平移误差控制在 5 度以内。
此外,研究还发现传统标杆算法 COLMAP 算出的相机位姿存在估计误差,不宜直接视为绝对真值。为此,团队提取 90% 输入图像估计位姿并训练 NeRF 模型,在预留的 10% 未见视角上计算 PSNR。结果显示,该方法在渲染质量和 PSNR 指标上优于基于 COLMAP 位姿训练的结果。
02
Global 3R:前馈网络与全局 SfM 的融合
虽然实现了前馈 3D 重建的规模化扩展,但在更大场景中,单纯依靠前馈预测仍可能出现误差累积和尺度不一致问题。因此,团队提出能否将神经网络前馈方法的鲁棒效率与传统全局 SfM 优化的几何精度结合,兼顾可扩展性与全局一致性。
由此诞生了 Global 3R 工作。

-
给定输入图像,提取滑动窗口。在窗口内应用前馈神经网络(如 CroCo/RoMa 匹配网络)计算图像对间的相对运动和点云等信息; -
采用新方法在窗口内选择关键帧,计算关键帧与窗口内其他帧的匹配与对齐,获取一致的特征轨迹; -
构建位姿图,依次进行旋转平均和平移平均,最后执行集束调整,生成最终 3D 结果。

在相机位姿精度方面,ETH3D 数据集上 1 度阈值下的结果表明,本方法取得了极高的旋转精度,多个场景测试中该指标可达 100%。
03
3D 场景生成:用“显式布局”增强全局空间一致性
首先是受 Text2Room 启发的研究。Text2Room 利用图像扩散模型逐步生成不同视角并拼接成全景图,但因缺少显式全局 3D 场景布局约束,常出现家具数量或空间布局不合理的问题。

在布局生成环节,模型使用向量编码物体坐标、尺寸和方向,拼接为统一代码序列。基于该代码空间和真实结构化数据训练扩散模型,同时引入视觉先验学习房间陈设规律。此外,为改善全景图左右边界衔接,扩散过程中引入随机循环平移以增强循环一致性。对比测试表明,布局引导有效避免了如“一间卧室生成多张床”等不合理结果。
04
SpatialCraft:单图推断 3D 代理,解锁大场景自由漫游
第三项工作 SpatialCraft 面向上述局限,采用两阶段策略。

第一阶段从单图生成 3D 代理。通过在大量 3D 场景上训练的扩散模型,从单图推断出粗略的 3D 空间基底,设置相机轨迹并渲染基础 3D 漫游视频。第二阶段引入视频扩散模型,对基础视频进行优化,提升纹理细节和视觉质量。
第一阶段核心技术是保持“像素对齐”以保留原始输入图像特征。具体做法是将输入图像提升为深度图并转换为 3D 体素,利用网络补全场景不可见区域,确保生成过程在可见区域与输入图像对齐,并为后续视角生成提供稳定 3D 结构,最终处理为场景的 3D 高斯表示。
第二阶段侧重“视频优化”。3D 代理提供的基础场景结构对跨视角空间关系形成约束,视频扩散模型在此基础上重点优化画面纹理细节和视觉质量。
实验结果表明,该方法适用于室内及室外自然场景。即使相机大范围移动,生成的漫游视频仍能较好保持空间一致性;在长视频生成测试中,相比现有基线,远离初始视角后仍能保持更稳定的场景结构。
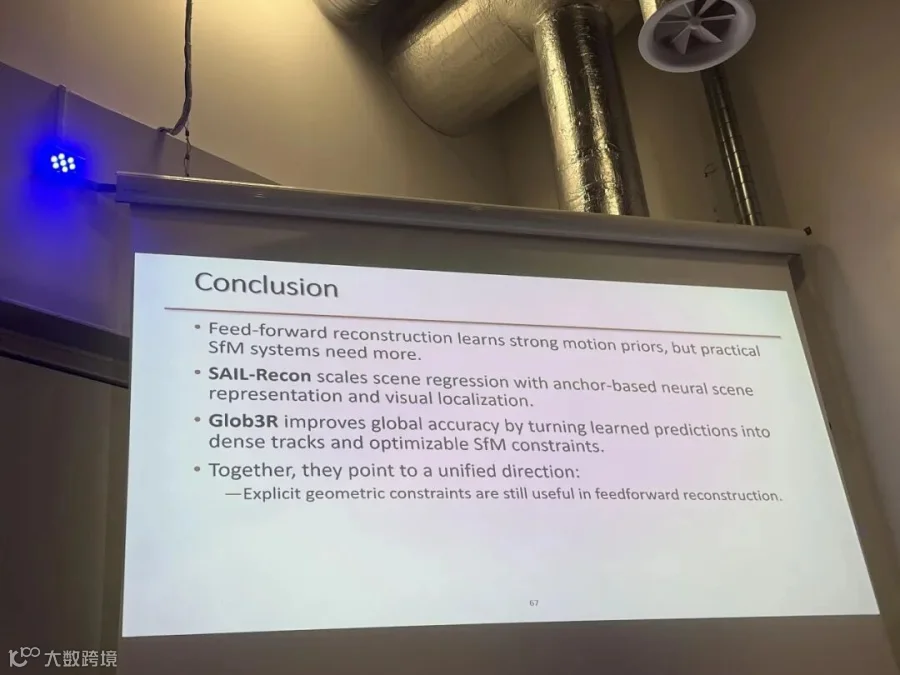
总结而言,本次分享聚焦 3D 重建与 3D 场景生成两大方向。在 3D 重建中,深度学习前馈方法提供强大的运动和结构先验,多视图几何优化(如集束调整)进一步提升全局精度与一致性。在 3D 场景生成中,现有大模型具备强局部生成能力,显式 3D 几何约束有助于减少不合理结果,支持更稳定的多视角与长距离生成。
3D 几何是连接“重建”与“生成”的脚手架:基于学习的大模型提供强大局部先验,经典几何帮助将这些局部信息组织成全局一致的 3D 结构。