搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
英伟达开源 IMO 金牌配方:不仅是「人海战术」,1.5TB 显存做实 AI「 推恩令」?
>
英伟达开源 IMO 金牌配方:不仅是「人海战术」,1.5TB 显存做实 AI「 推恩令」?
AI科技评论
2026-09-15
12
导读:用三套 checkpoint 完成多轮证明搜索,用过程透明平息学术怒火,用 1.5TB 显存门槛锁定算力霸权。名为代码平权,实则算力集权。
以三套 Checkpoint 完成多轮证明搜索,用过程透明化解学术质疑,以 1.5TB 显存门槛确立算力霸权。名为代码平权,实则算力集权。
作者丨
郑佳美
编辑丨岑 峰
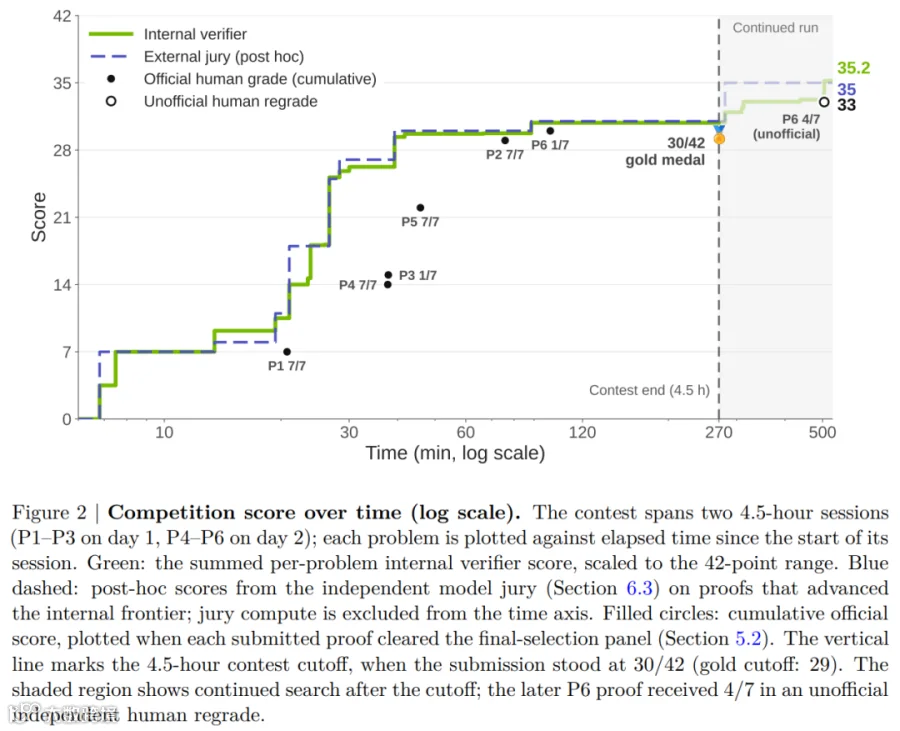
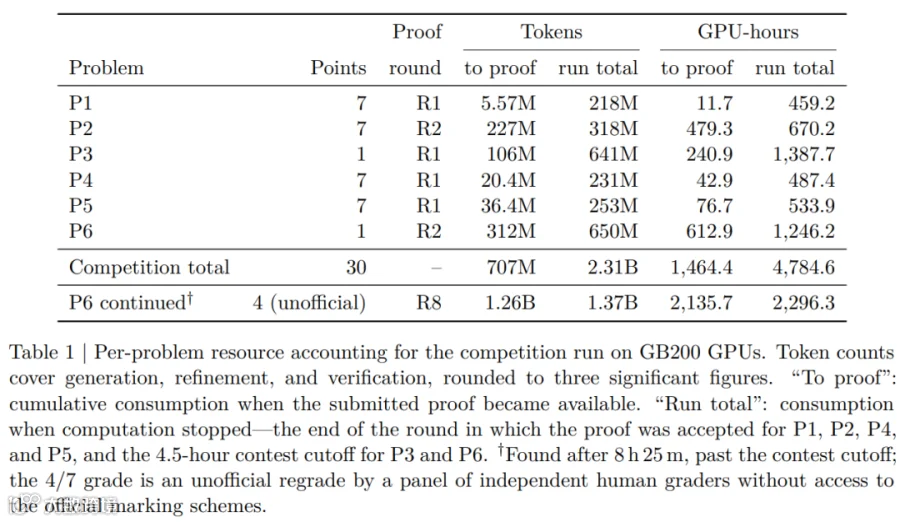
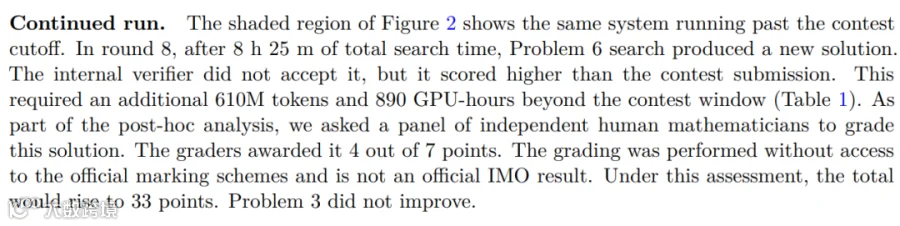
9 月 9 日,NVIDIA 公布了 Nemotron 3 Ultra 在 2026 年国际数学奥林匹克(IMO)中使用的整套数学推理系统。该系统最终获得 30/42 分,超越当届 29 分的金牌线。全程仅使用自然语言撰写证明,未调用 Lean 等形式化证明器,亦无外部
工具
或联网检索辅助。
此次发布的核心价值不仅在于成绩,更在于完整性。NVIDIA 开源了支撑该分数的两个数学专家 Checkpoint、SFT 与 RL 训练数据、推理代码、训练配方、比赛提交证明以及 200 道新的 Nemotron-IMO-Bench 测试题。
这意味着公开的是一套从训练到推理的完整系统链路,而非单一的更强模型。Nemotron 3 Ultra 作为基座,结合两个专家模型、大规模证明搜索、模型验证及多轮改写机制,共同构成了冲击 IMO 金牌线的技术闭环。
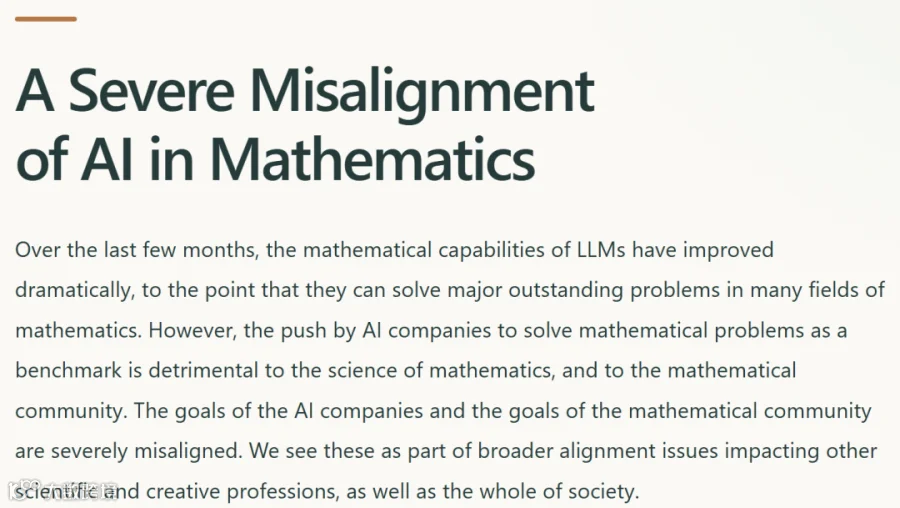
在此背景下,陶哲轩、Peter Scholze 等 25 位菲尔兹奖得主曾联合发声,批评 AI 数学成果发布过快而缺乏充分的复现与验证
时间
。NVIDIA 此次罕见地将 IMO 金牌级结果背后的模型、数据、流程及计算成本全部公开,为学术界提供了宝贵的透明度。
该系统的技术起点并非对单一模型反复采样,而是率先训练了两个行为差异显著的数学专家模型。
双专家 Checkpoint:差异化策略提升搜索效率
Nemotron 的核心设计在于让后训练直接
服务
于搜索过程。SFT 数据中不仅包含完整证明,还引入了大量证明修改、验证及再验证的轨迹。这使得模型不仅能生成证明,更能识别半成品或含错证明中的问题,并沿原有路径进行修复。
在搜索系统中,这种能力显著优化了计算资源利用。高难数学题往往存在大量“中间状态”候选,其主体结构可用,仅在局部引理或推导闭环上存在瑕疵。具备修改能力的模型可将已有证明作为中间状态继续推进,保留前序计算的有效结构,避免无效重启。
RL 专家则专注于调整证明路线的生成概率。IMO 级题目的正确解法在证明空间中极为稀疏。强化学习通过奖励成功闭合的证明思路、压低导致死胡同的选择,重新分配模型已有能力的出现频率,从而在有限算力下覆盖更多有效路径。
通用版、SFT 和 RL 三份 Checkpoint 形成了三种不同的解题偏好。这种差异性对于搜索至关重要:若同一模型连续生成数百份高度相关的证明,新增算力的信息增益将迅速递减。引入不同后训练的 Checkpoint,相当于主动改变采样分布,引导计算资源探索新的证明空间。
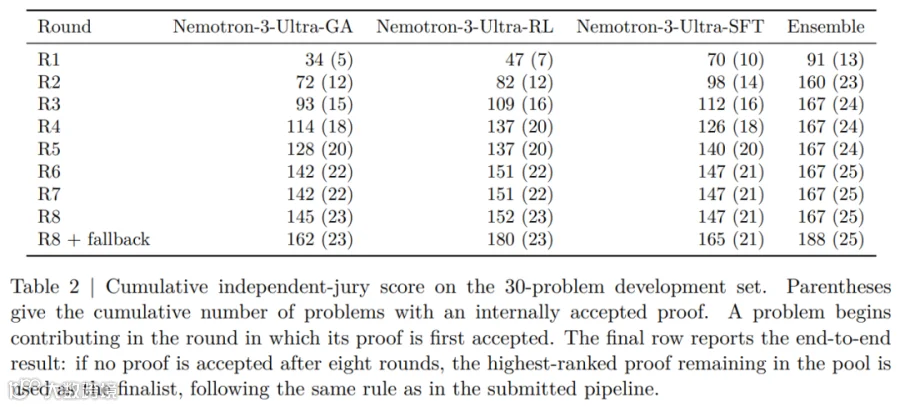
实验数据显示,单纯增加同一 RL 模型的采样收益放缓明显,而加入 SFT 专家后,即便生成预算相近,覆盖的问题数量也显著增加。因此,后训练不仅是提升单模型能力,更是通过 SFT 支持修改、RL 调整分布、多 Checkpoint 降低相关性,解决有限算力下的路径覆盖问题。
动态搜索池:384 次生成后的深度迭代
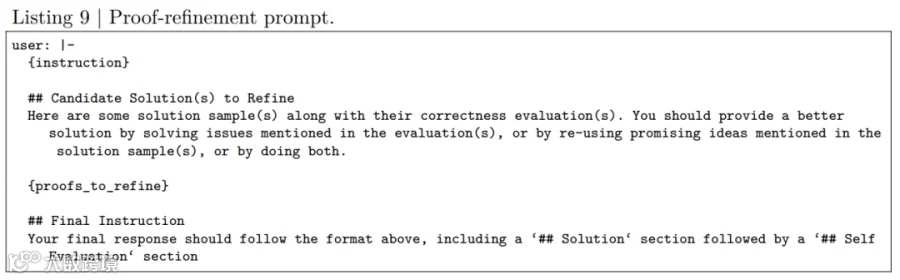
Nemotron 首轮为每道题生成 384 份证明,但这并非终点。系统将首批证明纳入持续更新的搜索池,经验证后分为三类:直接通过、需修补但方向可用、价值较低。系统保留高分证明,并将验证器指出的问题反馈给模型进行针对性修改。
这一机制改变了推理性质:传统多次采样是彼此独立的“从头再来”,而 Nemotron 的 Proof Pool 保留了历史计算记忆。验证器的批改意见充当了方向信号,指导模型在局部区域继续寻找优化方案,无需重新探索整个证明空间。
多轮改写并非简单润色,而是每轮产生新候选并进入全局竞争。高评价路线获得更多计算资源投入,无法解决关键漏洞的路线则逐渐被淘汰。这种机制兼顾了搜索宽度(首轮铺开)与深度(后续精修),实现了动态资源分配。
与自然语言证明缺乏明确规则不同,围棋等游戏有确定的输赢判定。在 Nemotron 中,Verifier 不仅打分,更直接决定计算资源的流向。其判断误差会直接影响搜索路径,搜索规模越大,Verifier 的影响力越显著。
验证瓶颈:共享错误与一致性挑战
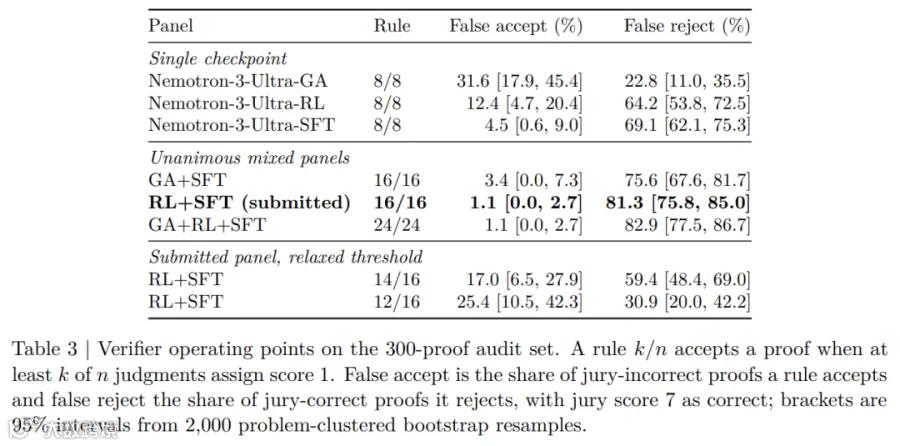
为降低错误证明被放行的概率,NVIDIA 设定了极高门槛:需两个专家反复检查且全票通过方可接受。这一设计旨在以较高的误拒率换取极低的错误接受率,避免搜索停在错误答案上。
然而,实验显示提高门槛虽减少了错误通过,却也阻挡了大量正确证明。更深层的问题在于验证判断的非独立性:SFT、RL 和通用版共享同一基座模型,拥有相似的知识结构与推理习惯。当错误源于随机疏忽时,多次检查有效;但当错误源于共同的理解盲区时,增加检查次数效果甚微。
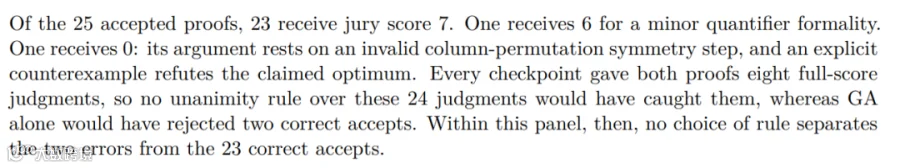
论文中关于置换对称性的错误证明即为典型案例:三个 Checkpoint 均未识别出关键漏洞。这表明模型间错误高度相关,内部共识的稳定并不等同于数学可信度的提升。
此外,部分有价值证明因门槛过于保守而被压下。未来的技术路线需致力于让不同验证组件拥有差异化的错误来源,例如引入基础模型交叉检查、反例生成器、符号系统及形式化证明器等,以降低多点同时失效的概率。
开源背后的“推恩令”:算力主权的垄断
NVIDIA 开源了全套系统变量,外部团队可调整 Checkpoint 组合、采样预算等参数复现实验。然而,550B 级模型、TB 级显存及数千 GPU 小时的硬件门槛,使得完整重跑 30 分的成绩对全球 99% 的高校实验室而言仍是一道硬墙。
这种“代码平权、算力集权”的现状,预演了未来 AI for Science 的竞争格局:巨头通过烧掉数百万美元电费,铲平了枯燥重复的逻辑可能性,而数学家角色正从“寻找证据者”转变为“审判逻辑者”。
NVIDIA 向学术界传递的信号清晰:算力可承担繁重的体力活,但关于真理的最终裁决仍需人类直觉。这份
报告
既是对基础研究的尊重,也是一种高明的战略——通过开源共享红利,让全球实验室无形中进入由英伟达硬件定义的搜索推理范式。
正如“推恩令”以利益共享消解对抗意志,当你手持图纸试图复现成功时,会发现唯一的路径便是购买更多的英伟达显卡。
参考链接:
https://arxiv.org/pdf/2609.10712
https://mathandai.org/
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容
8954
粉丝
0
关注
在线咨询
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
总阅读
244.9k
粉丝
0
内容
9.0k







 AI科技评论