

本文作者|章锦阳
本文编辑|蒲诗瑶
ICML 2026 Spotlight
论文题目:The Tell-Tale Norm: ℓ₂ Magnitude as a Signal for Reasoning Dynamics in Large Language Models
作者:Jinyang Zhang、Hongxin Ding、Yue Fang、Weibin Liao、Muyang Ye、Junfeng Zhao、Yasha Wang
机构:北京大学(森智实验室)· 浙江大学
论文链接:
https://arxiv.org/abs/2606.06188
代码链接:
https://github.com/zjy1298/The-Tell-Tale-Norm
让大模型“多想一会儿”,是否必须生成更长的思维链?随着研究者探索隐藏空间中的潜在思考(latent thought),推理增强有了新的维度:模型可在内部表示上继续计算,无需将每一步展开为文字。然而,如何感知这些不可见的推理活动,并判断在哪些层、何时增加计算或施加干预?这需要一个简单、可在线读取的层粒度信号。
入选 ICML 2026 Spotlight 的论文《The Tell-Tale Norm》正是从这一缺口出发。研究发现,隐藏状态的 ℓ₂ 范数(即向量长度)能够追踪模型各层推理活动的强弱。基于这一内生信号,作者提出三种无需额外训练和数据的推理增强方法。实验显示,这些方法在测试基准上的性能平均相对提升 4.51%,在 AIME 等高难推理任务上相对提升达 9.13%。
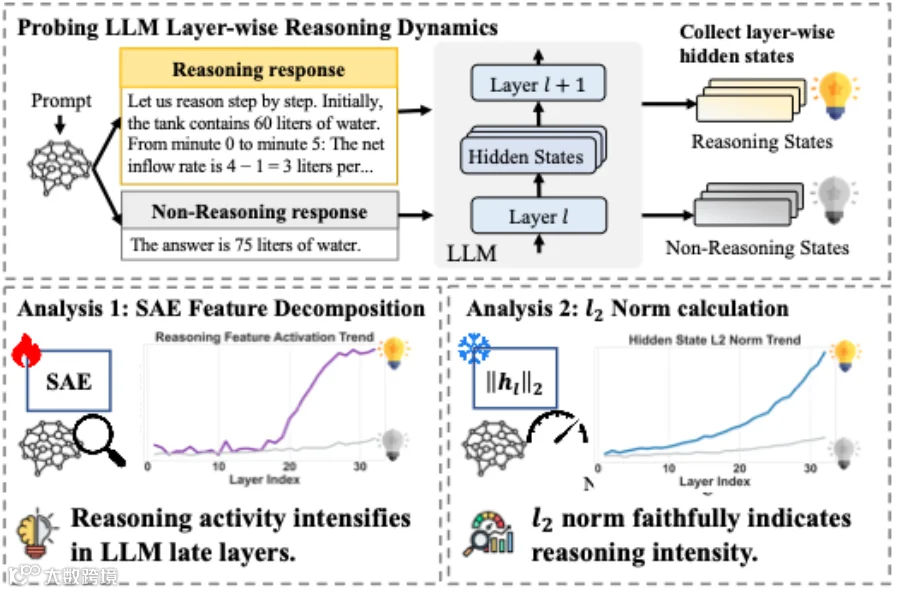
图 1|研究总览:从 SAE 揭示的层间推理动态出发,寻找简单的内生指标,为隐藏空间中的推理控制提供依据。
潜在思考需要一个层粒度的控制信号
显式思维链通过生成更多中间步骤扩展推理计算,但也增加了输出 token 与解码开销。潜在思考则将探索延伸至连续隐藏表示中:能否让模型在内部多做计算再输出答案?隐藏空间中的推理与层递归等研究,使“把额外计算放在哪里”成为具体问题。除沿生成序列延长思考外,模型深度方向上的计算分配同样值得关注。
要实现按需控制,首先需感知内部状态。输出熵、推理关键词等信号虽有助于分析已生成文本,却难以直接刻画一次前向传播中各层的推理强弱。稀疏自编码器(SAE)能从隐藏状态分解出推理特征,但通常需针对模型和层训练探针。若希望在推理时直接使用,一个更简单、无需额外训练的层粒度指标尤为重要。
该论文提出两个核心问题:推理活动在模型各层间如何变化?能否直接从隐藏状态读取这种变化并指导计算与干预?作者先用 SAE 识别推理特征,再考察 ℓ₂ 范数能否追踪相同的层间动态,从而将对内部推理的观察与实际干预联系起来。
推理特征在后层增强而向量长度同步上升
作者在 MMLU-Pro 上收集模型各层隐藏状态,为每层训练独立 SAE。随后,对同一问题分别生成含显式思维链的回答与直接作答的回答,比较各类特征的平均激活差异。差异最大的特征被选作推理相关特征,并通过高激活 token 内容进行定性检查。
研究发现一个显著规律:在分析的模型中,推理特征的激活并非均匀分布,而是在后层显著增强。Qwen3 系列可视化显示,这种上升主要集中在最后约四分之一的层,对应的高激活 token 常涉及逻辑连接、条件判断和中间结论。
更有意义的是,直接计算隐藏状态的 ℓ₂ 范数也能观察到相似趋势。该计算仅需将向量各分量平方求和后开方,无需 SAE 或额外模型判断。在 Qwen3-4B、8B 和 32B 上,范数与 SAE 推理特征激活均在后层明显抬升;对比显示,显式推理状态通常具有更大的范数。

图 2|同一现象的两种观测:上排是 SAE 推理特征激活,下排是隐藏状态 ℓ₂ 范数,两者在模型后层呈现相近的上升趋势。
定量数据进一步支持了这一对应关系。论文 Table 1 显示,ℓ₂ 范数与 SAE 推理特征激活的层间 Spearman 相关系数约为 0.84—0.88,与最终输出熵的相关系数约为 0.52—0.67。相比之下,隐藏状态熵、层输出熵与注意力熵未表现出同样稳定的正向对应关系。
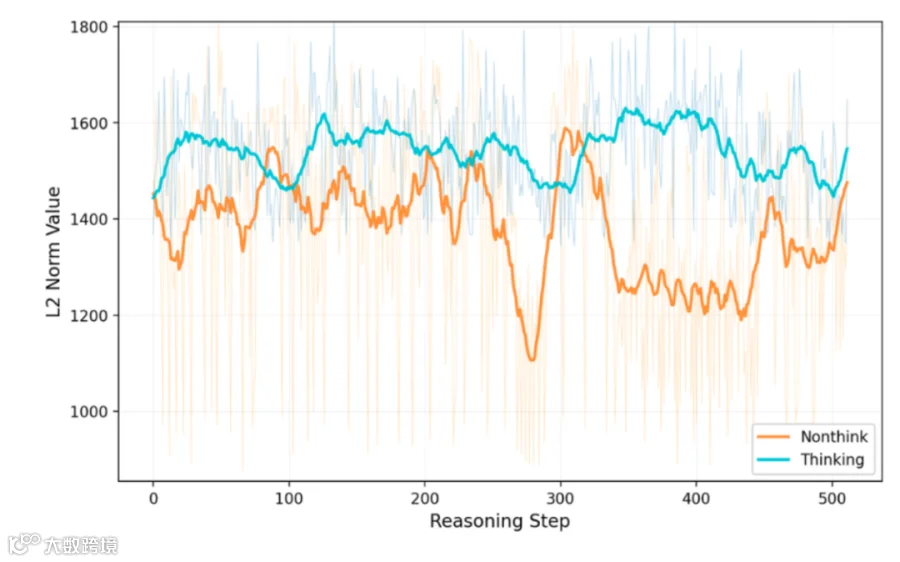
图 3|thinking 与 non-thinking 对照:从 token-wise 角度观察,显式推理状态通常伴随更高的隐藏状态范数。
向量长度为什么能反映推理强度
论文给出的几何直觉是:推理会激活额外的内部特征。若这些特征与已有语义表示近似正交,其贡献将体现在向量总“能量”(即范数平方)的增加上。
作者证明,在 SAE 重建足够准确、相关解码基近似正交的条件下,隐藏状态范数的平方可近似聚合潜在特征的激活能量。主定理用 thinking 与 non-thinking 平均隐藏状态的平方范数差,为推理特征的差分激活总量建立上下界。
这解释了为何“更多推理特征被激活”可能伴随“向量长度增加”,同时也明确了结论的适用条件。它并不意味着任意模型、任意层的大范数都只由推理产生,也不代表直接放大向量就能保证答对。
作者进一步进行了直接干预实验:在最后四分之一的层中,将高范数位置的隐藏状态缩小至原来的 0.1 倍,并与随机抑制对比。结果显示,定向削弱高范数状态造成的性能损失远大于随机抑制。以 Qwen3-14B 的 GPQA-main 为例,基线准确率为 58.79%;抑制比例为 0.5% 时,随机抑制后准确率为 53.30%,而针对高范数状态的抑制将其降至 28.79%。这说明被范数识别出的状态具有显著的功能重要性。
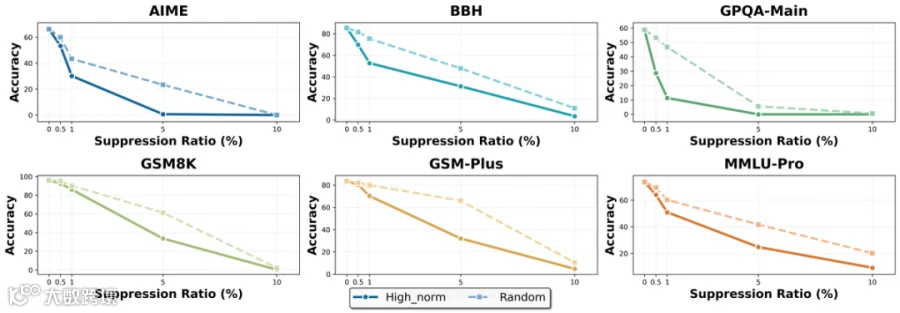
图 4|高范数抑制与随机抑制对比:同样的干预比例下,定向削弱高范数状态通常造成更严重的性能下降。
从层粒度感知到推理时控制
层粒度信号的价值在于让干预有据可依:在哪一层重复计算,何时调整隐藏状态,均可参考模型当前的内部活动。针对不同任务范数尺度不同的问题,论文采用基于当前生成历史的在线分位数统计,以第三四分位数加上若干倍四分位距构造自适应阈值,识别相对当前上下文异常升高的范数,无需预先用额外数据校准阈值。

图 5|三种应用:在关键层重复计算、利用历史高范数状态进行引导,以及依据内部范数信号选择候选回答。
把额外计算分配给关键层
自适应层间推理递归(ALRR)在检测到范数峰值时,让当前隐藏状态再次经过同一 Transformer 层。它利用已有层的参数进行局部重复计算,为推理活跃的位置增加处理机会。递归会增加前向计算,因此论文通过最大迭代次数、状态变化等停止条件约束重复过程。
从当前轨迹中借用已有的推理状态
内生推理状态引导(ERSS)维护当前生成过程中出现过的高范数隐藏状态。在需要干预时,从历史缓存中选取与当前状态余弦相似度最高的向量,再按一定权重加到当前状态上。引导向量来自同一次生成且经语义筛选,具有明确的上下文来源,相比依赖外部样本的方法更具自给自足性。
让内部信号参与候选答案选择
ℓ₂ 引导的回答选择(LRS)面向同一问题的多个候选回答,聚合中后层的范数信息构造推理分数,再选出分数最高的候选。它让模型生成时产生的内部状态参与评估,不需要额外训练奖励模型或使用答案标签。需注意,序列范数的累计值可能受回答长度影响,该方法更适合作为一种有实验证据的选择信号。
数学与通用推理实验中的收益
主实验覆盖 Qwen3 系列及 DeepSeek-R1-Distill-Llama 系列,模型规模从 1.7B 到 70B;测试任务包括 AIME24、AIME25、GSM8K、GSM-Plus、BBH、GPQA-main 和 MMLU-Pro。
整体来看,三类方法在所测基准上的平均相对提升为 4.51%,在 AIME 等高难推理任务上的相对提升为 9.13%。具体而言,ALRR 将 Qwen3-1.7B 在 AIME25 上的准确率从 30.83% 提升至 40.00%,相对提升约 29.7%;在 Qwen3-4B 的 AIME24 上,从 60.00% 提升至 70.00%。这表明当模型在困难任务上仍有提升空间时,局部增加隐藏层计算可带来明显收益。
另两种方法也表现积极。ERSS 将 Qwen3-4B 的 MMLU-Pro 准确率从 67.92% 提升至 71.15%;LRS 则将 Qwen3-32B 的 MMLU-Pro 从 Mean@8 的 77.83% 提升至 82.54%,在 GPQA-main 上从 64.40% 提升至 68.64%。附录还扩展到 Phi-4 与 Gemma3,并对层选择、方法组合及超参数进行了分析。
更强的推理活动也可能带来过度思考
本研究的重要边界在于:范数反映推理活动和计算强度,并不直接等于事实正确性。模型可能非常认真地走向错误结论,或在只需直接提取知识的问题上进行不必要的推演。
附录中的非推理中心任务清楚地展示了这种差异。Qwen3-4B 在 NQ-Open 上的基线为 28.80%,使用 ALRR、ERSS、LRS 后分别为 25.18%、25.24%、26.78%;PubMedQA 上也出现下降。作者将过度分析列为可能解释。相比之下,部分指令遵循任务有所受益,因为跟踪和检查约束本身需要额外处理。
干预幅度也有边界。诊断发现,随着递归次数增加,范数快速增长,过多循环可能带来不稳定。实践中仍需限制递归与注入强度,并结合任务表现判断是否值得增加计算。

图 6|适用边界:在 NQ-Open 和 PubMedQA 上,增强推理活动未必改善结果;应同时观察任务收益与负向变化。
“无需训练”也有明确范围:识别并使用范数不需要额外训练探针,但这三种应用仍会引入重复计算、历史缓存或多候选生成等成本。由于需要访问甚至修改中间隐藏状态,这类方法更适合可控制推理实现的模型环境,而非只能获取最终文本的封闭接口。
为潜在思考提供简单的感知与控制依据
潜在思考为推理增强提供了更多操作空间,也让内部计算的感知变得更加重要。The Tell-Tale Norm 用 SAE 分析、理论联系和干预实验表明,隐藏状态的 ℓ₂ 范数可提供有意义的层粒度信息。进一步的层递归与状态引导实验说明,这一信号能够参与推理过程的控制;候选选择则展示了其用于结果评估的潜力。
这项工作的启发是,在探索更复杂的潜在推理机制之前,模型已有的隐藏状态中就可能存在可直接利用的控制信号。ℓ₂ 范数提供了一个无需另训探针、可以逐层逐 token 读取的起点。如何结合任务需求与计算预算,判断哪些内部活动值得继续增强,并让这种控制适配更多潜在推理架构,是接下来值得探索的方向。

森智实验室
森智实验室(英文:CENTRAi Lab)是北京大学软件工程研究中心王亚沙教授领导的科研团队。团队成员来自软件工程国家工程研究中心、计算机学院、软件与微电子学院,长期致力于人工智能理论、技术及其与医学的交叉研究。