


需求预测是供应链管理的起点,却常因“拍脑袋”决策导致库存积压与缺货并存。本文系统解析需求预测的四种常用方法、五步标准流程及准确率提升要点,助企业将预测从经验主义转向科学管理。
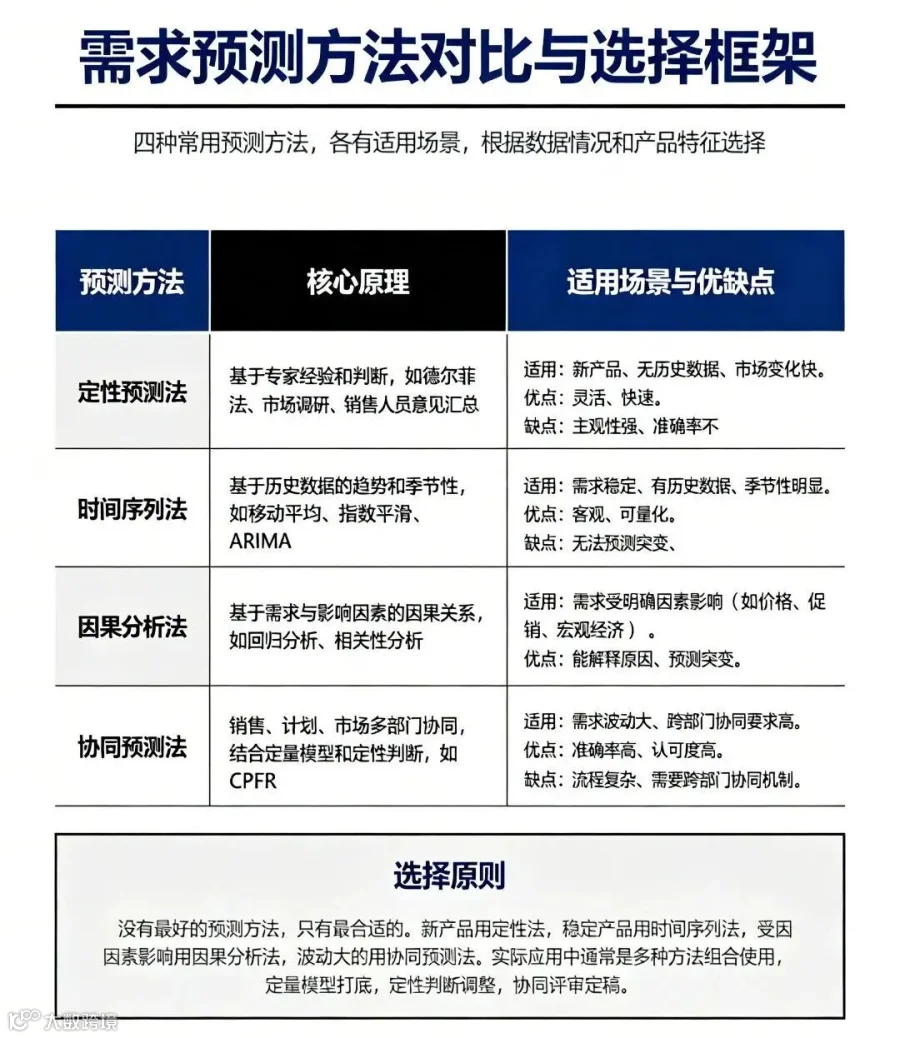
01 需求预测的四种常用方法
企业需根据产品特征与数据状况选择合适方法,实际应用中常组合使用:
- 定性预测法:适用于新产品或缺乏历史数据场景,依赖专家经验与市场判断。
- 时间序列法:基于历史销量数据(如移动平均、指数平滑),适用于需求稳定的成熟产品。
- 因果分析法:分析促销、价格、季节等外部因素对需求的影响,适用于受多因素驱动的产品。
- 协同预测法:整合销售、市场、生产等多部门信息,适用于波动大或高价值产品。
没有绝对最优的方法,只有最适配的策略。通常建议新产品用定性法,稳定品用时间序列,受环境影响大选因果法,波动剧烈品用协同法。
02 需求预测的标准流程:五步闭环
规范的流程是保障预测准确率的关键,形成从数据到优化的闭环管理:
第一步:数据收集与清洗
数据质量决定预测上限。需收集至少 2-3 年的历史销量、订单、库存、退货及市场促销数据。核心在于清洗:剔除异常大单与录入错误,补齐缺失值,并统一统计口径(如明确销量是按订单还是发货计算)。
第二步:模型选择与初步预测
实施分层预测策略。A 类重点产品(高销高利)采用 ARIMA、回归分析等复杂模型精细测算;B 类常规产品使用指数平滑等标准模型;C 类低值产品则用移动平均或去年同期值快速估算,避免资源浪费。
第三步:协同评审与调整
初步预测需经跨部门评审。销售结合客户反馈、市场结合促销计划、计划与生产结合产能约束进行调整。评审必须基于数据与事实,杜绝主观臆断,最终形成共识预测。
第四步:定稿发布与执行
共识预测正式发布后,作为生产排产、采购下单、物流规划及财务预算的唯一依据。各部门须严格执行,严禁随意变更,确保供应链动作一致。
第五步:跟踪复盘与持续优化
建立月度跟踪机制,计算预测准确率并深入分析偏差原因(数据、模型、市场或人为因素)。针对性改进后进入下一轮循环,通过持续复盘推动准确率稳步提升。
03 提升预测准确率的四个要点
要点一:夯实数据质量基础
遵循“垃圾进,垃圾出”原则。建立严格的数据管理制度,明确收集标准与清洗规则,定期检查数据完整性与一致性,确保输入模型的数据准确可靠。
要点二:实施滚动预测机制
摒弃一次性预测,改为每月滚动更新未来 3-6 个月的预测。这能及时响应市场变化,让产销计划更具前瞻性,减少突发冲击。
要点三:推行分层预测策略
按 ABC 分类法分配精力:A 类产品(前 20%)投入 80% 资源精细预测;B 类产品常规处理;C 类产品简化操作。以此实现资源效率最大化。
要点四:深化偏差分析改进
每月量化分析预测偏差,定位根本原因并制定改进措施,形成“分析 - 改进 - 验证”的闭环,确保持续进步。
04 落地中的常见问题与破解
问题一:销售部门隐瞒真实需求
痛点:销售因考核压力倾向于保守或虚报预测。
对策:建立共同 KPI 机制,将预测准确率纳入销售、计划、市场的共同考核;推行透明化评审,要求调整必须有据可依。
问题二:各部门需求口径不一致
痛点:销售、生产、财务对“需求”定义不同,导致沟通错位。
对策:在流程启动前统一口径,明确时间维度(周/月)、产品层级(SKU/族)及需求定义(订单/发货/含退货)。
问题三:预测与执行脱节
痛点:预测发布后,生产与采购仍按旧习惯行事。
对策:将预测执行率挂钩绩效考核;建立严格的预测变更审批流程,增加随意修改的成本。
问题四:预测价值难以量化
痛点:管理层看不到准确率提升带来的实际效益。
对策:建立价值量化模型,定期汇报库存资金占用降低额、缺货损失减少额及紧急采购成本节约额,用数据证明价值。

需求预测是一项持续循环的工程。通过五步闭环流程与四大关键要点的落实,企业可逐步摆脱经验依赖,实现供应链的精细化管理。
科学的预测管理不仅能降低库存成本、减少缺货风险,更是企业从粗放式增长转向高质量发展的必经之路。
