

在收听播客、英语听力材料或使用 AI 语音合成(TTS)生成旁白时,很多人都经历过一种微妙的不适感:
某些声音初听起来磁性厚实、低沉沉稳,但在手机外放、笔记本扬声器或通勤嘈杂的耳机里播放时,却总像“隔着一层厚厚的湿棉被”。你明明把音量开得很大,却依然觉得含混不清;调大音量不仅没能听清每个词的收尾,反而让耳朵被低频轰得发胀、疲惫不堪。
相比之下,另一些声音即使音量调得并不高,发音却像用刻刀雕出来一样干净利落,每个单词的爆破和齿音清脆分明,即便在地铁里也能轻松听清。
这并不是心理作用,更不是简单的“发音人声音好不好听”。在声学(Acoustics)、心理声学(Psychoacoustics)与发音生理学的交汇点上,声音的“响度”与“清晰度”存在着极其残酷的物理倒挂。
一、 声学的残酷倒挂:元音负责响度,辅音决定词义
很多人习惯性地认为:“听不清是因为声音不够大,调大音量就好了。”
但在言语声学中,响度与可懂度(Intelligibility)是由完全不同的频段和发音成分分别承担的。
1. 能量与信息的 90/10 悖论
人类的语言声音主要由元音(Vowels)与辅音(Consonants)交织而成:
元音(A, E, I, O, U 等):主要由声带振动发出基音,经咽腔、口腔等大共鸣腔放大,其主要能量集中在250 Hz – 1,000 Hz 的中低频。元音占据了人声80% 到 90% 的总声能。它是声音“音量大、持续久、听着厚实温暖”的根本来源。
辅音(尤其是 /t/, /d/, /s/, /k/, /p/, /f/, /θ/ 等爆破音与摩擦音):发音机制主要是气流通过齿唇、齿龈或舌面形成的狭窄缝隙发生摩擦或骤然爆破,其特征频率集中在2,000 Hz – 8,000 Hz 的中高频。辅音的声学能量极其微弱,在整个人声能量中占比通常不足 10%。
但信息论层面的现实是:这不足 10% 的微弱辅音,承担了 90% 以上的词义辨析信息。
我们可以做一个极端的声学实验:
如果用低通滤波器滤掉 1.5 kHz 以上的高频,只保留元音,你会听到一团洪亮宏大的“啊—咿—呜—诶—哦”,但你根本听不懂说话人在表达什么;
反过来,如果切掉 1 kHz 以下的全部低频,声音听起来会像薄纸或劣质收音机,毫无厚度,但你却能毫无障碍地听懂每一个字和词义。
2. 向上掩蔽效应(Upward Spread of Masking)
当一个声音具有过强的低频共鸣时,更致命的心理声学现象出现了——掩蔽效应。
在人耳内耳的耳蜗基底膜上,高频振动感知区靠近底部,低频振动感知区靠近顶部。声音进入耳蜗时,低频声波必须穿过高频感知区才能到达顶端。
因此,强烈的低频振动会极其容易向下游扩散,直接“向上”掩盖微弱的高频信号(即 Upward Spread of Masking);而微弱的高频辅音,在物理上几乎不可能掩盖低频。
如果一个发音人的基频偏低、胸腔共鸣过多(100 Hz – 300 Hz 严重淤积),每一次发元音时爆发出的低频能量波,就会像潮水一样把紧随其后的 /t/, /s/, /k/ 等微弱辅音瞬态强行淹没。
结果就是:听众只听到轰隆隆的声底,词尾的辅音全部被吃掉,大脑只能疯狂调动上下文去“猜词”。

语音清晰度的声学倒挂与听觉掩蔽机制
二、 人耳的进化偏见:2,000 Hz – 4,000 Hz 的临场甜区
声音清不清晰,不仅取决于发声体,还取决于人类听觉系统的解剖学构造。
1. 弗莱彻-芒森等响曲线(Fletcher-Munson Curves)
人类的耳朵并不是平直的工业级麦克风。根据心理声学著名的弗莱彻-芒森等响曲线(等响度轮廓线),人耳在不同频率下的灵敏度差异巨大:
在 100 Hz 的低频区,人耳需要高达 40~50 dB 的声压级才能感知到微弱的声音;但在2,000 Hz – 4,000 Hz频段,人耳的听阈极低,微弱的声压波动就能被清晰捕捉。
这是人类长期生物进化的产物:
远古时期草丛中捕食者逼近的枯枝断裂声;
幼童在危险时的啼哭与求救声;
面对面交流时最重要的齿唇爆破摩擦信号;
全部精准落在 2 kHz – 4 kHz 的频段范围内。在专业音频工程中,这个频段被称为“临场感频段”(Presence)。
2. 解码努力度(Listening Effort)与听觉疲劳
当一段语音在 2.5 kHz – 4.5 kHz 拥有充足且健康的泛音能量时,人脑的初级听觉皮层(Primary Auditory Cortex)能够以极低的能量消耗直接解码出音素(Phonemes)。这在主观感知上就是“声音清脆、透亮、有轮廓感”。
相反,如果该频段被低频掩盖,或者发音人本身高频泛音贫乏,大脑就必须调动前额叶的工作记忆(Working Memory)去频繁进行概率补全。
这种高强度的“听觉脑补”会在 15 到 30 分钟内迅速引发听觉疲劳(Listening Fatigue),让人产生烦躁、注意力涣散以及“听着真累”的排斥感。
三、 生理共鸣与发音位置:前置面罩 vs 低位胸腔
除了频段分布,声音的机械动态特征——发音位置与瞬态(Transients),也直接决定了清晰度的上限。
1. 后置胸腔共鸣:电台迷思与设备水土不服
很多发音人(包括早期的经典合成男中音模型,如en-US-ChristopherNeural)追求沉稳、磁性、有厚度的播音质感,发音位置靠后、喉头偏低,大量调动胸腔共鸣。
这种声线在专业录音棚的监听大音箱或开放式大耳机上播放时,显得温暖厚重。但一旦脱离理想声学环境,灾难就发生了:
手机与笔记本扬声器的物理局限:微型扬声器的振膜口径仅有几毫米到十几毫米,根本无法线性还原 150 Hz 以下的低频。强行驱动低频能量只会导致微型振膜发生剧烈的互调失真(Intermodulation Distortion),让整个人声在中频泥泞成一团。
瞬态拖尾过长:深层胸腔共鸣的声音衰减慢,低频余振长,前后两个音节容易粘连在一起。
2. 前置面罩共鸣:高穿透力与利落瞬态
与胸腔共鸣相对的是专业新闻主播、航空交通管制员(ATC)与高阶教学语音采用的发音方式——前置面罩共鸣(Mask Resonance)。
发音焦点集中在口腔前部的牙齿、齿龈和硬腭前端,声束向前聚焦推进:
瞬态起振快(Fast Attack):爆破音与摩擦音的起始极其陡峭,能量释放瞬间完成;
拖尾极其干净(Clean Release):音节之间存在微小的微停顿(Micro-pauses),不留拖泥带水的低频浑浊尾音;
言语传输指数(STI)极高:即使在信噪比很差的嘈杂环境中,齿唇音的边缘依然像刀锋一样锐利。
四、 什么样的声音在人耳中清晰度最高?
结合声学、听觉等响与生理共鸣的规律,在语言学习、有声书阅读及 AI 旁白生成中,以下三类声音在客观辨识度与主观清晰度上表现最为突出:
1. 清脆透亮的女声(Soprano / Mezzo-soprano,基频 200–260 Hz)
声学优势:女性的基础音高比男性高出约一个八度。这意味着女声的各阶泛音从源头上避开了容易淤积泥泞的 100~250 Hz 低频区,主要谐波直接落入人耳最敏感的 1 kHz – 4 kHz 黄金甜区。
代表选型:微软经典模型en-US-JennyNeural。这是目前在全球在线教育、语言评测与教学跟读中使用最广泛的语音之一。其音色透亮,齿音与爆破音颗粒度极高,无任何多余的胸腔轰鸣,长时间佩戴耳机收听也不易疲劳。
2. 清爽播音腔男声(Tenor,基频 130–160 Hz,无过度胸音)
声学优势:音阶偏男高音或自然中音,发音位置明显靠前,声线平直干净。它舍弃了传统夜间电台主持人的沉重胸腔气声,换取了极快的辅音瞬态响应。
代表选型:微软经典模型en-US-GuyNeural。相比 Christopher 的厚重压迫感,Guy 的声线干净干脆,极具现代科技演讲者和专业产品布道师的从容感,在手机外放设备上的可懂度远超传统沉厚男声。
3. 英式标准发音(Received Pronunciation, RP)
声学优势:英音在发音生理学上口型纵向张开度显著大于美音,舌位靠前,齿龈爆破(如 /t/, /d/)和齿龈摩擦(如 /s/, /z/)的力量给得非常充沛。更重要的是,标准英音没有美式强烈的儿化卷舌(Rhotacization),不会因舌根后缩堵塞咽腔而产生共鸣浑浊,因此在声学测量中具有极高的客观清晰度。
代表选型:en-GB-SoniaNeural或en-GB-RyanNeural。
五、 工程实操调优:从 TTS 选型到 4 步 EQ 信号链
如果你手头已经有一批听起来偏闷、低沉含混的语音音频(无论是录音还是 TTS 合成音频),可以通过以下两个层级进行系统化改善:
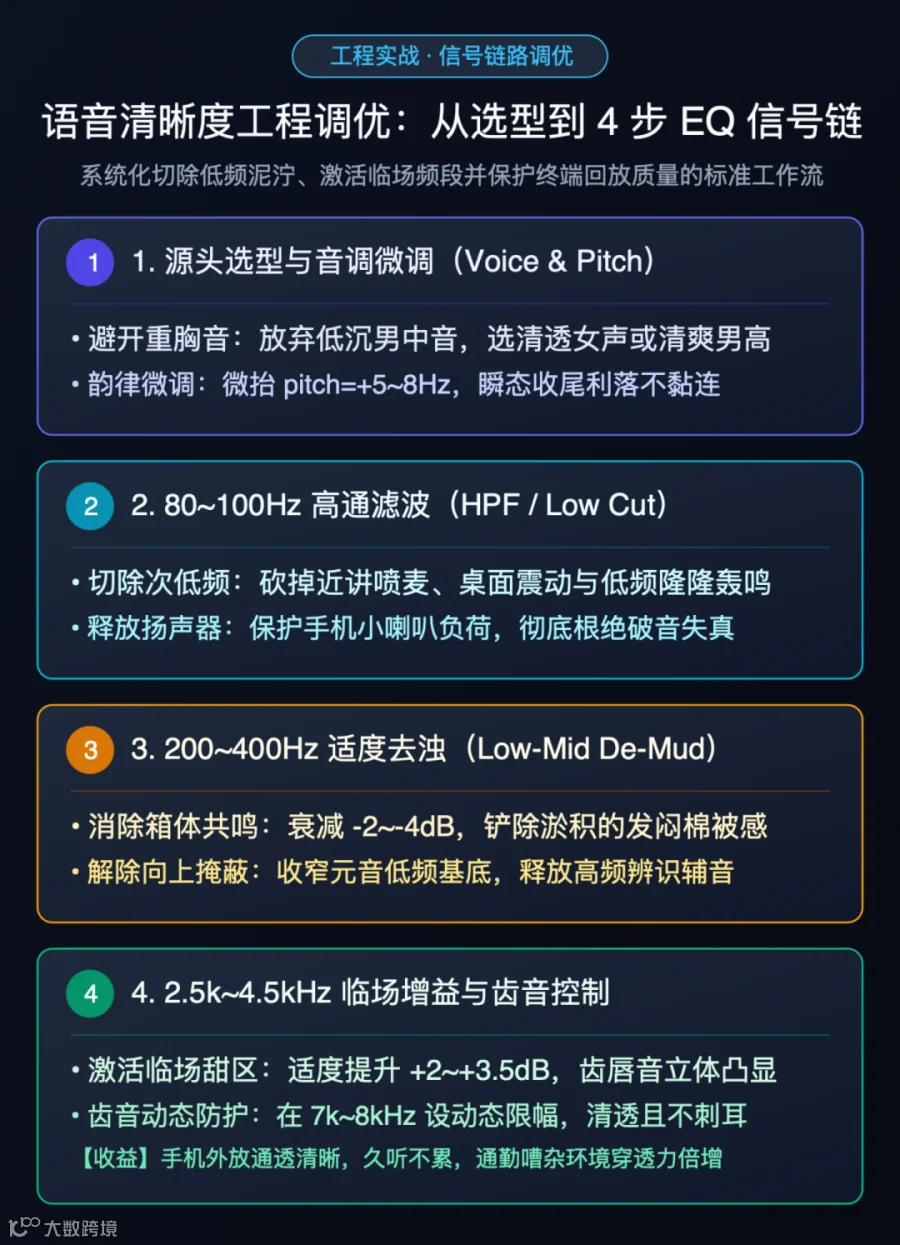
语音清晰度工程调优:从选型到 4 步 EQ 信号链
方案 A:TTS 源头调优(无损重构)
如果是通过 API 或脚本生成语音,优先从合成源头调整:
直接切换声线:优先将低频共鸣偏重的模型(如 Christopher)替换为清脆女声(Jenny)或清爽男声(Guy / Ryan)。
微调基频(Pitch):在 SSML 或 API 参数中,将音调微抬pitch="+5Hz"到+8Hz"(或+3%~+5%)。这能轻微拉升基频,使泛音分布整体向人耳敏感区平移,消除收尾拖沓感。
适度控制语速:不要盲目加速,保持正常语速或在rate="0.95"~rate="1.05"之间微调,确保音节之间的微停顿不被算法压缩吞噬。
方案 B:音频后处理 4 步 EQ 滤波链
如果需要修复已有 MP3 录音文件,可以在数字音频工作站(DAW)、Audacity 或直接使用 FFmpeg 进行标准化的 4 步滤波处理:
步骤 1:80 Hz – 100 Hz 高通滤波(HPF / Low Cut)
目标:彻底切除 80 Hz 以下的人耳非感知次低频。
作用:人声在 80 Hz 以下几乎没有有用的基频信息,多是手持麦克风撞击声、喷麦气流、桌面低频共振或电网交流声。砍掉这部分能量,能够极大地释放手机扬声器的功放负荷,防止微型扬声器过载失真。
步骤 2:200 Hz – 400 Hz 适度去浊(Low-Mid De-Mud)
目标:在 250 Hz – 350 Hz 频段设置一个宽 Q 值(Q ≈ 1.2)的陷波,衰减-2.5 dB 到 -4 dB。
作用:这里是产生“隔着棉被感”与“箱体共鸣”的核心重灾区。适度衰减这个频段,能够瞬间打破“向上掩蔽效应”,让憋闷在底层的辅音浮出水面。
步骤 3:2.5 kHz – 4.5 kHz 临场增益(Presence Boost)
目标:在 3 kHz – 3.5 kHz 附近设置宽频带钟形提升(Bell Filter),增益+2.0 dB 到 +3.5 dB。
作用:精准点亮人耳弗莱彻-芒森曲线的最敏感甜区。辅音爆破与齿唇摩擦的立体感会瞬间凸显,人声的穿透力成倍提升。
步骤 4:7 kHz – 8 kHz 齿音动态平滑(De-Esser)
目标:在 7 kHz 附近设置轻量动态压限。
作用:防止在提升临场感后,/s/, /sh/ 等摩擦音在劣质耳机中变得过于尖锐刺耳,确保既透亮又耐听。
如果你有现成的发闷音频文件input.mp3,可以直接在终端使用 FFmpeg 的内置音频滤镜链一步完成上述优化:
ffmpeg -i input.mp3 -af "highpass=f=90,equalizer=f=300:t=q:w=1.2:g=-3,equalizer=f=3200:t=q:w=1.0:g=2.5" -b:a 192k output_clear.mp3
highpass=f=90:90 Hz 高通切除低频隆隆底噪;
equalizer=f=300:t=q:w=1.2:g=-3:在 300 Hz 去除 3 dB 箱体泥泞共鸣;
equalizer=f=3200:t=q:w=1.0:g=2.5:在 3.2 kHz 注入 2.5 dB 临场高频清晰度。
处理后的音频在手机扬声器外放时,发闷含混的感觉会一扫而空,字句轮廓清晰可辨。
结语:清晰是精密的物理学,不是偶然的感觉
声音的“厚重”常常被误认为是一种高级感,但在信息传播和听力接收的真实场景里,无法辨析的高厚度往往是一剂让听众迅速疲劳的毒药。
从声学能量的 90/10 倒挂,到耳蜗内壁的向上掩蔽效应;从人类进化赋予我们的 2k–4kHz 等响甜区,到面罩发音干净利落的瞬态释放——决定声音是否“清晰”的,从来不是主观玄学,而是一套严密而确定的声学与生理学规律。
无论是设计语音交互系统的产品架构师、调试 AI 配音的内容创作者,还是希望提升磨耳朵效率的语言学习者,理解了这套清晰度底层密码,你就能在每一次声音传递中,让信息以最低的认知负荷,精准直达听众的大脑。