




SAP ABAP
性能优化
5 个老代码性能改造


月初结账,财务催报表催到群里 @ 你。你打开事务码一看,那段十年前前辈写的程序,跑一次 40 分钟,数据量一大直接 TIME_OUT 挂掉。
你重写了一遍,4 秒。
不是你多牛,是老代码里踩了 5 个 ABAP 性能的经典坑——而这些问题,现在还在大量项目里天天发生。今天我把改造过程拆给你看,每一段都附前后对比代码,明天上班就能对照自查。
· 嵌套循环 + READ TABLE
不带 BINARY SEARCH ·
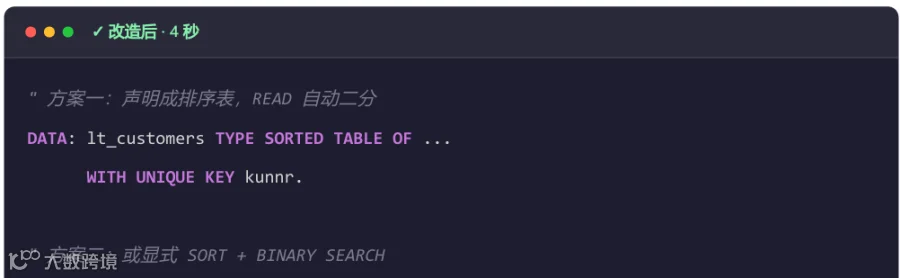
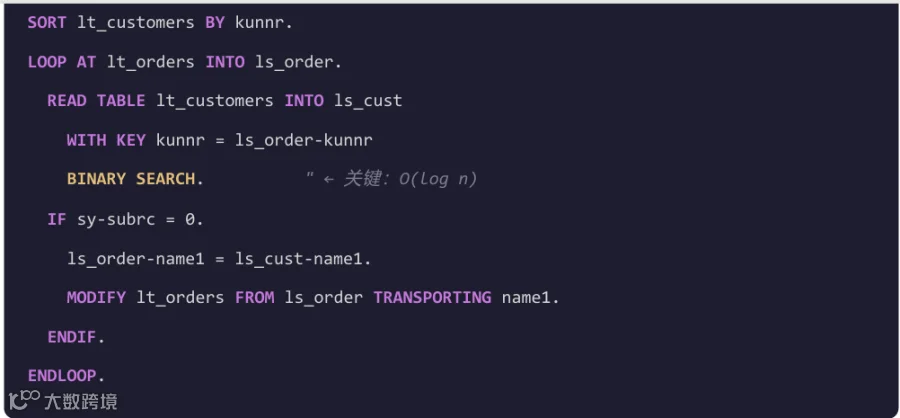
这是老 ABAP 里出现频率最高的性能杀手。两张内表嵌套 LOOP,内层查找还不带二分,复杂度直接 O(n²)。
改造前跑40分钟

改造后4秒
💡反常识点
很多人以为 READ TABLE ... WITH KEY 默认就是快的。错——标准表上它是 线性扫描 , 10000 条就扫 10000 次。加一个 BINARY SEARCH ,同样的代码快几百倍。
· SELECT * 逐行取数
循环里查数据库 ·
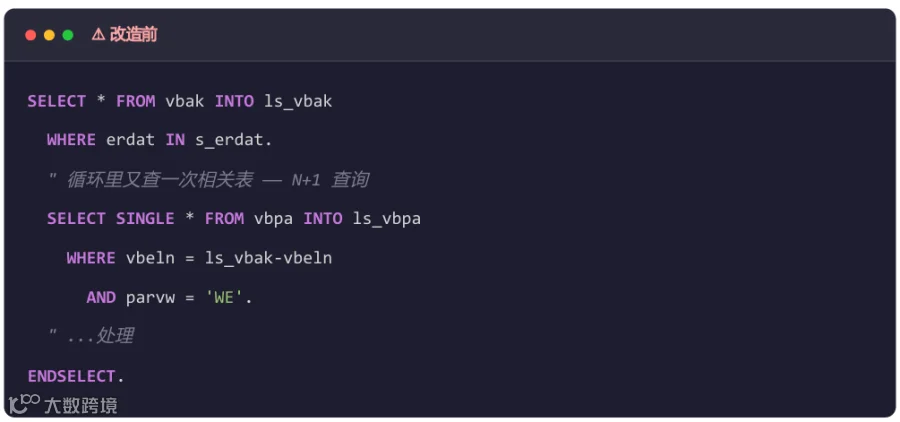
老代码最爱干的事: SELECT * ... ENDSELECT 在循环里一行行查,等于把 N 次网络往返塞进程序。
改造前
改造后
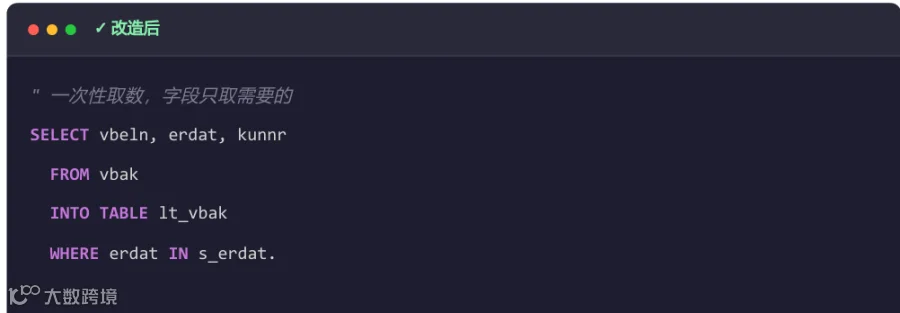

记住一句话:循环里出现 SELECT SINGLE ,基本就是要重构的信号。能 JOIN 的 JOIN,不能JOIN 的用 FOR ALL ENTRIES 一次性取出来再内存里关联。
·FOR ALL ENTRIES 的三个暗坑 ·
FOR ALL ENTRIES 用得好是利器,用不好比嵌套循环还慢。三个坑你必须知道:
坑 1 :驱动表为空 = 全表扫描
改造前

改造后

坑 2 :驱动表有重复值 → 结果重复
FOR ALL ENTRIES 不会自动去重驱动表,重复的 vbeln 会让结果集也重复。改造前先 SORT... DELETE ADJACENT DUPLICATES 。
坑 3 :数据量太大 → 自动分批,慢
驱动表几千条以内没问题,几万条时数据库会自动拆成多个 IN 查询,反而比 JOIN 慢。这种情况直接改 INNER JOIN 。
· 内表用标准表 + LOOP AT ... WHERE,没排序 ·
这是老 ABAP 里出现频率最高的性能杀手。两张内表嵌套 LOOP,内层查找还不带二分,复杂度直接 O(n²)。
改造前
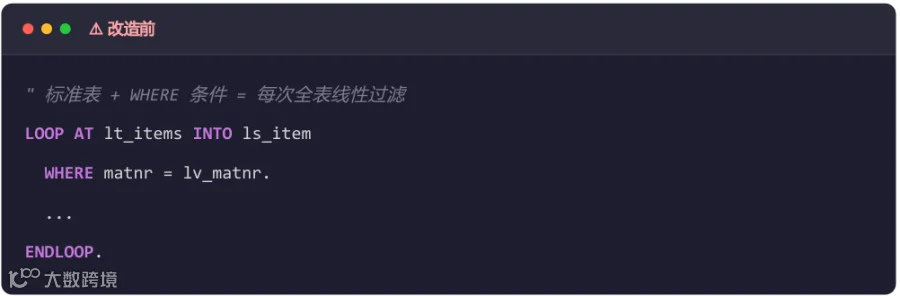
数据量一大,这个 LOOP 本身就是性能瓶颈。
改造后
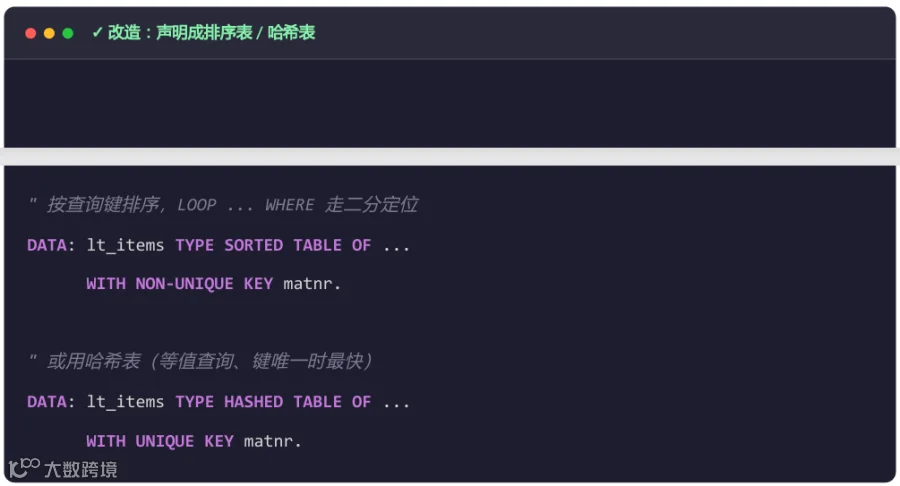
💡经验法则
等值查询 + 键唯一 → HASHED TABLE;范围查询或键不唯一 → SORTED TABLE;只是顺序遍历→ 标准表够用。选错表类型,后面所有优化都白做。
· 老 ALV 报表整体重构为
CDS + Fiori Elements ·
前面 4 个是「点」的优化,这个是「面」的改造。很多十年前的 ALV 报表,逻辑全写在 ABAP里:取数、关联、计算、汇总全靠内表。这种程序优化到极限也就那样——真正的改造是把它下沉到数据库层。
改造思路:
把取数+关联+计算逻辑写成 CDS 视图(带 annotation)
暴露成 OData 服务(RAP 或 SEGW)
前端用 Fiori Elements 自动生成列表/详情页
ABAP 只剩权限检查和少量增强逻辑
好处:
数据库层做 JOIN/聚合,比 ABAP 内表快一个数量级
前端自带分页、排序、过滤、导出,不用自己写 ALV
后续 S/4HANA 升级、HANA 优化器自动受益
符合 Clean Core 方向,老式 user exit 越少越好
这不是一篇文章能讲完的,但方向值得记下来:你手里那些又长又慢的老 ALV,终极归宿是CDS + Fiori Elements,不是打补丁。
改造前后对比一览
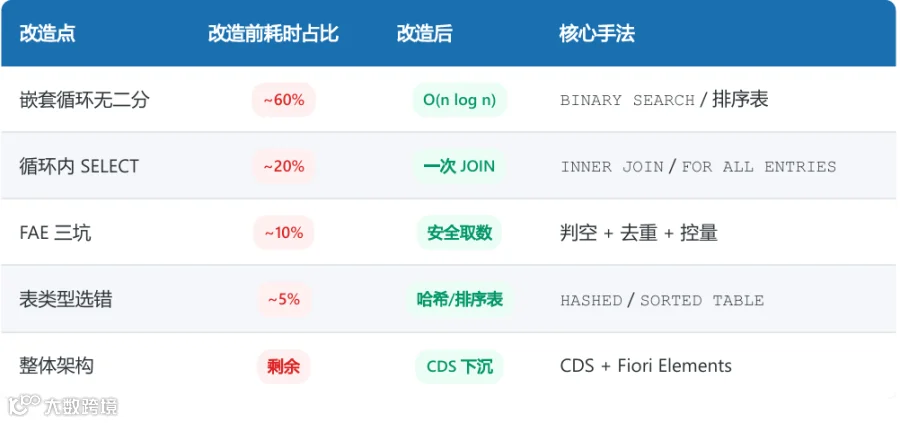

老代码性能问题,90% 不是算法多高深,而是写的人不知道这些写法的代价。上面 5 个坑,你打开任何一个上了年纪的 SAP 项目,大概率能找到 3 个以上。下次有人跟你说「ABAP 性能就这样,慢是正常的」——把这篇文章甩给他
收藏关注 获取更多知识